
质量与可靠性 / 系统课时
敏感性分析如何定位关键假设
敏感性分析如何定位关键假设
一份可靠度预测报告给出 0.86,并不意味着结果足够稳健。本课以控制器和双模块冗余系统为例,分别改变失效率、Weibull 形状参数及系统结构假设,计算可靠度变化,识别影响结论的关键因素,并把数据不足与模型假设风险分开处理。
学习目标
- 建立固定任务时点的系统可靠度基线,明确参数与结构假设。
- 使用单因素扰动计算可靠度变化幅度,识别高敏感因素。
- 区分参数估计不确定性和模型假设风险,形成可追溯的验证结论。
固定任务条件与基线模型
敏感性分析必须先固定评价对象、任务时间和成功判据,否则不同方案的结果无法直接比较。
假设一套设备包含控制器 S 和两台功能相同的执行模块 B1、B2。控制器必须正常工作,执行模块只需任意一台正常即可完成任务。基线模型假设 B1、B2 的失效相互独立。
采用以下演示参数:
| 项目 | 参数 | 取值 |
|---|---|---|
| 任务时间 | 1000 小时 | |
| 控制器 S | 恒定失效率 | |
| 执行模块 B | Weibull 形状参数 | 2.0 |
| 执行模块 B | Weibull 尺度参数 | 2000 小时 |
| 模块依赖关系 | 基线 | B1、B2 独立失效 |
控制器采用指数可靠度模型,执行模块采用双参数 Weibull 可靠度模型:
独立双模块并联的可靠度为 ,再与控制器串联,得到:
在 1000 小时处,、,双模块并联可靠度约为 0.951071,系统基线可靠度为 0.860565。
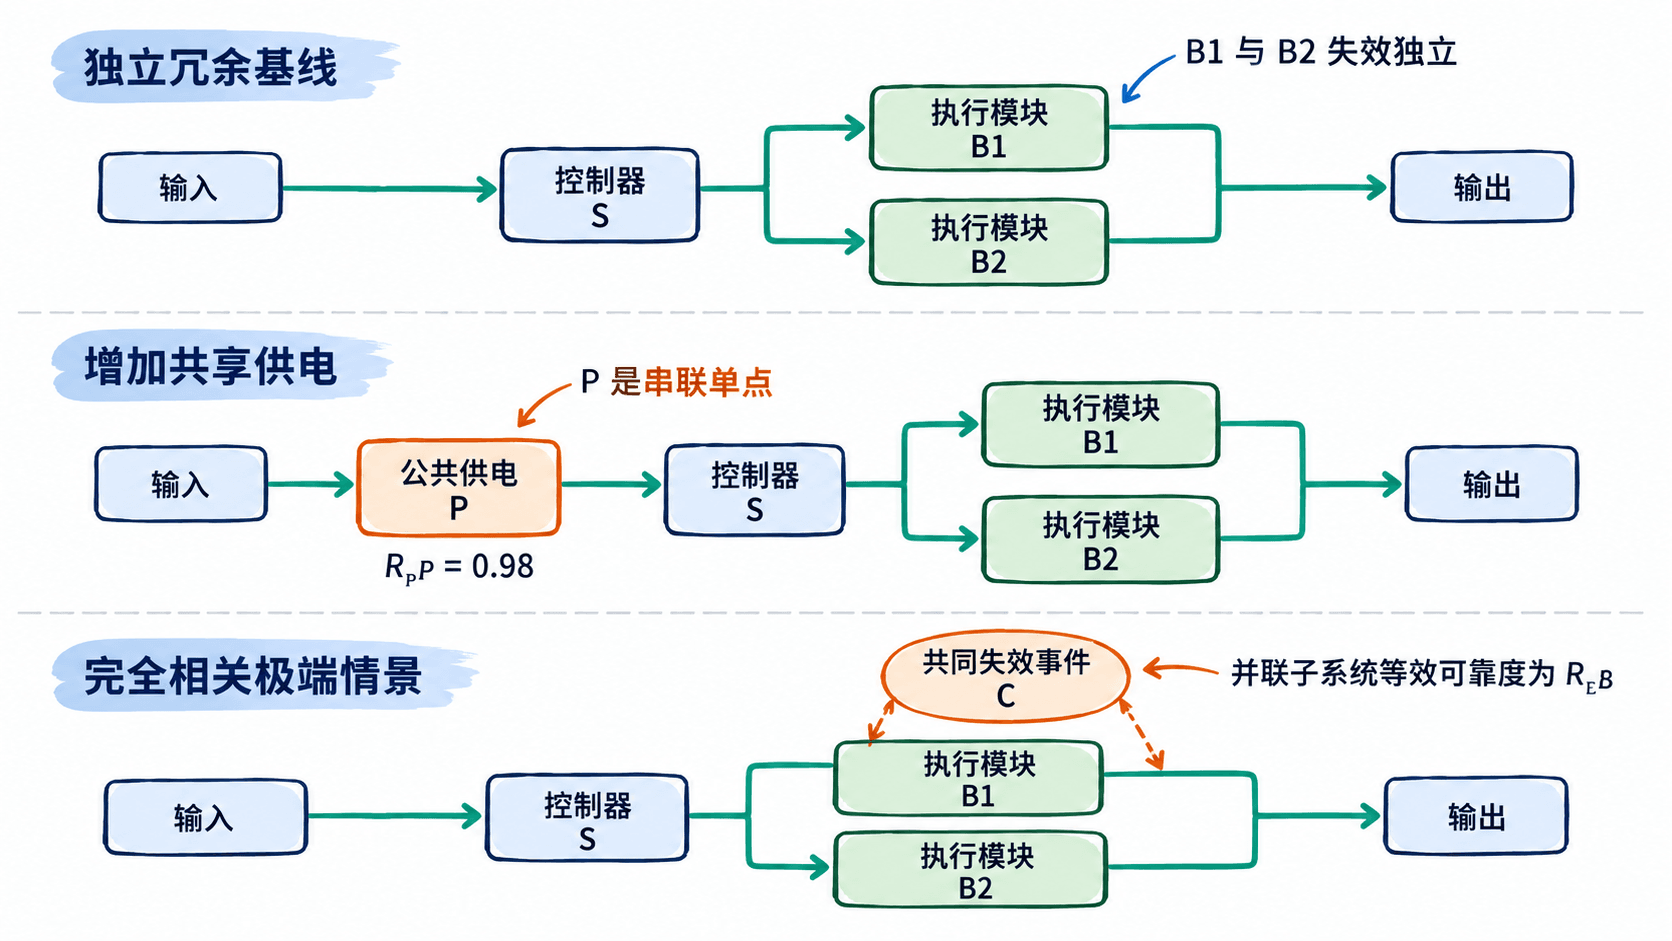
实际工程中,还需要核实是否存在未建模的共享供电单元,以及两台执行模块是否可能因相同原因同时失效。以下结构图将这些假设分别表示,避免把功能冗余直接等同于失效独立。
用单因素扰动计算变化幅度
单因素敏感性分析(One-at-a-Time,OAT)每次只改变一个输入,其余条件保持不变。对于数值参数,先采用上下 20% 的扰动进行筛查;对于结构和依赖假设,则直接比较不同情景的系统可靠度。
本例分别测试控制器失效率与 Weibull 形状参数的正负 20% 扰动,并额外设置两个结构情景:增加可靠度为 0.98 的共享供电单元,以及两台执行模块完全相关失效的极端情况。每个情景都单独与基线比较,不同时叠加。
以下程序使用 Python 3.8 及以上版本和标准库,可以保存为 sensitivity.py 后运行:
import math

T, ETA = 1000, 2000
LAMBDA_S, BETA_B = 1e-4, 2.0

def system_reliability(lam=LAMBDA_S, beta=BETA_B,
                       shared_power=1.0, fully_linked=False):
    r_s = math.exp(-lam * T)  # 控制器按常失效率建模
    r_b = math.exp(-((T / ETA) ** beta))  # 两台模块的边际可靠度
    # 完全相关情景下,双模块不再提供独立冗余收益
    r_pair = r_b if fully_linked else 1 - (1 - r_b) ** 2
    return shared_power * r_s * r_pair

baseline = system_reliability()
scenarios = [
    ("失效率 -20%", system_reliability(lam=LAMBDA_S * 0.8)),
    ("失效率 +20%", system_reliability(lam=LAMBDA_S * 1.2)),
    ("形状参数 -20%", system_reliability(beta=BETA_B * 0.8)),
    ("形状参数 +20%", system_reliability(beta=BETA_B * 1.2)),
    ("增加共享供电 R=0.98", system_reliability(shared_power=0.98)),
    ("两模块完全相关", system_reliability(fully_linked=True)),
]

print(f"基线: {baseline:.6f}")
for label, value in scenarios:
    print(f"{label}: {value:.6f} ({(value - baseline) * 100:+.2f} 个百分点)")
预期输出:
基线: 0.860565
失效率 -20%: 0.877949 (+1.74 个百分点)
失效率 +20%: 0.843524 (-1.70 个百分点)
形状参数 -20%: 0.833397 (-2.72 个百分点)
形状参数 +20%: 0.877882 (+1.73 个百分点)
增加共享供电 R=0.98: 0.843353 (-1.72 个百分点)
两模块完全相关: 0.704688 (-15.59 个百分点)
这里的变化量采用可靠度的绝对差,并乘以 100 转换为百分点。例如从 0.860565 下降至 0.833397,是下降约 2.72 个百分点,而不是下降 2.72%。
从变化幅度识别关键因素
同样是上下 20% 的扰动,两个数值参数对结果的影响并不相同:
| 敏感因素 | 最大绝对变化 | 本例中的含义 |
|---|---|---|
| 控制器失效率 | 1.74 个百分点 | 控制器失效率估计会影响任务可靠度 |
| Weibull 形状参数 | 2.72 个百分点 | 执行模块的寿命趋势需要进一步核实 |
| 增加共享供电单元 | 1.72 个百分点 | 原模型可能遗漏公共串联环节 |
| 两模块完全相关 | 15.59 个百分点 | 独立性假设一旦失效,冗余收益可能大幅降低 |
按照当前测试范围,完全相关情景造成的变化最大,其次是 Weibull 形状参数。但这不意味着完全相关失效最有可能发生,也不意味着形状参数的真实估计误差一定达到 20%。
特别要注意 Weibull 形状参数的时间依赖性。本例在 小时、 小时处,提高 会提高可靠度;当评价时点超过尺度参数 时,提高 对同一 Weibull 模型可靠度的影响方向会反转。因此不能把某个时点的敏感性结论直接推广到全部寿命区间。
单因素分析也无法揭示多项假设同时变化产生的交互效应。完成初步筛查后,可以针对高敏感因素建立双因素网格,例如同时考察 在基线的 0.8 至 1.2 倍之间变化、 在 1.6 至 2.4 之间变化的组合,再计算最不利情景。
区分数据不确定性与模型假设风险
数据不确定性是参数需要从有限样本中估计,而样本不足或观测不完整导致估计结果存在误差。
例如,控制器累计运行 20000 台小时,仅记录到 2 次失效,在假设恒定失效率及独立失效计数的前提下,点估计为 。由于失效数只有 2 次,应进一步基于泊松计数模型计算失效率置信区间,而不能把该点估计当作精确常数。
如果执行模块有 6 条失效记录和 24 条右删失记录,应通过包含删失贡献的极大似然方法同时估计 Weibull 形状参数与尺度参数,并计算参数区间。不能把右删失时间当成真实失效寿命,也不能默认 与 的估计误差相互独立。
模型假设风险是系统的数学描述可能与真实结构或失效机制不一致,增加同类型样本也不一定能解决。
例如,两台执行模块虽然功能并联,但如果共享同一路供电,公共供电故障就可能使两台模块同时停止工作。此时必须根据实际供电架构修订可靠性框图,并依据供电单元数据估算相应可靠度。
如果怀疑温度冲击、控制指令错误等共同原因会同时影响两台模块,则应分析共同失效事件与依赖关系。程序中的完全相关情景只是压力测试边界,不是从数据得到的共同原因失效概率,更不能未经校准就将其作为正式预测值。
把敏感性结果写成可追溯结论
假设项目要求设备在 1000 小时时的任务可靠度不低于 0.85。基线预测为 0.860565,虽然满足要求,但仅高出约 1.06 个百分点。
控制器失效率增加 20% 时,可靠度降至 0.843524;Weibull 形状参数降低 20% 时,降至 0.833397;增加可靠度为 0.98 的公共供电单元后,降至 0.843353。这些情景都未达到 0.85。完全相关的极端情景则降至 0.704688。
由此可以形成以下具体核验任务:
- 核对物理结构:检查电气原理图和现场接线,确认是否存在未纳入模型的公共供电、控制或保护单元。
- 补足失效证据:整理控制器累计运行台小时、失效次数、观察起止时间及故障判定规则,计算失效率区间。
- 重新拟合寿命模型:保留执行模块的失效与右删失标记,联合估计 Weibull 参数,并将参数估计区间传播到系统可靠度。
- 复核依赖关系:结合故障树、失效分析报告和维修记录识别共同原因事件,决定是否需要建立经过数据校准的共因失效模型。
- 重新执行验收计算:保存任务时点、需求阈值、模型版本、原始数据版本、参数估计方法、扰动范围、计算脚本及结果,确保其他工程师能够复算。
最终报告应分别写明基线估计、参数估计区间下的可靠度范围,以及尚未证实的结构情景。对于本例,基线满足 0.85 只能作为有条件的初步结论;在补充参数区间与系统结构证据之前,不能据此认定可靠性目标已经获得充分验证。