
质量与可靠性 / 系统课时
指数分布何时适合描述失效过程
指数分布何时适合描述失效过程
同样运行 500 小时,只有当失效率随服役时间近似不变时,才能用指数分布直接计算任务可靠度。本文从条件失效率推导可靠度公式,完成带数字的寿命计算,并通过磨损模型与实际观测数据判断指数分布的适用边界。
学习目标
- 理解恒定失效率假设,推导指数分布的可靠度、累计失效概率和平均寿命。
- 根据给定失效率计算任务可靠度与满足目标可靠度的最长任务时间。
- 识别磨损导致的失效率上升,判断何时应改用其他寿命模型。
从条件失效率推导可靠度
设随机变量 表示设备从任务起点到首次失效的时间。可靠度 表示设备在 时刻仍未失效的概率。条件失效率 描述设备已经存活到 时,接下来极短时间内发生失效的条件速率。
其数学定义为:
由于寿命概率密度 ,失效率与可靠度满足:
指数寿命模型假设研究时段内的失效率为常数,即 。代入上式,并使用初始条件 ,得到微分方程:
两边积分即可得到指数可靠度函数:
相应的累计失效概率、寿命概率密度和平均首次失效时间分别为:
若时间单位为小时, 的单位就是 ,而 与 都是没有单位的概率。使用公式前必须统一时间单位,例如不能把以小时为单位的失效率直接乘以分钟数。
这里讨论的是首次失效寿命。设备维修后再次运行形成的多次故障记录,不能不加区分地当作相互独立的首次失效寿命样本。
计算500小时任务的可靠度
假设一批设备在稳定运行阶段的条件失效率为 ,现在要求连续执行 500 小时任务且期间不能发生首次失效。
将参数代入指数模型:
因此,设备完成整个任务且不发生首次失效的概率约为 90.48%,任务内至少发生一次失效的概率为:
如果任务要求可靠度至少为 90%,则可以反求允许的最长任务时间:
下面使用 Python 标准库复核计算,不需要安装第三方依赖。
import math

# 失效率单位为每小时,假设整个任务期间保持恒定
hazard = 2e-4
mission_hours = 500

reliability = math.exp(-hazard * mission_hours)
failure_probability = 1 - reliability

# 反求可靠度不低于 90% 时的任务时长上限
limit_hours = -math.log(0.90) / hazard

print(f"500 h 可靠度: {reliability:.4f}")
print(f"500 h 累计失效概率: {failure_probability:.2%}")
print(f"90% 可靠度任务上限: {limit_hours:.1f} h")
预期输出:
500 h 可靠度: 0.9048
500 h 累计失效概率: 9.52%
90% 可靠度任务上限: 526.8 h
该模型的平均首次失效时间为 。但这不表示设备可以保证运行 5000 小时。实际上,在指数模型下运行到平均寿命对应时刻的可靠度只有 。
恒定失效率究竟意味着什么
指数分布具有无记忆性。对于已经正常运行到 时刻的设备,只要它仍未失效,再运行 小时的条件存活概率就与此前运行了多久无关:
例如,无论设备此前已正常运行 100 小时还是 2000 小时,只要仍处于同一恒定失效率阶段,其未来 100 小时内的条件可靠度都是 。
这并不意味着每个小时都有完全相同的无条件失效概率。以任意已经存活到当前时刻的设备为前提,未来一小时内失效的条件概率为:
对于很小的 ,可以使用 近似计算短时间条件失效概率,但不能把具有时间倒数单位的失效率直接当成概率。
磨损主导时为什么不能使用恒定失效率
轴承磨损、材料疲劳、腐蚀和绝缘老化等机制可能使设备的短期失效风险随服役年龄增加。如果仍采用恒定失效率,就可能明显高估后期任务可靠度。
此时可以考虑 Weibull 寿命模型。其可靠度和条件失效率为:
其中 为尺度参数, 为形状参数。当 时,Weibull 分布退化为指数分布;当 时,失效率随时间上升,适合描述某些磨损主导的寿命过程。
例如令 、。设备在 5000 小时的条件失效率为 ,已经达到同尺度指数模型恒定失效率 的两倍。
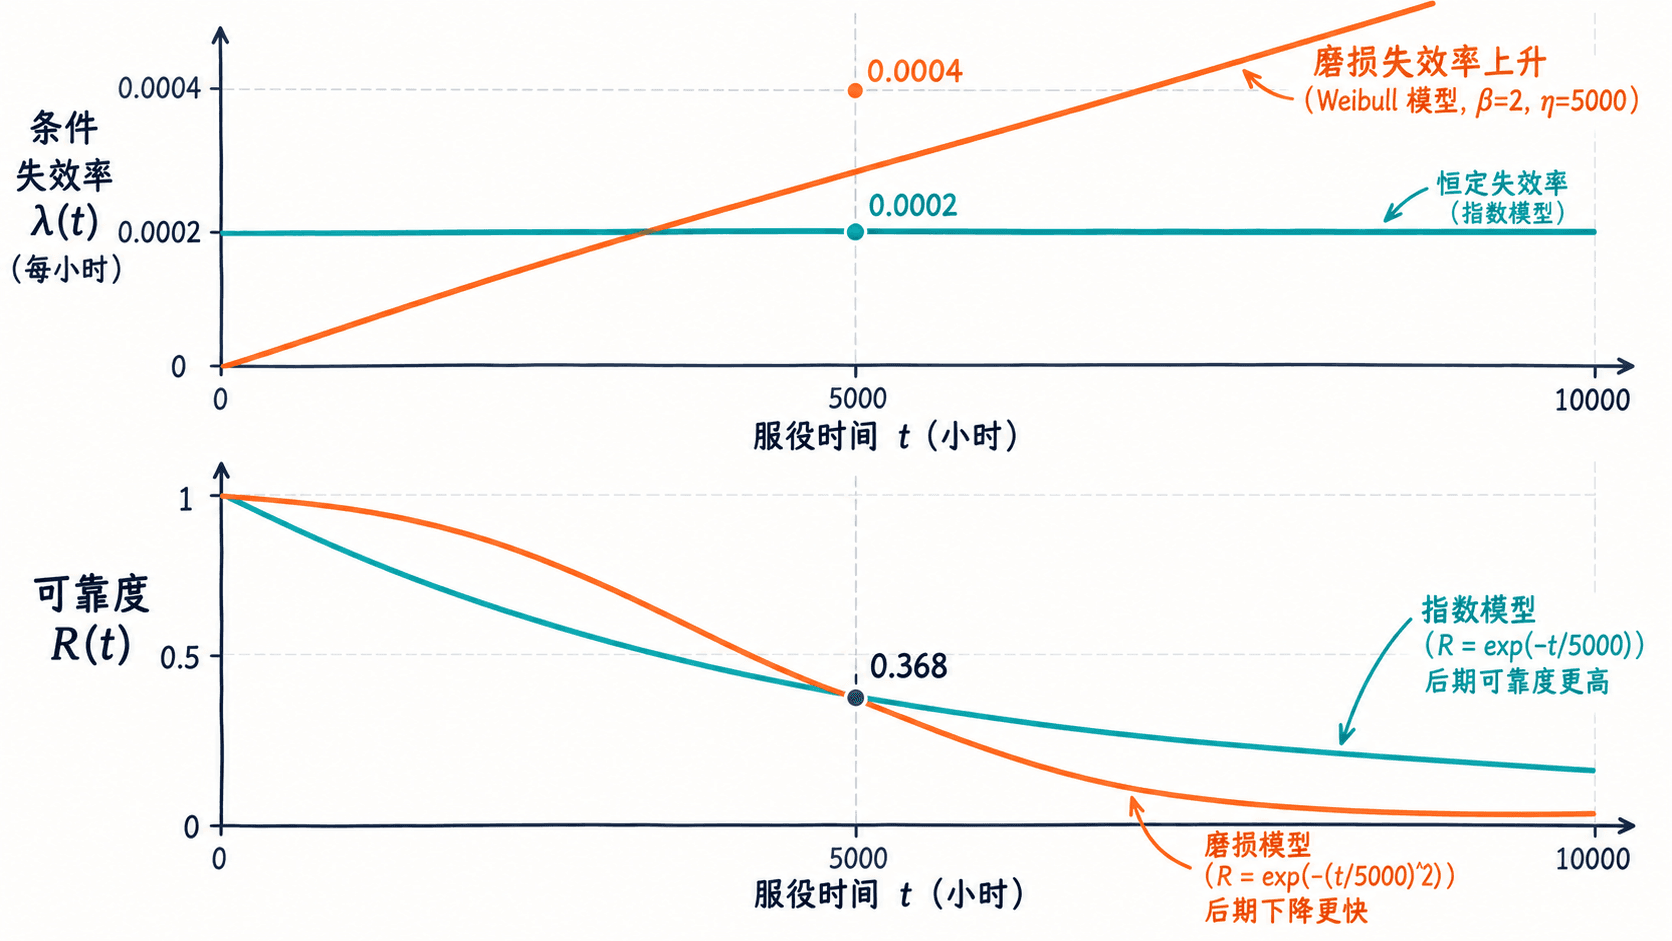
观察下图可见,两种模型在 5000 小时的可靠度相同,但并不代表整个寿命过程等价。在 10000 小时时,指数模型预测可靠度约为 13.53%,而上述 Weibull 模型只有约 1.83%。如果磨损行为确实符合后者,继续使用指数模型就会低估长期失效风险。
用寿命观测数据检查指数假设
工程中不能仅凭模型计算方便就选择指数分布。首先应统一失效判据与寿命起点,对每台设备记录从开始观察到首次失效或观察结束的时间,并区分真实失效与右删失记录。正常完成观察但尚未失效的设备不能记作失效。
在独立、同分布的指数首次失效模型下,如果观测到 次首次失效,全部设备累计贡献的有效观察时间为 ,则恒定失效率的极大似然估计为:
例如 20 台同型号设备累计贡献 40000 设备小时,其中 8 台发生首次失效,其余设备右删失,则估计值为 。注意,这只是模型参数的估计值,并不能证明失效率确实恒定。
实际检查时,可以按以下顺序执行:
- 按设备服役年龄划分早期、中期和后期区间,比较各区间的失效次数及对应风险暴露时间,注意右删失和样本数量变化。
- 使用 Kaplan–Meier 方法绘制首次失效寿命的经验可靠度曲线,与指数模型 进行比较。
- 观察后期经验可靠度是否持续比指数预测下降更快,并结合失效分析报告检查是否出现疲劳、磨损或腐蚀等机制。
- 如果失效率明显随年龄变化,应考虑 Weibull 模型、分阶段寿命模型或按工作负荷分层,而不是继续使用统一的恒定失效率。
指数模型适合在明确的稳定失效阶段内快速计算任务可靠度。计算前需要确认任务时间单位、首次失效定义和模型适用区间;一旦观测到随服役年龄持续上升的失效风险,就应重新选择寿命分布并验证预测结果。