
质量与可靠性 / 系统课时
多批次寿命数据什么时候能合并
多批次寿命数据什么时候能合并
把不同供应商、生产日期或运行应力下的寿命记录直接拼接,可能把多个失效总体误判成一个 Weibull 分布。本篇用分层曲线、右删失似然和工程容差判断能否共用参数,并通过数值复核混合造成的偏差。
学习目标
- 整理可跨批次比较的寿命和右删失数据。
- 识别混合总体对可靠度、Weibull 参数及 B10 寿命的影响。
- 根据分层拟合、统计检验和工程容差选择合并、调整或分组建模。
先统一样本的比较口径
为每台设备至少保留 unit_id、供应商、生产批次与日期、应力条件、观测时长 t_h、事件指示 event(失效为 1,右删失为 0)和删失原因。时间原点必须一致,例如均从完成预热、开始额定运行时算起;失效判据也应相同,例如输出流量持续低于额定值的 80%。
例如 A01 在 430 小时失效,记录为 t_h=430, event=1;B01 正常运行 600 小时后试验截止,记录为 t_h=600, event=0,不能当作“寿命等于 600 小时”。供应商 A 若在 25°C 测试、B 在 55°C 测试,或后生产批次因观察期短而更多地被删失,都不能仅按失效比例比较。还要核对停测是否与设备劣化相关;与失效风险有关的退出不宜直接按独立右删失处理。
先分层看曲线再谈合并
以相同额定应力下的两批器件为例,假设两批都服从形状参数 的 Weibull 分布,但尺度参数分别为 小时、 小时。各批可靠度为 。在 600 小时,A 批可靠度约 0.368,B 批约 0.779,不能视为同一寿命水平。
如果目标设备群由两批各占 50%,且各批占比固定,那么总体可靠度是 ,在 600 小时约为 0.573。这是用于描述特定批次组成的混合可靠度,不是证明两批可以共用一组 Weibull 参数。
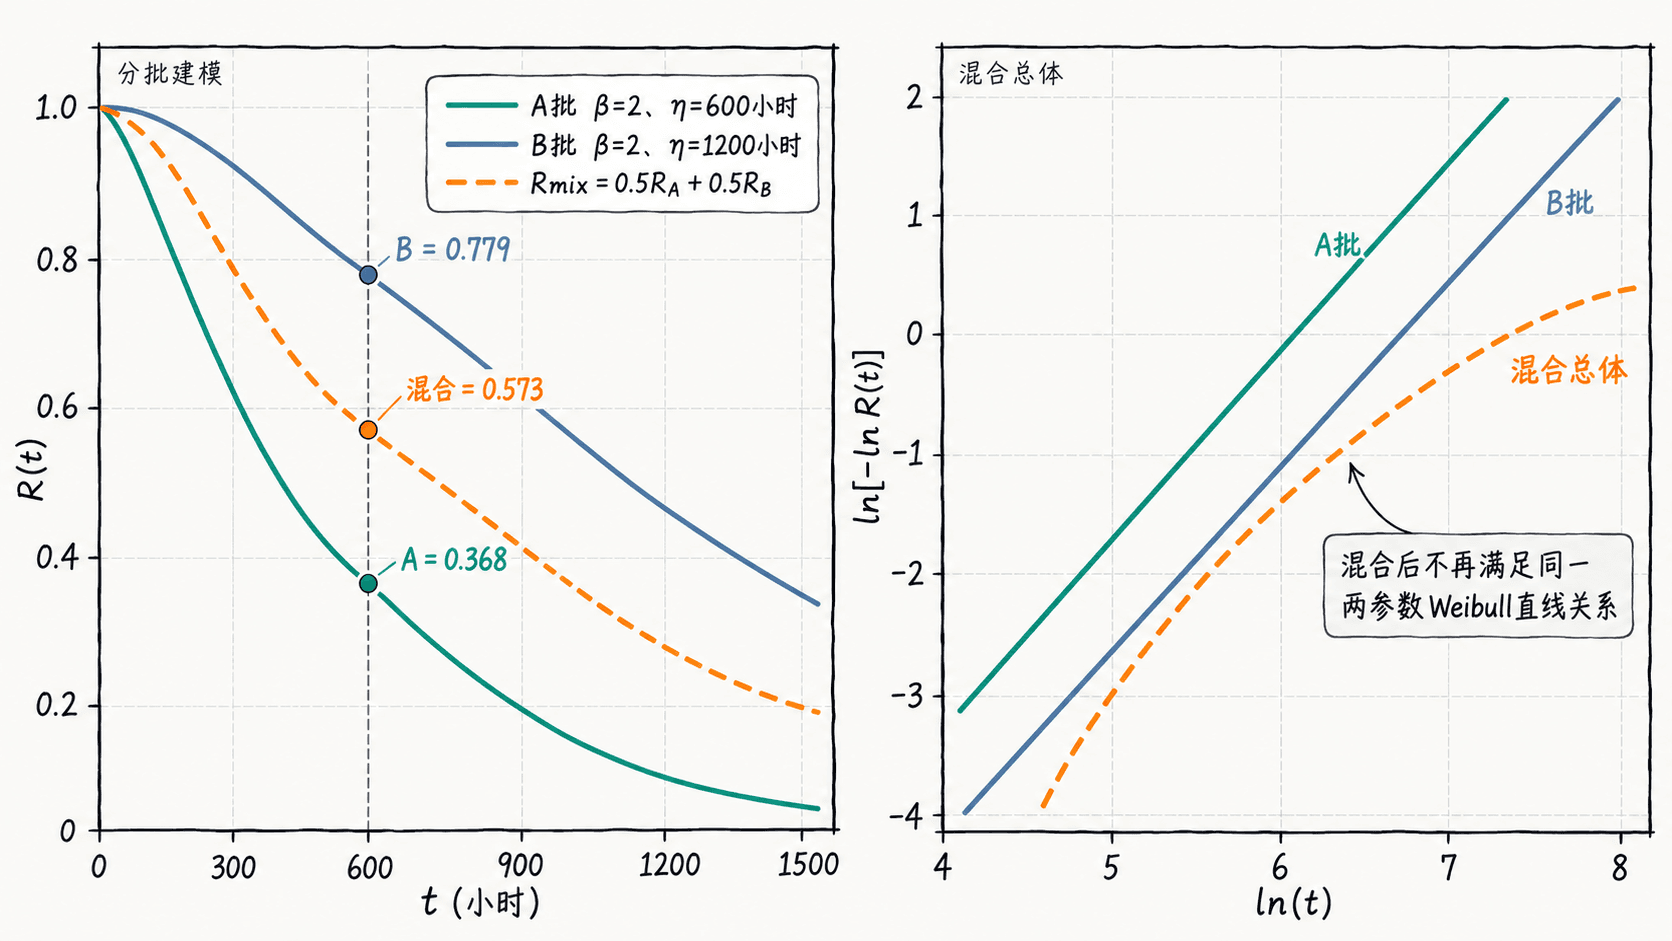
用最小代码复核偏差
下面的 Python 3 示例只计算已知模型的理论值,不把参数当作从样本拟合得到。特意固定形状参数为 2,从不同时间点反推混合总体的“单一尺度参数”,观察其是否一致。
from math import exp, log, sqrt

beta = 2.0
etas = {"A": 600.0, "B": 1200.0}

def survival(t, eta):
    return exp(-(t / eta) ** beta)

for t in (600, 1000):
    a = survival(t, etas["A"])
    b = survival(t, etas["B"])
    mix = 0.5 * a + 0.5 * b  # 假定目标设备群中两批各占一半
    # 若混合总体仍是 beta=2 的单一 Weibull,eta 不应随时间变
    eta_implied = t / sqrt(-log(mix))
    print(f"t={t}h A={a:.3f} B={b:.3f} mix={mix:.3f} eta={eta_implied:.1f}h")

# B10 为累计失效概率首次达到 10% 的寿命分位点
factor = sqrt(-log(0.9))
print(f"B10 A={etas['A'] * factor:.1f}h B={etas['B'] * factor:.1f}h")
预期输出:
t=600h A=0.368 B=0.779 mix=0.573 eta=804.5h
t=1000h A=0.062 B=0.499 mix=0.281 eta=887.3h
B10 A=194.8h B=389.5h
同一混合总体在两个时点反推的尺度分别为 804.5 与 887.3 小时,说明不能沿用 的单一 Weibull 模型。两批 B10 相差一倍,若直接报告合并后的单一 B10,就会掩盖 A 批的早期寿命风险。
同时检查统计差异与工程差异
真实数据先分别画 Kaplan–Meier 曲线,标明右删失刻痕与各时点风险集;再按批次拟合含删失样本的 Weibull 模型。对每条记录,失效事件向似然贡献密度 ,独立右删失向似然贡献可靠度 ,不能只拿失效样本去拟合。
对两个批次,可以比较“共用 ”与“各自估计 ”的最大对数似然。设分组模型的最大对数似然为 、合并模型为 ,统计量 在常规正则条件下近似服从自由度为 2 的卡方分布;显著性水平 0.05 的临界值约为 5.99。若 ,有证据反对共用参数;若未超过,也不等于证明两批等效,尤其在失效数少、删失比例高时。
工程上还应事先约定允许差异,例如要求两批 B10 比值的置信区间完全落在 0.90~1.10 内,才认为寿命差异足够小。该 10% 是示例容差,并非行业通用门槛。若样本尚不足以把区间收窄,应保留“不确定”,而不是直接合并。
根据差异来源选择建模范围
- 可考虑共用模型:失效定义、运行应力、起始时间及删失机制可比;分层曲线无明显系统偏离;分组检验与预设等效容差均支持共用参数。
- 先调整协变量:温度、载荷、占空比或生产日期不同,先用含这些变量的加速寿命模型或生存回归校正,再检查供应商或批次残余差异;不要直接把高温样本和常温样本当作同分布。
- 必须分组或部分合并:失效模式不同、曲线明显分离或 B10 差异超限时,各批独立报告参数;某批失效样本过少,可考虑具有批次效应的层级模型,并明确其借用其他批次信息的假设。
若最终需要预测由 A、B 组成的整机队列,应依据预计实际装机比例组合各批可靠度,并说明权重及适用应力。可以合并计算总体任务可靠度,不代表可以把各批寿命数据强行拟合为同一 Weibull 分布。