
质量与可靠性 / 系统课时
为典型设备建立寿命与维修数据集
为典型设备建立寿命与维修数据集
要把电机驱动设备的维修台账用于寿命分析,必须统一运行工时、零件更换和故障判定口径。这里以一台设备的示例记录,整理出寿命区间、故障标志和右删失原因,并用脚本发现重复、缺失及不合理记录。
学习目标
- 区分设备累计工时、零件服役寿命与停机维修时长。
- 将故障、更换、保养和观察截止转换为可追溯的寿命区间。
- 用可运行脚本检查重复事件、缺失工时和统计边界。
固定设备和观测口径
设备编号为 MTR-01,观察窗口从 2026-01-01 至 2026-06-30。起点设备工时表为 1200 h,截止时为 2100 h。轴承 BRG-A、驱动器 DRV-A 和编码器 ENC-A 在起点已安装;示例假设其安装时工时可从装配记录核实为 1200 h,而不是把观察起点误当作所有旧部件的安装时点。
寿命时间统一采用设备的累计运行工时,不是两个维修日期之间的日历天数。本例设备工时表在停机时不计数,因此更换轴承花费的 6 h 停机时间记录在维修表,不能计入轴承服役寿命。
| 原始事件 | 工时表读数 | 对象 | 记录及处理口径 |
|---|---|---|---|
| F01 | 1520 h | BRG-A | 轴承卡滞,停机 6 h 后更换为 BRG-B;故障退出 |
| M01 | 1710 h | BRG-B | 补脂保养;不生成失效,也不重置安装工时 |
| P01 | 1850 h | DRV-A | 预防性更换为 DRV-B;非故障退出 |
| C01 | 2100 h | 在役零件 | 观察截止;仍在役的零件右删失 |
每个事件同时保留事件编号、设备编号、零件序列号、发生时间、工时表读数和维修动作。设备编号不足以区分前后两只轴承;序列号与安装起点才能唯一确定一段服役经历。
生成零件寿命区间
每段寿命以安装读数为起点、故障或退出读数为终点,计算 。对于“首次故障寿命”,故障退出记 event=1;截止时仍未故障或在故障前预防更换记 event=0,同时保留不同的退出原因。
| 区间ID | 部件序列号 | 安装→退出工时 | 寿命/h | event | 退出原因 |
|---|---|---|---|---|---|
| E01 | BRG-A | 1200→1520 | 320 | 1 | 故障 |
| E02 | BRG-B | 1520→2100 | 580 | 0 | 观察截止 |
| E03 | DRV-A | 1200→1850 | 650 | 0 | 预防更换 |
| E04 | DRV-B | 1850→2100 | 250 | 0 | 观察截止 |
| E05 | ENC-A | 1200→2100 | 900 | 0 | 观察截止 |
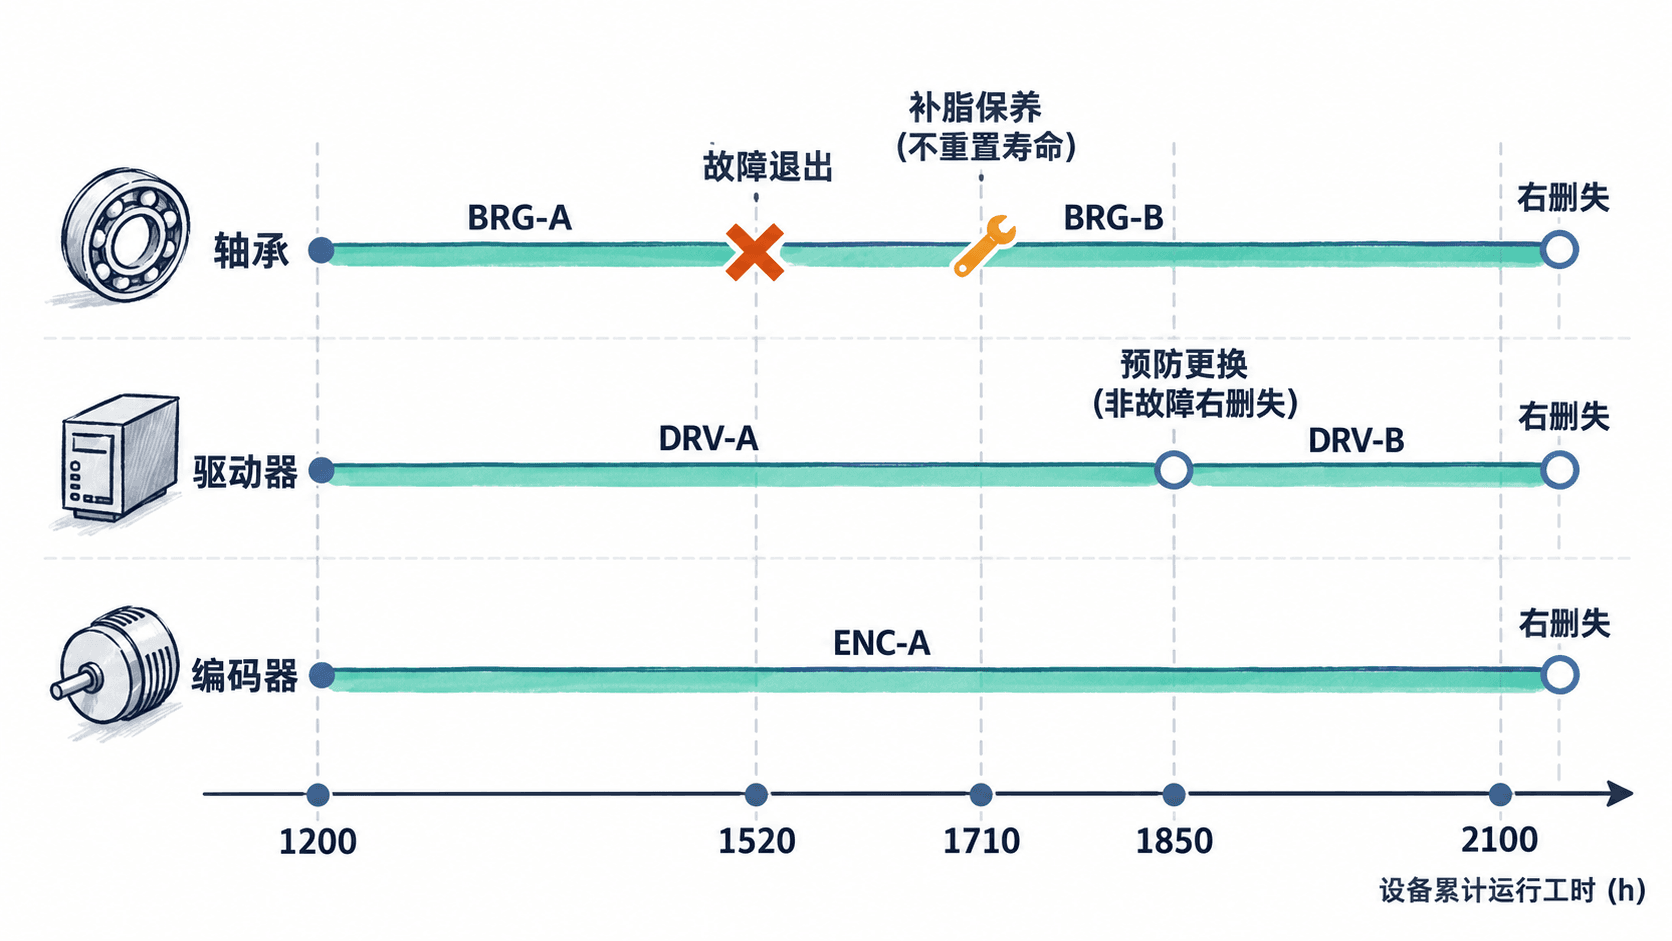
这五行是零件寿命样本,不是五台独立设备。保养事件 M01 只进入维修事件表;若把 1710 h 当作 BRG-B 的新安装读数,会把实际已运行的 190 h 无故抹掉。故障后的原件若仅修复而未更换,也不能自动假定寿命“归零”;本例选择以首次故障为终点,后续重复故障另建事件模型。
用 Python 检查原始区间
下面使用 Python 3 标准库,模拟从事件表汇总后的八行候选区间:五行有效数据、一条完全重复记录、一条缺少安装工时以及一条工时倒退记录。将代码保存为 check_life.py,执行 python check_life.py。正式项目可将内嵌的 CSV 字符串替换为从原始台账导出的内容。
from collections import Counter
from csv import DictReader
from io import StringIO

CUTOFF = 2100
RAW = '''episode_id,part,serial,start_h,end_h,reason
E01,bearing,BRG-A,1200,1520,FAIL
E01,bearing,BRG-A,1200,1520,FAIL
E02,bearing,BRG-B,1520,2100,CUTOFF
E03,drive,DRV-A,1200,1850,PM_REPLACE
E04,drive,DRV-B,1850,2100,CUTOFF
E05,encoder,ENC-A,1200,2100,CUTOFF
E06,sensor,SEN-A,,2100,CUTOFF
E07,sensor,SEN-B,2050,2020,CUTOFF
'''

seen, cleaned, issues = {}, [], Counter()
for row in DictReader(StringIO(RAW)):
    key = row["episode_id"]
    if key in seen:
        # 相同编号但内容冲突时不能自动视为重复
        issues["duplicate" if row == seen[key] else "id_conflict"] += 1
        continue
    seen[key] = row
    if not row["start_h"] or not row["end_h"]:
        issues["missing_hour"] += 1
        continue
    start, end = int(row["start_h"]), int(row["end_h"])
    if start < 0 or end <= start or end > CUTOFF:
        issues["invalid_interval"] += 1
        continue
    reason = row["reason"]
    if reason not in {"FAIL", "CUTOFF", "PM_REPLACE"}:
        issues["invalid_reason"] += 1
        continue
    if reason == "CUTOFF" and end != CUTOFF:
        issues["wrong_cutoff"] += 1
        continue
    # 只有首次故障才计作事件;非故障退出保留删失原因
    cleaned.append((key, row["part"], row["serial"],
                    end - start, int(reason == "FAIL"), reason))

for episode in cleaned:
    print(*episode)
print("valid:", len(cleaned), "fail:", sum(e[4] for e in cleaned),
      "censored:", sum(1 - e[4] for e in cleaned))
print("issues:", dict(sorted(issues.items())))
预期输出:
E01 bearing BRG-A 320 1 FAIL
E02 bearing BRG-B 580 0 CUTOFF
E03 drive DRV-A 650 0 PM_REPLACE
E04 drive DRV-B 250 0 CUTOFF
E05 encoder ENC-A 900 0 CUTOFF
valid: 5 fail: 1 censored: 4
issues: {'duplicate': 1, 'invalid_interval': 1, 'missing_hour': 1}
代码仅自动移除完全一致的重复行,其他异常留在质量报告中等待核实。缺失工时不能填 0;如同一 episode_id 对应两种故障时间,必须回查原始工单,而不能任意保留第一条。还需按同一序列号检查安装区间是否重叠,并与现场工时表、换件单交叉核对。
保留追溯链与建模限制
正式入库建议分开保存设备工时快照表、原始维修事件表和寿命区间表。区间表除 episode_id、序列号、start_h、end_h、event 外,应保留 exit_reason、关联原始工单 ID、提取批次及质量检查状态;被剔除的 E06、E07 应留在异常清单,不得悄悄丢弃。
验收时核对三件事:BRG-B 在 1710 h 保养后寿命未重置;统计结果为 1 条故障、4 条右删失;每个退出点均能指回 F01、P01 或观察截止记录。预防更换如果由劣化征兆触发,删失可能与故障风险相关,直接用于 Kaplan–Meier 或 Weibull 拟合会产生偏差,需单独分析其选择机制。
这组数据只用于演示数据治理过程。不同部件、同一台设备上的五段经历不能当作五个独立同分布的整机寿命样本;要估计整机或某类部件的可靠度,仍需扩大到同规格、同口径的样本群。