
质量与可靠性 / 系统课时
极大似然估计如何处理右删失
极大似然估计如何处理右删失
一批设备在试验结束时,有的已经失效,有的仍在运行。若只用已失效设备估计寿命,会丢掉后者“至少存活到某时刻”的信息。本篇用 8 台设备的记录,构造包含右删失的似然函数,估计指数与 Weibull 参数,并量化错误删样本带来的差异。
学习目标
- 正确记录失效时间与右删失时间,解释它们各自的似然贡献。
- 计算指数模型的极大似然估计,并用 Python 优化 Weibull 参数。
- 根据输出比较删失处理方式,检查拟合结果的使用边界。
记录失效与右删失
假设 8 台同型设备从投入运行开始计时,观察到以下结果;时间单位统一为小时。
| 观测结局 | 观测时间 | 事件标记 |
|---|---|---|
| 首次失效 | 200、420、600、750、900 | 1 |
| 停止观察时仍正常运行 | 1000、1100、1200 | 0 |
每台设备只记录一条数据:实际观察时间 ,其中 是真实失效时间, 是退出观察的时间。 表示观察到失效, 表示右删失。比如 1100 小时右删失只说明 ,绝不能把 1100 小时当成失效时刻。
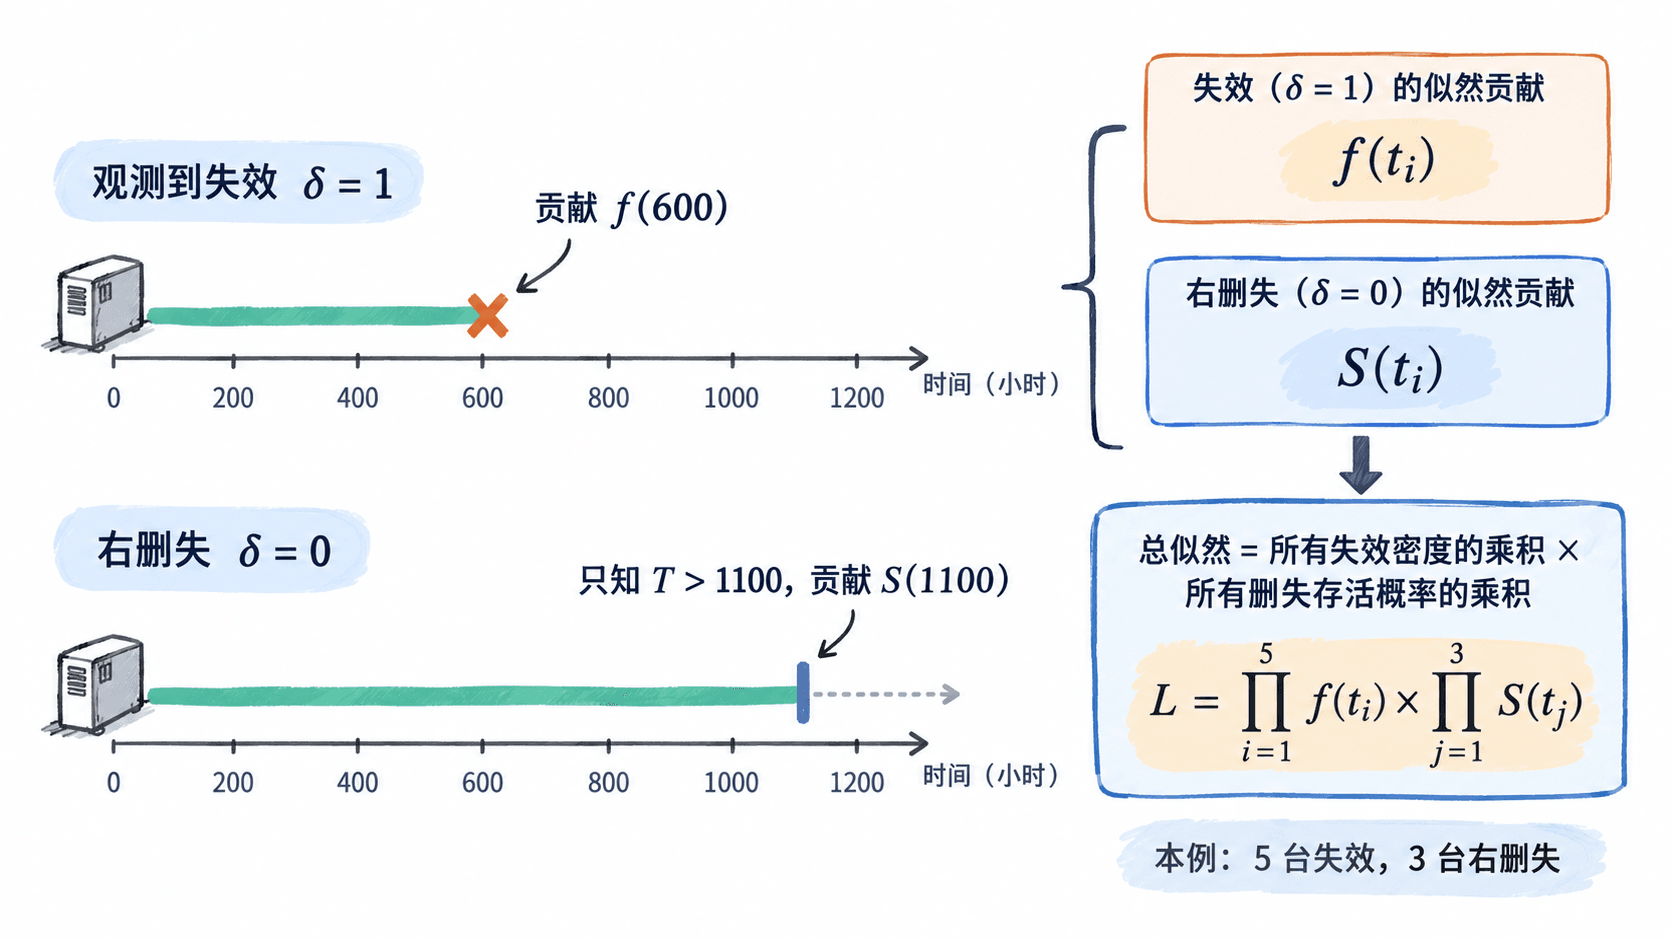
让删失样本进入似然函数
设 为寿命概率密度, 为存活函数。失效样本贡献密度 ;右删失样本贡献在其退出时间仍存活的概率 。假设设备相互独立、删失机制与潜在寿命独立,则忽略与寿命参数无关的删失机制部分,似然函数为:
对于 Weibull 寿命模型,形状参数 ,尺度参数 ,有:
对似然取对数,可以把连乘变成求和。实际优化时最小化其负值:
指数分布是 的特例。记失效数为 、总观察时长为 ,则失效率的估计为 ,尺度参数 。本例总观察时长为 6170 小时,故 小时;直接删掉右删失记录,则会错误得到 小时。
用数值优化估计 Weibull 参数
下面使用 Python 3.10+、NumPy 和 SciPy。由于 、 必须大于 0,程序优化它们的对数,并使用 L-BFGS-B 限制本例的搜索范围: 在 0.2~5 之间, 在 100~5000 小时之间。该范围只适用于演示数据,不能直接当作其他设备的工程先验。
import numpy as np
from scipy.optimize import minimize

time = np.array([200., 420., 600., 750., 900., 1000., 1100., 1200.])
event = np.array([1, 1, 1, 1, 1, 0, 0, 0], dtype=int)

def weibull_nll(log_par, t, d):
    beta, eta = np.exp(log_par)  # 对数参数化保证两个参数为正
    log_ratio = np.log(t / eta)
    # 失效记录提供密度,右删失记录仅提供存活概率
    return np.exp(beta * log_ratio).sum() - (
        d * (np.log(beta) - np.log(eta) + (beta - 1) * log_ratio)
    ).sum()

def fit_weibull(t, d):
    result = minimize(
        weibull_nll,
        x0=np.log([1.2, np.mean(t)]),
        args=(t, d),
        method="L-BFGS-B",
        bounds=[(np.log(0.2), np.log(5.0)), (np.log(100), np.log(5000))],
    )
    if not result.success:
        raise RuntimeError(result.message)
    return np.exp(result.x)

failures = time[event == 1]
beta_all, eta_all = fit_weibull(time, event)
# 错误对照:丢掉删失记录,假装剩余样本都是完整寿命
beta_drop, eta_drop = fit_weibull(failures, np.ones(failures.size, dtype=int))
eta_exp_all = time.sum() / event.sum()
eta_exp_drop = failures.mean()

print(f"指数 正确 eta={eta_exp_all:.1f}, 删失删除 eta={eta_exp_drop:.1f}")
print(f"Weibull 正确 beta={beta_all:.3f}, eta={eta_all:.1f}")
print(f"Weibull 删除 beta={beta_drop:.3f}, eta={eta_drop:.1f}")
print(f"1000h 可靠度 正确={np.exp(-(1000 / eta_all)**beta_all):.3f}, 删除={np.exp(-(1000 / eta_drop)**beta_drop):.3f}")
预期输出(末位小数可能随优化器版本略有差异):
指数 正确 eta=1234.0, 删失删除 eta=574.0
Weibull 正确 beta=1.669, eta=1083.4
Weibull 删除 beta=2.586, eta=647.5
1000h 可靠度 正确=0.417, 删除=0.046
检查结果是否可信
Weibull 正确拟合的尺度参数约为 1083 小时,删除删失样本后仅为 648 小时;在 1000 小时处,预测可靠度从约 0.417 变为 0.046。这是本例的偏差大小,不代表所有删失数据都会造成同一方向或幅度的偏差。 对应拟合的失效率随时间上升,但仅 5 次失效不足以据此下定论。
交付工程分析前,至少检查以下条件:
- 所有观测时间均大于 0;失效标记只有 0 和 1;设备的计时起点与失效定义一致。
- 删失来自试验截止、计划退出等与故障风险独立的机制。如果设备因异常预警被撤出,独立删失假设可能失效。
- 优化器返回成功,参数未贴近设置的上下界;用 Kaplan–Meier 估计与模型可靠度曲线对比,并评估参数置信区间。没有失效事件时,不能按本例公式得到有限的指数尺度估计。
右删失数据不是“缺失的无效行”:只要删失机制假设成立,它们贡献的存活概率就应进入极大似然估计。