
质量与可靠性 / 系统课时
对数正态分布适合哪些寿命数据
对数正态分布适合哪些寿命数据
当一批零件的失效时间明显右偏、少数样品寿命很长时,直接用正态分布描述寿命可能得到不合理的负值。本篇用对数正态模型计算寿命分位点,再让 Weibull 模型对齐相同的早期分位点,观察远端寿命预测为何仍会分歧。
学习目标
- 判断对数正态寿命模型的假设和适用边界。
- 根据对数参数计算 B10、中位寿命及其他分位点。
- 比较两种模型的尾部预测,并正确处理右删失数据。
为什么要对寿命取对数
设 是同一失效模式、相近工况下产品的首次失效时间,且 。若以小时为单位的寿命数值满足 ,就称 服从对数正态分布。其中 是对数寿命的均值, 是对数寿命的标准差; 本身并不服从正态分布。
这类模型适用于正值、右偏,且对数后大致呈对称钟形的数据。例如,同种材料、载荷一致的部件,寿命受多种近似乘性因素影响时,可将其列为候选模型。可先取 30~50 个同条件的完整失效时间,查看 的直方图与正态概率图,而不是只看原始寿命偏斜就确定模型。
单位必须统一:本例对“小时数值”取自然对数;若全部换成分钟, 会增加 ,而 不变。混合多个失效机理或不同载荷的样本,即使右偏,也不能据此认定服从一个对数正态分布。
由参数计算寿命分位点
累计失效概率 表示截至 已失效的比例,可靠度 表示运行到 仍未失效的概率:
给定失效比例 ,相应的寿命分位点为:
这里 是标准正态累积分布函数。以假设参数 、 为例, 小时, 小时, 小时。B10 表示约 10% 产品在此前失效、约 90% 仍能运行,不是“10% 产品仍能运行”。该模型的平均寿命为 小时,也不等于中位寿命。
对齐早期分位点后比较尾部
两参数 Weibull 分布可写为 。为了排除“两个模型本来就拟合了不同早期寿命”的干扰,下面选取 Weibull 的形状参数 与尺度参数 ,让两种模型的 B10、B50 完全相同,再比较 B90、B99。
Python 3.8 及以上版本可直接运行以下示例,无需第三方依赖:
import math
from statistics import NormalDist

normal = NormalDist()
mu, sigma = math.log(1000.0), 0.5
probabilities = (0.10, 0.50, 0.90, 0.99)

def lognormal_quantile(p):
    return math.exp(mu + sigma * normal.inv_cdf(p))

q10, q50 = lognormal_quantile(0.10), lognormal_quantile(0.50)
# 让 Weibull 与对数正态具有相同的 B10 和 B50
a10, a50 = -math.log(0.9), -math.log(0.5)
beta = math.log(a50 / a10) / math.log(q50 / q10)
eta = q50 / a50 ** (1 / beta)

def weibull_quantile(p):
    return eta * (-math.log1p(-p)) ** (1 / beta)

print(f"Weibull beta={beta:.2f}, eta={eta:.1f} h")
for p in probabilities:
    print(f"F={p:.0%}: lognormal={lognormal_quantile(p):.0f} h, Weibull={weibull_quantile(p):.0f} h")

# 直接比较运行到 2000 小时仍未失效的概率
r_ln = normal.cdf((mu - math.log(2000.0)) / sigma)
r_w = math.exp(-((2000.0 / eta) ** beta))
print(f"R(2000 h): lognormal={r_ln:.4f}, Weibull={r_w:.4f}")
预期输出:
Weibull beta=2.94, eta=1132.8 h
F=10%: lognormal=527 h, Weibull=527 h
F=50%: lognormal=1000 h, Weibull=1000 h
F=90%: lognormal=1898 h, Weibull=1504 h
F=99%: lognormal=3200 h, Weibull=1904 h
R(2000 h): lognormal=0.0828, Weibull=0.0049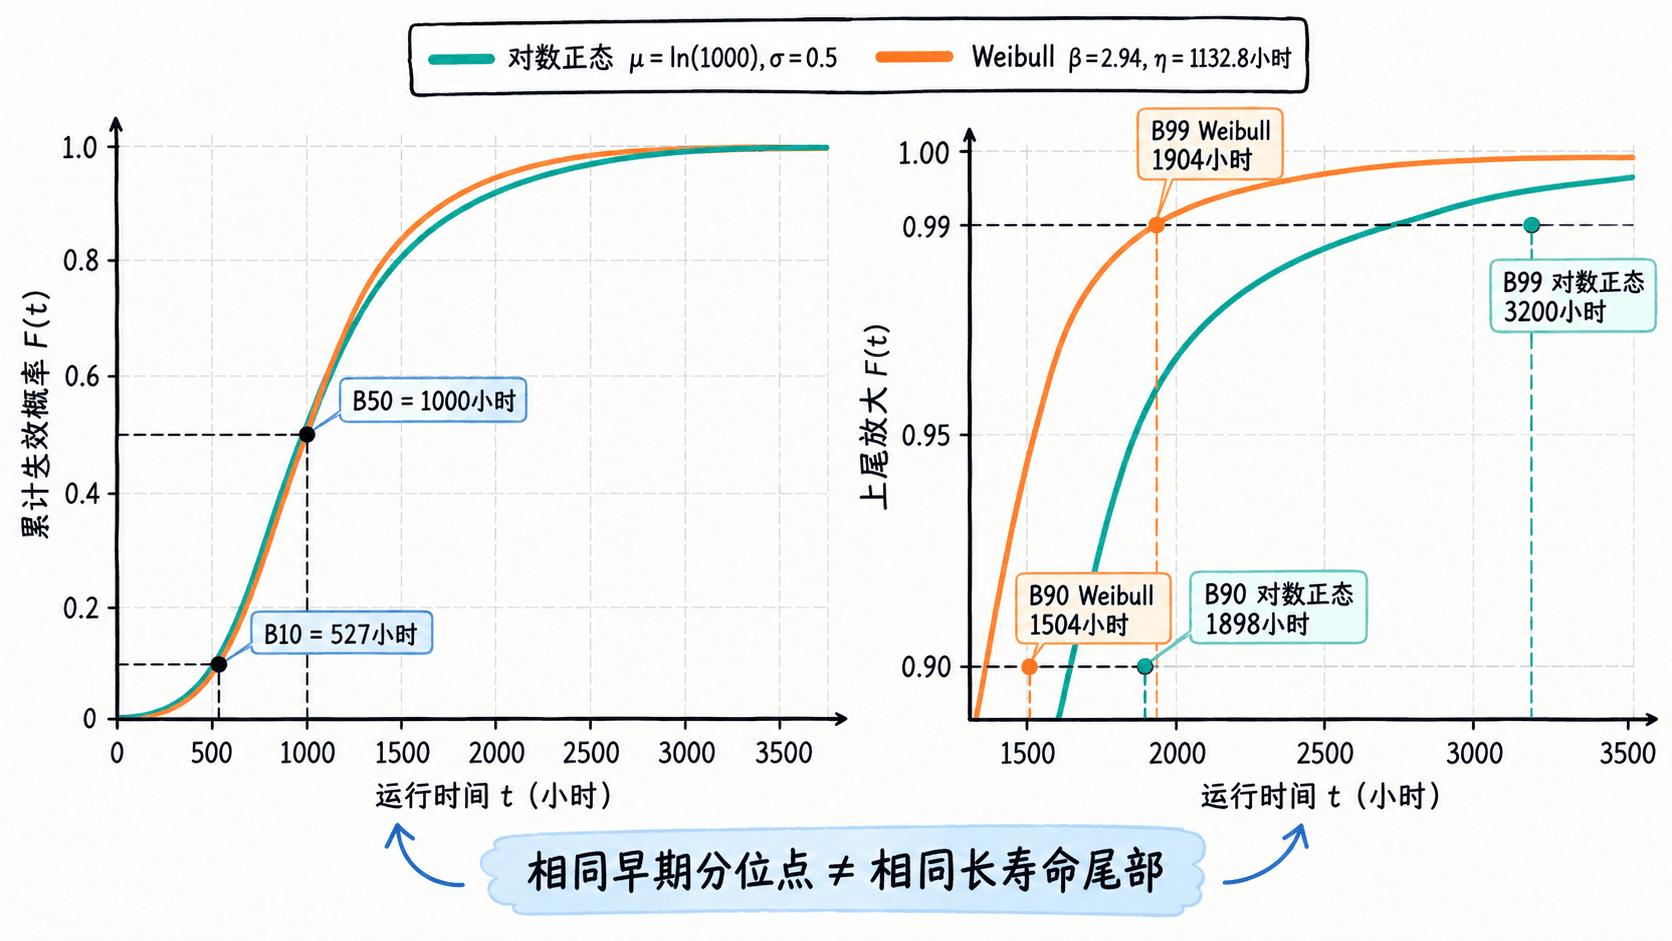
在这个特定参数组合下,2000 小时的可靠度预测相差约 17 倍。对数正态分布的寿命上尾更长;对应的风险率通常先上升后下降,而本例 的 Weibull 风险率随时间单调上升。但尾部差异并不说明某个模型天然更准确,准确性取决于真实失效机理和观测范围。
怎样判定预测可不可信
- 先核对样本:例如 50 台设备中 36 台已失效、14 台在试验结束时仍正常工作,后 14 台是右删失,不能把试验截止时间误当成失效时间。
- 用相同数据拟合:分别检查对数正态概率图、Weibull 概率图;存在右删失时用包含删失信息的极大似然估计,结合 AIC、经验生存曲线以及关键任务时间的预测误差比较。
- 限定外推范围:若最长跟踪仅到 1600 小时,就不能把模型算出的 B99=3200 小时说成已由试验证实;需延长跟踪、补充加速寿命试验并验证加速关系,或报告两模型构成的预测范围。
实际选型应先按失效机理和工况分组,再比较拟合与任务时长内的预测表现。分位点是模型推断值,不是产品寿命的保证值。公式与参数定义可对照 NIST 对数正态寿命模型 和 NIST Weibull 寿命模型。