
编码与格式 / 系统课时
识别 H.264 宏块与 NAL 结构
识别 H.264 宏块与 NAL 结构
拿到一段 H.264 码流,首先要分清编码图像使用的宏块、预测方式,以及承载数据的 NAL 单元。本篇通过结构示意、十六进制样例和一个可运行的解析脚本,识别 SPS、PPS、切片与 IDR 图像,建立从码流边界到图像恢复的阅读路径。
学习目标
- 区分 16×16 宏块、帧内预测、帧间预测及残差编码的职责。
- 识别 NAL 单元头部,理解 SPS、PPS、切片与 IDR 的关系。
- 使用 Python 检查 Annex B 码流中的 NAL 类型,并判断常见解析错误。
从宏块理解图像编码
H.264/AVC 以宏块(Macroblock)作为基本编码处理单元。对常见的 4:2:0 视频,一个宏块覆盖 16×16 个亮度采样及对应的色度采样。图像通常按宏块处理,但比特流使用切片组织宏块数据,不能把宏块直接等同于 NAL 单元。
宏块可以选择帧内预测或帧间预测,并将原始数据与预测结果之间的差值编码为残差。编码器通常对残差执行整数变换、量化和熵编码;解码器则通过反量化、反变换及预测值相加恢复图像样本。
| 工具 | 作用 | 典型划分 |
|---|---|---|
| 帧内预测 | 利用当前图像已重建的邻近样本预测 | Intra 4×4、Intra 16×16;部分档次支持 Intra 8×8 |
| 帧间预测 | 通过运动矢量引用参考图像 | 16×16、16×8、8×16、8×8 等 |
| 残差变换与量化 | 压缩预测未消除的信息 | 常见 4×4 变换;部分档次支持 8×8 |
| 熵编码 | 将语法元素编码为比特 | CAVLC;CABAC 取决于档次与配置 |
例如一个 1920×1080 的视频图像,以 16×16 宏块网格组织时,水平方向有 120 个宏块,垂直方向需要向上取整为 68 行,共 8160 个宏块位置。编码时需处理边界填充及实际图像裁剪信息,不能据此认为显示高度变成了 1088。
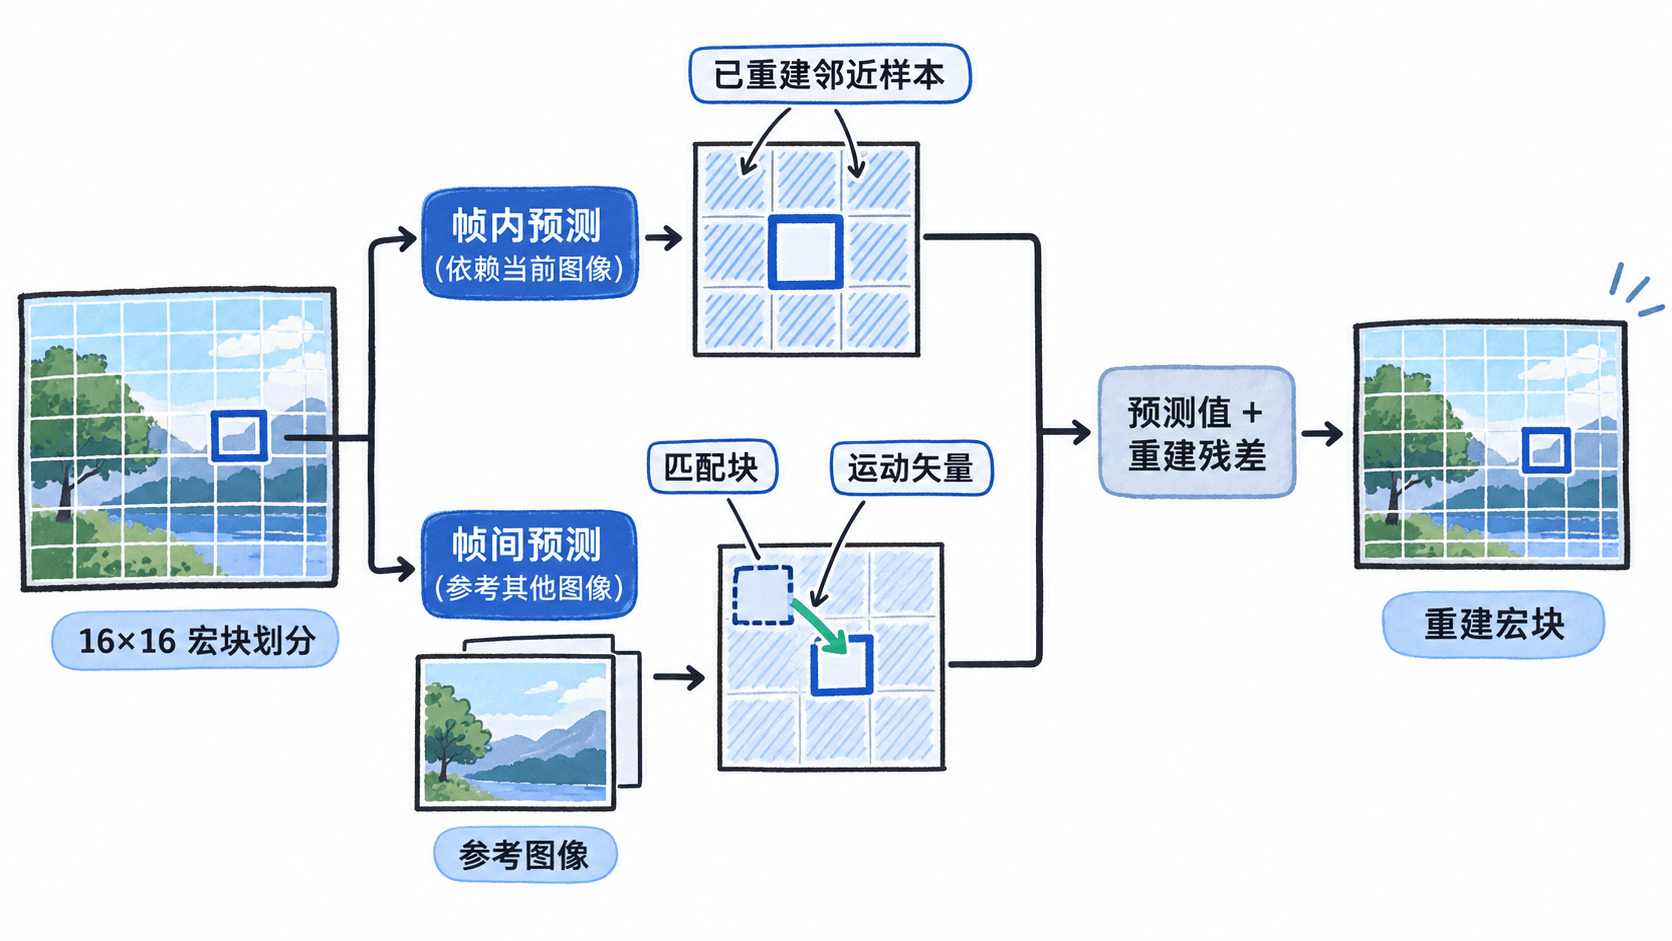
需要注意,I、P、B 是切片类型分类,而不是每个宏块都必须使用对应预测模式。P 切片和 B 切片也可以包含帧内编码宏块。判断具体宏块的预测类型,应读取切片数据中的宏块语法,而不能只看切片名称。
识别 NAL 单元与字节边界
H.264 的网络抽象层使用 NAL(Network Abstraction Layer)单元封装编码数据。NAL 头部后面通常是 RBSP(Raw Byte Sequence Payload)对应的字节序列,并可能包含用于防止伪起始码的防竞争字节。
每个常规 H.264 NAL 单元的第一个字节由三个字段组成:
| 字段 | 位数 | 含义 |
|---|---|---|
| forbidden_zero_bit | 1 | 必须为 0 |
| nal_ref_idc | 2 | 表示参考相关的重要程度;0 表示不用于参考图像重建 |
| nal_unit_type | 5 | 标识 NAL 类型 |
以头字节 0x67 为例,其二进制为 01100111:最高位为 0,接下来的两位为 11,最后五位为 00111,因此 nal_ref_idc=3、nal_unit_type=7,这是 SPS 类型。
常见 NAL 类型如下:
| 类型值 | 名称 | 主要用途 |
|---|---|---|
| 1 | 非 IDR 切片 | 承载非 IDR 图像的切片数据 |
| 5 | IDR 切片 | 承载 IDR 图像的切片数据 |
| 6 | SEI | 承载补充增强信息 |
| 7 | SPS | 序列参数集 |
| 8 | PPS | 图像参数集 |
| 9 | AUD | 可选的访问单元分隔符 |
在 Annex B 字节流格式中,NAL 之间使用 00 00 01 或 00 00 00 01 起始码分隔。起始码是字节流封装信息,不属于 NAL 头部。MP4 等容器通常采用长度前缀存储 NAL 单元,不能直接按照 Annex B 起始码查找。
还要区分防竞争字节 03:例如编码数据需要表示 00 00 01 这样的字节模式时,NAL 字节序列中可能写入 00 00 03 01。解析 RBSP 时应按规范去除防竞争字节,而不是简单删除所有值为 03 的字节。
SPS、PPS 和切片怎样配合
解码器不能只读取切片压缩数据就直接恢复图像,还需要先建立参数上下文。
- SPS(Sequence Parameter Set)提供序列级参数,例如档次、级别、图像尺寸相关语法、参考图像及图像顺序计数相关配置。
- PPS(Picture Parameter Set)提供图像级解码参数,例如熵编码模式、初始量化参数及部分切片组织配置。
- 切片头包含引用的 PPS 标识,PPS 再通过标识引用 SPS;切片数据携带宏块相关的预测、运动与残差信息。
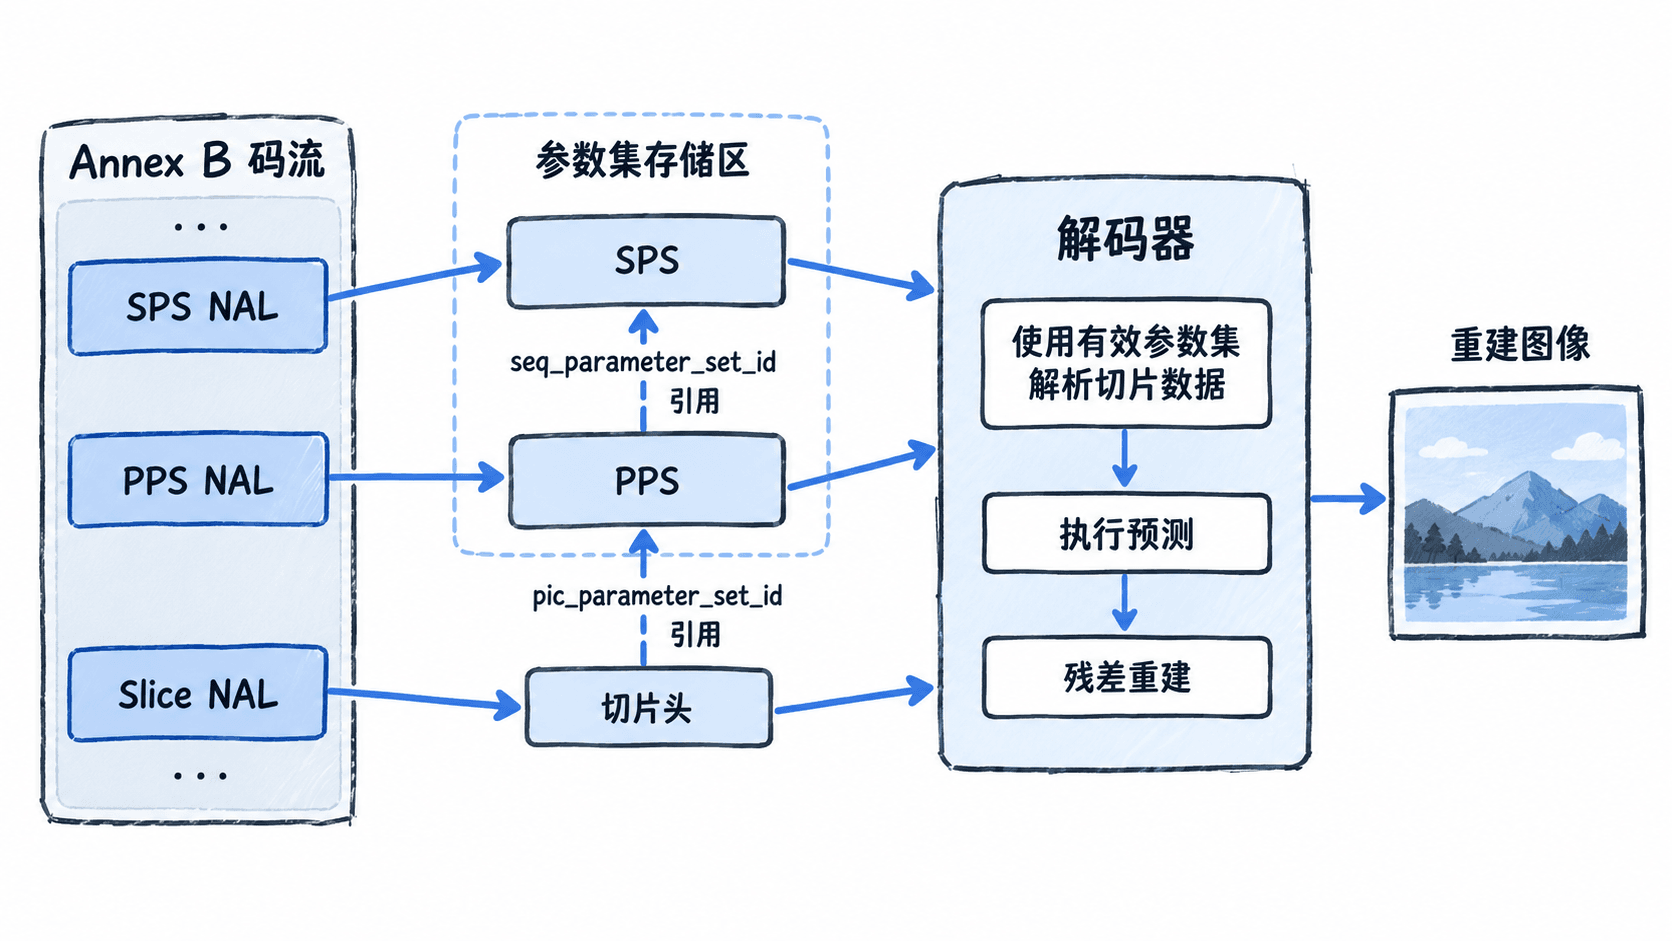
实际解析可以遵循以下顺序:
- 根据 Annex B 起始码或容器中的长度字段取出完整 NAL。
- 读取 NAL 头字节,确定类型并检查禁止位。
- 遇到 SPS、PPS 时解析并保存参数集,按照标识建立引用关系。
- 遇到 VCL 切片时先读取切片头,定位已激活的 PPS、SPS,再解析切片数据。
- 使用预测、反量化、反变换、环路去块滤波等解码工具重建图像,并根据图像顺序相关信息管理输出。
IDR 是即时解码刷新图像,通常用于建立不依赖刷新点之前参考图像的解码入口;但不是所有 I 切片都属于 IDR。一个图像也可能由多个切片组成,所以不能简单按 NAL 数量统计视频帧数。
使用 Python 检查 NAL 类型
下面的示例使用 Python 3 标准库,扫描一段人为构造的 Annex B 字节序列,提取 NAL 头部信息。样例只用于验证 NAL 分类,不包含完整可解码的 SPS、PPS 和切片负载。
# Python 3:演示 Annex B 起始码与 NAL 头部识别
stream = bytes.fromhex(
    '00 00 00 01 67 42 00 1e '
    '00 00 01 68 ce 06 e2 '
    '00 00 01 65 88'
)

names = {1: 'Non-IDR', 5: 'IDR', 6: 'SEI', 7: 'SPS', 8: 'PPS', 9: 'AUD'}

def find_start_codes(data):
    positions = []
    i = 0
    while i < len(data) - 2:
        if data[i:i + 4] == b'\x00\x00\x00\x01':
            positions.append((i, 4))
            i += 4
        elif data[i:i + 3] == b'\x00\x00\x01':
            positions.append((i, 3))
            i += 3
        else:
            i += 1
    return positions

starts = find_start_codes(stream)
for index, (position, prefix_size) in enumerate(starts):
    begin = position + prefix_size
    end = starts[index + 1][0] if index + 1 < len(starts) else len(stream)
    nal = stream[begin:end]
    if not nal:
        continue
    header = nal[0]
    forbidden = header >> 7
    ref_idc = (header >> 5) & 0x03
    nal_type = header & 0x1F
    print(f'{index + 1}: {names.get(nal_type, "Other")} '
          f'type={nal_type} ref_idc={ref_idc} forbidden={forbidden}')
预期输出:
1: SPS type=7 ref_idc=3 forbidden=0
2: PPS type=8 ref_idc=3 forbidden=0
3: IDR type=5 ref_idc=3 forbidden=0
这段程序只扫描起始码和解析头字节,没有实现完整的 H.264 语法解析、RBSP 还原或视频解码。用于真实码流时,还需要处理 NAL 边界的尾随零字节、合法负载长度及容器封装差异。若数据来自 MP4,应先识别其 NAL 长度前缀格式,不能直接套用该扫描逻辑。
检查码流时容易误判的地方
阅读 H.264 码流时,可以用下表快速定位常见误判。
| 观察现象 | 容易产生的误判 | 正确检查方式 |
|---|---|---|
出现 0x65 |
这是完整关键帧 | 只能确认该 NAL 为 IDR 切片;还需检查完整访问单元 |
| 连续出现多个类型 1 NAL | 一定有多帧图像 | 可能是同一图像的多个切片,需解析切片头 |
| 找不到 SPS、PPS | 码流必定损坏 | 先检查容器是否在 AVC 配置记录中保存参数集 |
找到 00 00 03 01 |
发现新的 NAL 起始码 | 这是可能含防竞争字节的负载内容,不能据此切分 |
| 出现 I 切片 | 可以无条件随机访问 | 需进一步判断是否为 IDR 或其他满足随机访问条件的结构 |
进行一次实际验证时,先列出全部 NAL 的类型和顺序,再定位 SPS、PPS 与切片头之间的引用关系,最后才分析宏块预测模式和残差内容。能正确区分字节流边界、参数集依赖以及图像内部编码工具,就具备了继续阅读 H.264 码流的基础。