
编码与格式 / 系统课时
区分 I/P/B 图像的依赖关系
区分 I/P/B 图像的依赖关系
看到视频编码中的 I、P、B 图像,不能只记住三种名称,还要判断它们从哪里获得预测信息、解码时依赖哪些参考图像,以及能否独立进入播放。本篇通过一组实际的引用关系和 FFmpeg 验证方法,区分图像类型、参考依赖与随机访问点。
学习目标
- 区分 I、P、B 图像允许采用的预测方式及参考依赖。
- 根据引用关系判断解码顺序与显示顺序的区别。
- 使用 FFprobe 检查图像类型,并解释为什么 I 图像不一定是随机访问点。
三种图像分别依赖什么
视频编码器把图像划分为多个区域,通过预测减少需要编码的残差信息。I、P、B 描述的是图像的编码类型,不代表每个像素都采用同一种编码模式。
| 图像类型 | 允许的预测方式 | 对其他图像的依赖 | 典型用途 |
|---|---|---|---|
| I 图像 | 帧内预测 | 不需要其他图像进行图像重建 | 独立重建当前图像、提供刷新入口 |
| P 图像 | 帧内预测、帧间预测 | 通常引用已解码的参考图像 | 利用时间相关性减少数据量 |
| B 图像 | 帧内预测、帧间预测,可使用双向预测 | 可引用两个方向的参考图像 | 提高运动场景的压缩效率 |
I 图像只使用当前图像内部的已重建样本进行预测,不需要引用其他图像的像素数据。但图像能够独立重建,不等于码流可以从此处无条件开始解码;解码器可能仍需参数集等初始化信息。
P 图像中的预测块可以引用参考图像,也可以直接采用帧内预测。P 图像并不表示所有块都必须进行帧间预测。
B 图像也不意味着每个块都同时使用前后两张图像。以 H.264 为例,B Slice 可以采用单列表预测、双列表预测或帧内预测。现代编码结构中的 B 图像还可能成为后续图像的参考图像。
从引用关系理解显示顺序
假设一个简化片段包含四张图像,按显示顺序分别为 I0、B1、B2、P3。数字表示显示位置,而不是必须采用的解码位置。
在一种允许双向预测的编码安排中:
- I0 不引用其他图像。
- P3 引用 I0。
- B1 引用 I0 和 P3。
- B2 引用 I0 和 P3。
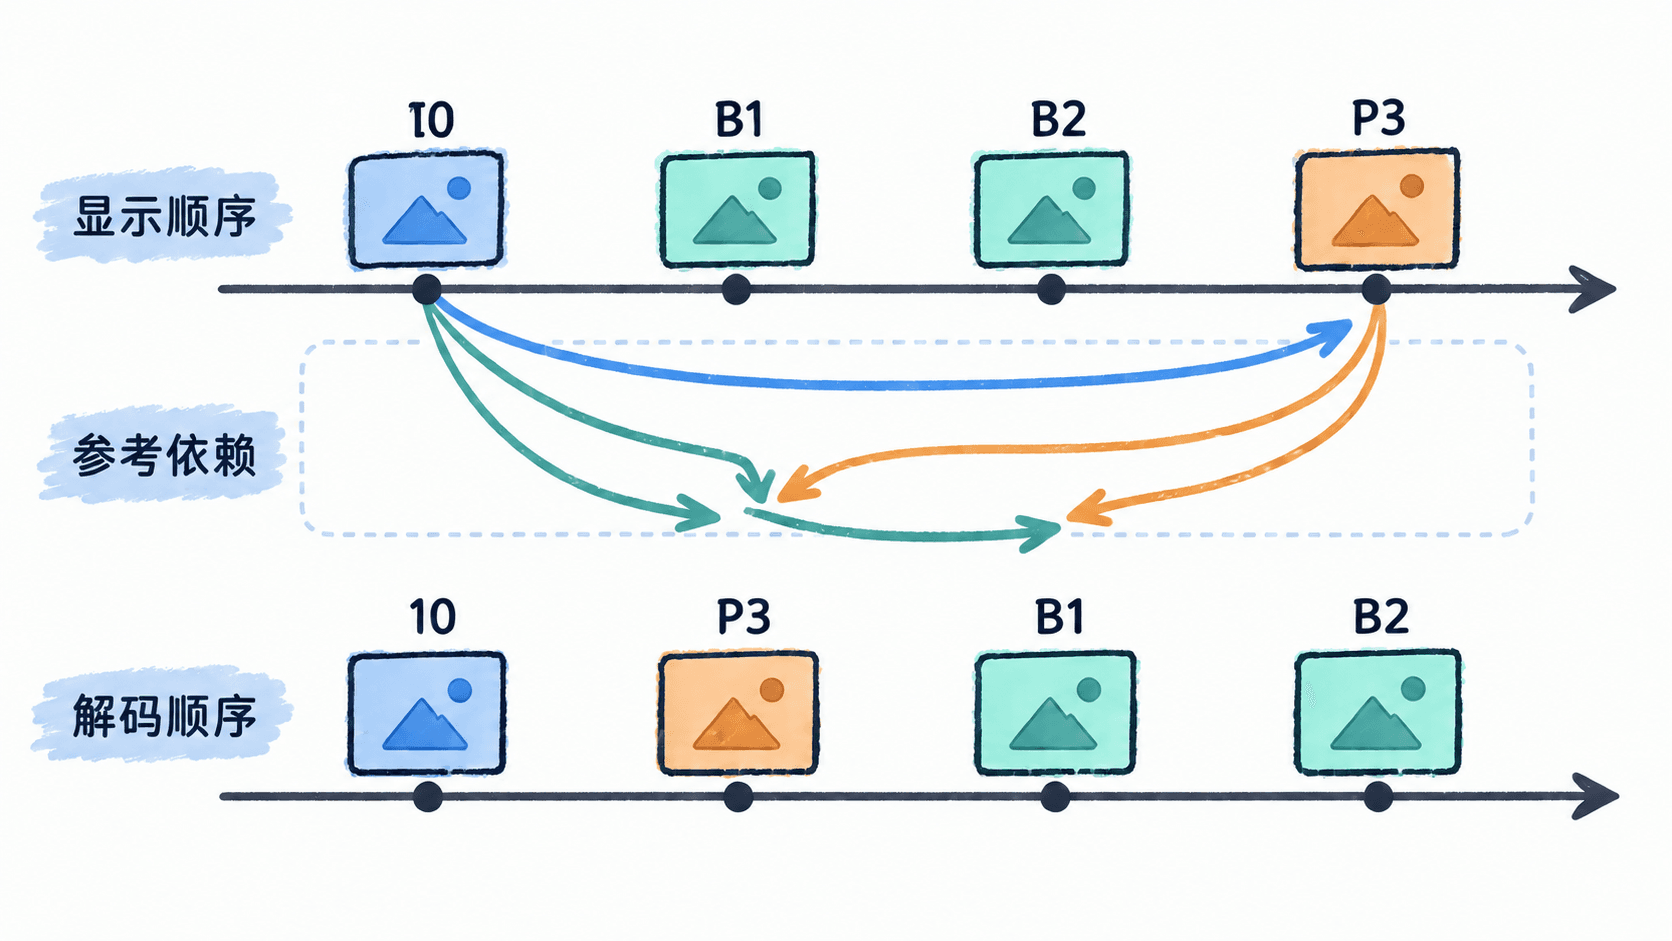
为什么 P3 要在 B1、B2 之前解码?因为 B1、B2 可能需要利用 P3 的重建像素进行预测。如果 P3 尚未解码,参考样本就不可用。
因此,这个例子的显示顺序是 I0、B1、B2、P3,而解码顺序可以是 I0、P3、B1、B2。解码器先准备参考图像,再依据显示时间戳安排输出。
真实编码器还可能采用层次 B 结构,例如先解码一个位于中间显示位置的参考 B 图像,再解码依赖它的其他 B 图像。引用关系必须根据实际码流判断,不能仅凭字母预测所有解码次序。
用 FFprobe 检查实际图像类型
安装支持 H.264 编码的 FFmpeg,并准备一个名为 input.mp4 的本地视频。以下命令适用于常见的 FFmpeg 6.x、7.x 和 8.x,使用 libx264 编码器生成便于观察的样本。
# 生成两秒、每秒六帧的测试视频,固定 GOP 长度为六帧
ffmpeg -f lavfi -i testsrc2=size=320x180:rate=6:duration=2 -an -c:v libx264 -preset medium -bf 2 -g 6 -keyint_min 6 -sc_threshold 0 -pix_fmt yuv420p -y ipb-demo.mp4

# 读取解码后的图像类型、关键帧标记和显示时间
ffprobe -v error -select_streams v:0 -show_entries frame=key_frame,pict_type,best_effort_timestamp_time -of csv=p=0 ipb-demo.mp4
预期结果:第一条命令成功生成 ipb-demo.mp4;第二条命令会输出多行记录,每行依次包含关键帧标记、图像类型和时间戳,例如:
1,I,0.000000
0,B,0.166667
0,B,0.333333
0,P,0.500000
以上仅展示可能出现的前四行,实际帧型分布取决于 libx264 的模式决策,不能把它当作所有运行环境必须完全相同的结果。时间戳单位为秒,输入参数每秒六帧,因此相邻显示时间通常相差约 0.166667 秒。
pict_type 表示 FFprobe 报告的图像类型,key_frame 表示 FFmpeg 标记的关键帧。要进一步观察重排序,可以分别查看 pkt_dts_time、best_effort_timestamp_time 等字段,但必须注意解码输出的帧顺序和原始编码包的存储顺序不是同一回事;不要直接把两组输出的行号当作引用关系。
I 图像为什么不一定能随机访问
随机访问要求解码器从指定位置进入码流后,可以在规定条件下正确恢复目标图像以及后续需要显示的图像。这比单独观察某张图像是不是 I 类型要求更严格。
以 H.264 为例,IDR 图像是一种明确的刷新边界。IDR 使后续图像不能引用 IDR 之前的参考图像,并重置相关参考图像管理状态。普通非 IDR 的 I 图像虽然自身不依赖其他图像的像素数据,但其后续 P/B 图像仍可能引用更早的参考图像。
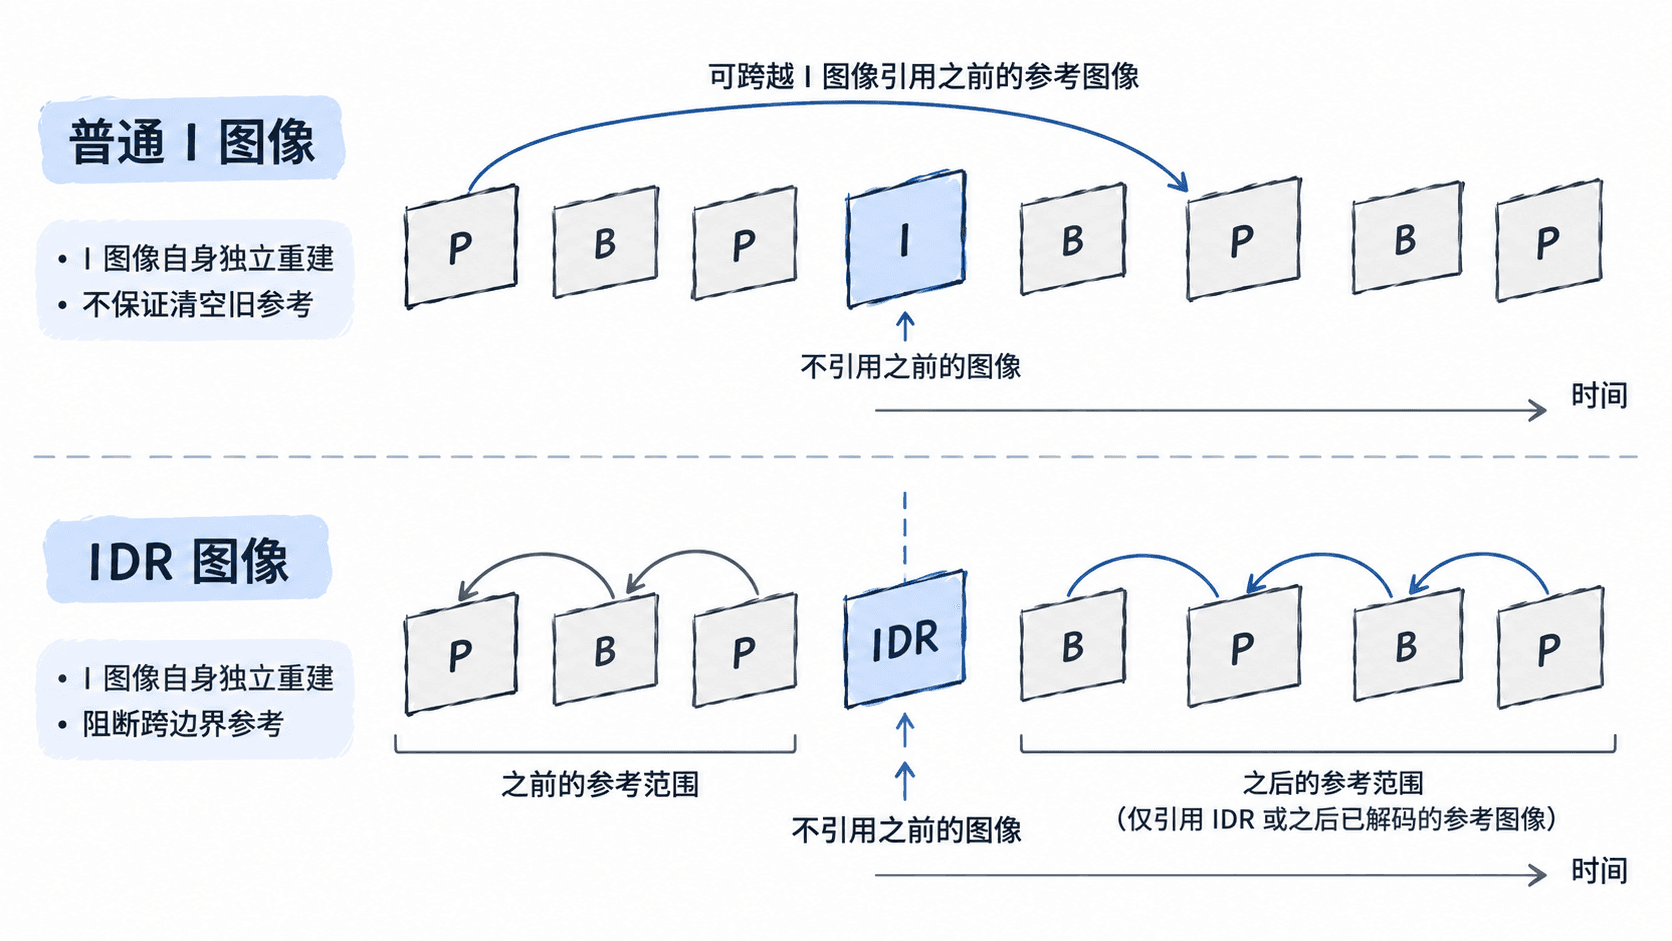
实际检查随机访问能力时,应区分以下条件:
- 当前访问单元是否属于编码标准定义的随机访问结构,例如 H.264 的 IDR,或者 HEVC 的 IDR、CRA 等。
- 解码器在入口处能否获得正确的 SPS、PPS 等必要参数信息。
- 入口之后是否存在需要特殊处理的前导图像,以及哪些图像允许输出。
- 封装容器是否正确标记同步样本,播放器能否定位到对应的访问单元。
HEVC 的 CRA 与 IDR 也不能完全视为等价:CRA 允许特定的前导图像处理情形,随机访问时需要遵守其输出与参考限制。
怎样判断一段 GOP 的引用设计
检查一个 GOP(图像组)时,可以使用下面的顺序:
- 先按显示时间排列所有图像,记录 I/P/B 类型。
- 查清每张帧间预测图像的实际参考目标,而不是看到 B 就默认同时引用前后两张。
- 验证每张被引用的图像是否已经在解码顺序中完成重建。
- 找到真正的随机访问边界,并验证从该处解码不会错误引用边界前不可用的图像。
例如,设计一个 24 fps、每 48 帧设置一个 IDR 的编码方案,名义上的 IDR 间隔为两秒。若实际只允许在这些 IDR 处进入,随机访问起点的时间间隔通常为两秒;但具体的跳转精度还受容器索引和播放策略影响。把 GOP 长度改为 24 帧,可以提供更密集的预定刷新入口,但也可能增加码率。
最终判断应分成三个问题:当前图像如何预测、解码前必须准备哪些参考图像、码流能否从这里安全进入。I/P/B 回答第一个问题,实际引用图和解码顺序回答第二个问题,随机访问结构及其约束回答第三个问题。