
编码与格式 / 系统课时
沿视频编码链定位压缩环节
沿视频编码链定位压缩环节
一段原始视频为什么能从几百 MB 压缩到几 MB?要回答这个问题,需要沿着编码器内部的数据变化逐步观察。本课以混合视频编码器为例,追踪原始帧、预测残差、变换系数、量化结果和压缩码流,解释每一步如何减少数据,以及编码器为什么必须在内部重建图像。
学习目标
- 说清预测、变换、量化和熵编码各自解决的问题。
- 根据具体数值计算预测残差与量化误差,定位有损压缩发生的位置。
- 理解编码器内部重建与解码器重建之间的关系,并能用 FFmpeg 初步检查码流。
从原始帧进入编码链
假设输入视频为 1920×1080、30 fps、8-bit、YUV 4:2:0。每帧包含 1920×1080 个亮度样本,以及总计约一半数量的色度样本,因此未压缩数据量约为:
每秒原始数据约为 93.3 MB,按十进制单位计算约 746.5 Mb/s。这里尚未计算文件封装开销。若编码后的平均码率是 4 Mb/s,则数据率约为原始数据率的 0.54%,但画质是否可接受还需要实际检查。
典型的 H.264、HEVC 混合编码器并不直接压缩整张原始图像,而是先利用已经掌握的像素信息进行预测,只编码预测无法解释的差异以及必要的控制信息。
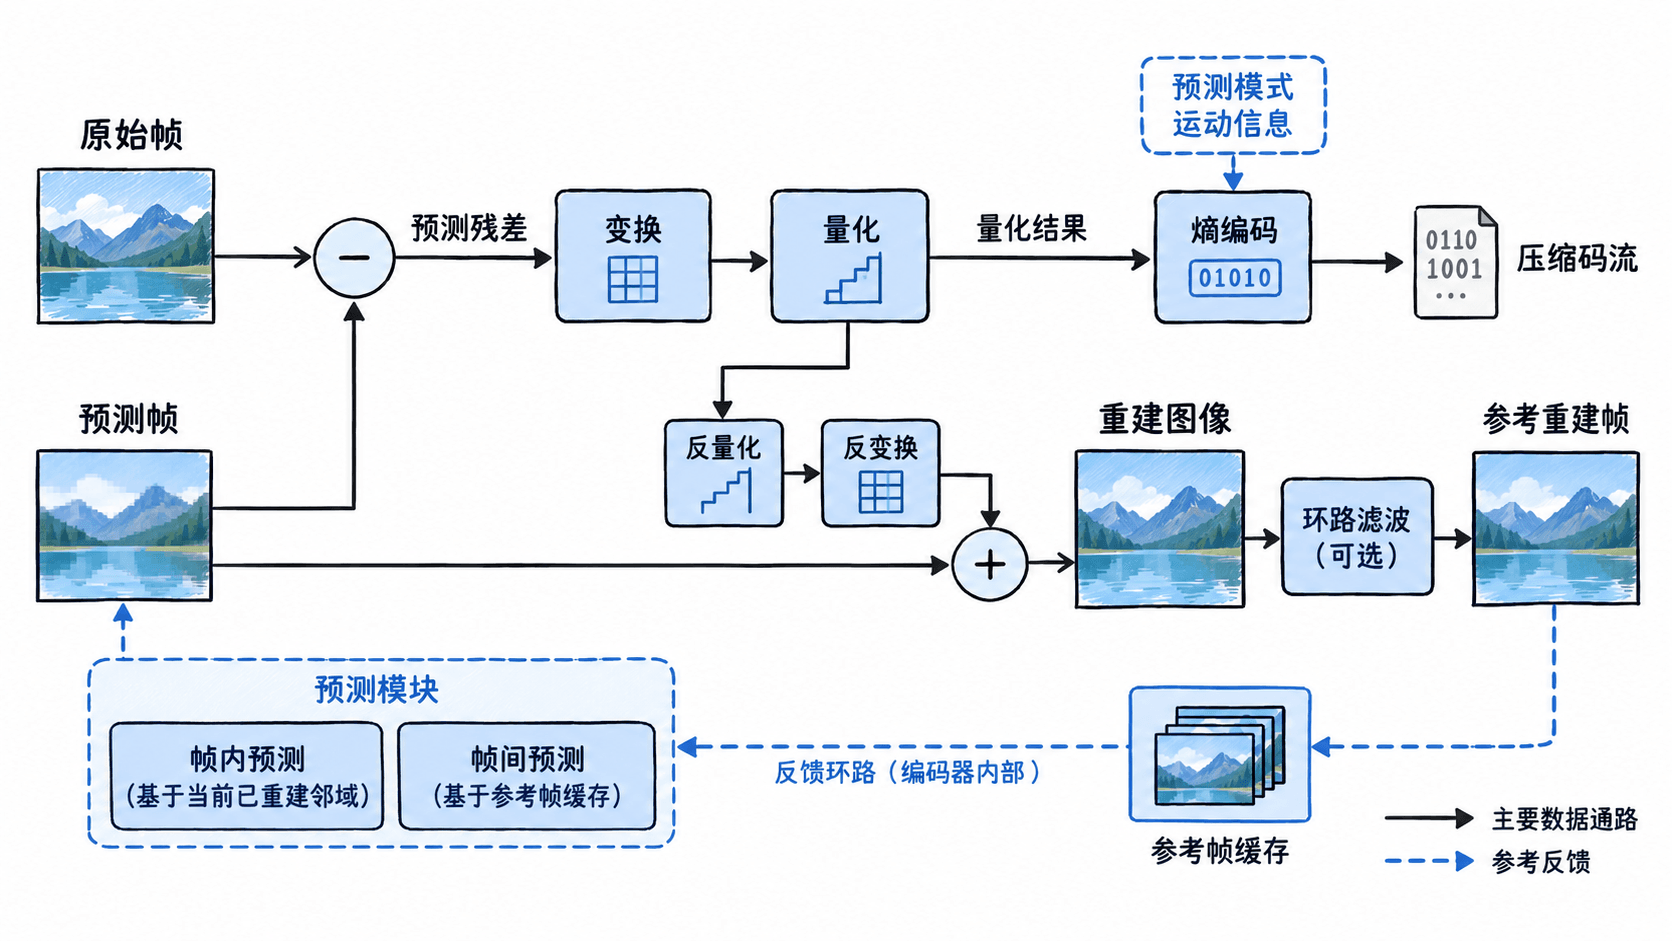
沿图中的主路径,可把压缩机制分成四段:预测减少需要表达的差异,变换集中残差信号,量化降低表示精度,熵编码利用符号的统计规律减少实际比特数。不同编码标准的块划分、变换与编码工具有所差异,但这一主线仍然适用。
预测残差如何减少冗余
预测器尝试使用已知信息估计当前像素。帧内预测利用同一图像中已重建的邻近样本;帧间预测则利用参考帧中的重建样本,通过运动补偿生成预测块。
编码器计算的残差为:
其中 是原始样本, 是预测样本, 是有符号残差。假设一个 2×2 亮度块的原始值与预测值分别为:
| 位置 | 原始值 | 预测值 | 残差 |
|---|---|---|---|
| 左上 | 102 | 100 | 2 |
| 右上 | 104 | 103 | 1 |
| 左下 | 101 | 100 | 1 |
| 右下 | 103 | 102 | 1 |
这个块的原始亮度集中在 100 左右,而残差仅为 1 或 2,说明预测已经消除了大部分局部变化。实际编码效率还取决于残差分布、预测模式及运动信息的编码成本,不能仅凭残差数值大小推断最终文件大小。
对于一个静止背景、人物缓慢移动的镜头,帧间预测通常可以复用大量参考图像信息;遇到突然切镜、遮挡或快速变形时,预测误差往往增大,编码器可能选择帧内预测或其他更合适的块模式。
变换、量化与熵编码分别做了什么
预测之后的残差仍然是一组空间域样本。变换阶段把残差信息映射为系数,使能量更容易集中于少数系数。H.264 和 HEVC 通常使用整数化变换,而不是简单地对每个块直接执行浮点 DCT。
为了理解量化,先使用一个简化标量量化例子。假设某组变换系数为 24、7、-3、1,量化步长设为 8,采用四舍五入到最近整数的示意规则:
| 变换系数 | 量化整数 | 反量化系数 | 误差 |
|---|---|---|---|
| 24 | 3 | 24 | 0 |
| 7 | 1 | 8 | 1 |
| -3 | 0 | 0 | 3 |
| 1 | 0 | 0 | -1 |
量化后出现两个零,意味着后续更容易使用少量符号表达这组系数。反量化却无法确定原来的 -3 和 1,它们已经被映射成零,这就是不可逆信息损失。
在 H.264 中,亮度 QP 每增加 6,量化步长通常约增大一倍。因此,QP 22 与 QP 28 通常对应不同的保真度和压缩率,但实际码率不会简单地减半。
最后,熵编码对量化系数、预测模式、运动信息等语法元素进行紧凑表示。例如 H.264 可以使用 CAVLC 或 CABAC,具体取决于编码配置。熵编码本身是无损的:解码器能够从合法码流中恢复被编码的量化符号,但不能恢复量化之前丢失的精度。
编码器为什么还要重建图像
一个常见误解是:编码器拿原始帧预测下一帧,而解码器拿解码后的帧预测下一帧。这两种参考如果不同,预测误差就会不断累积,产生编码端与解码端的参考漂移。
正确做法是在编码器内部建立与解码器对应的重建路径:
- 对当前块的量化系数执行反量化、反变换,得到重建残差。
- 将重建残差加回预测块,得到重建样本,并按标准执行必要的裁剪及其他规范操作。
- 按编码标准和已启用的工具进行环路滤波,形成可供后续预测使用的重建参考信息。
- 后续块或后续帧使用相应的已重建信息继续预测,而不是直接使用原始像素作为解码参考。
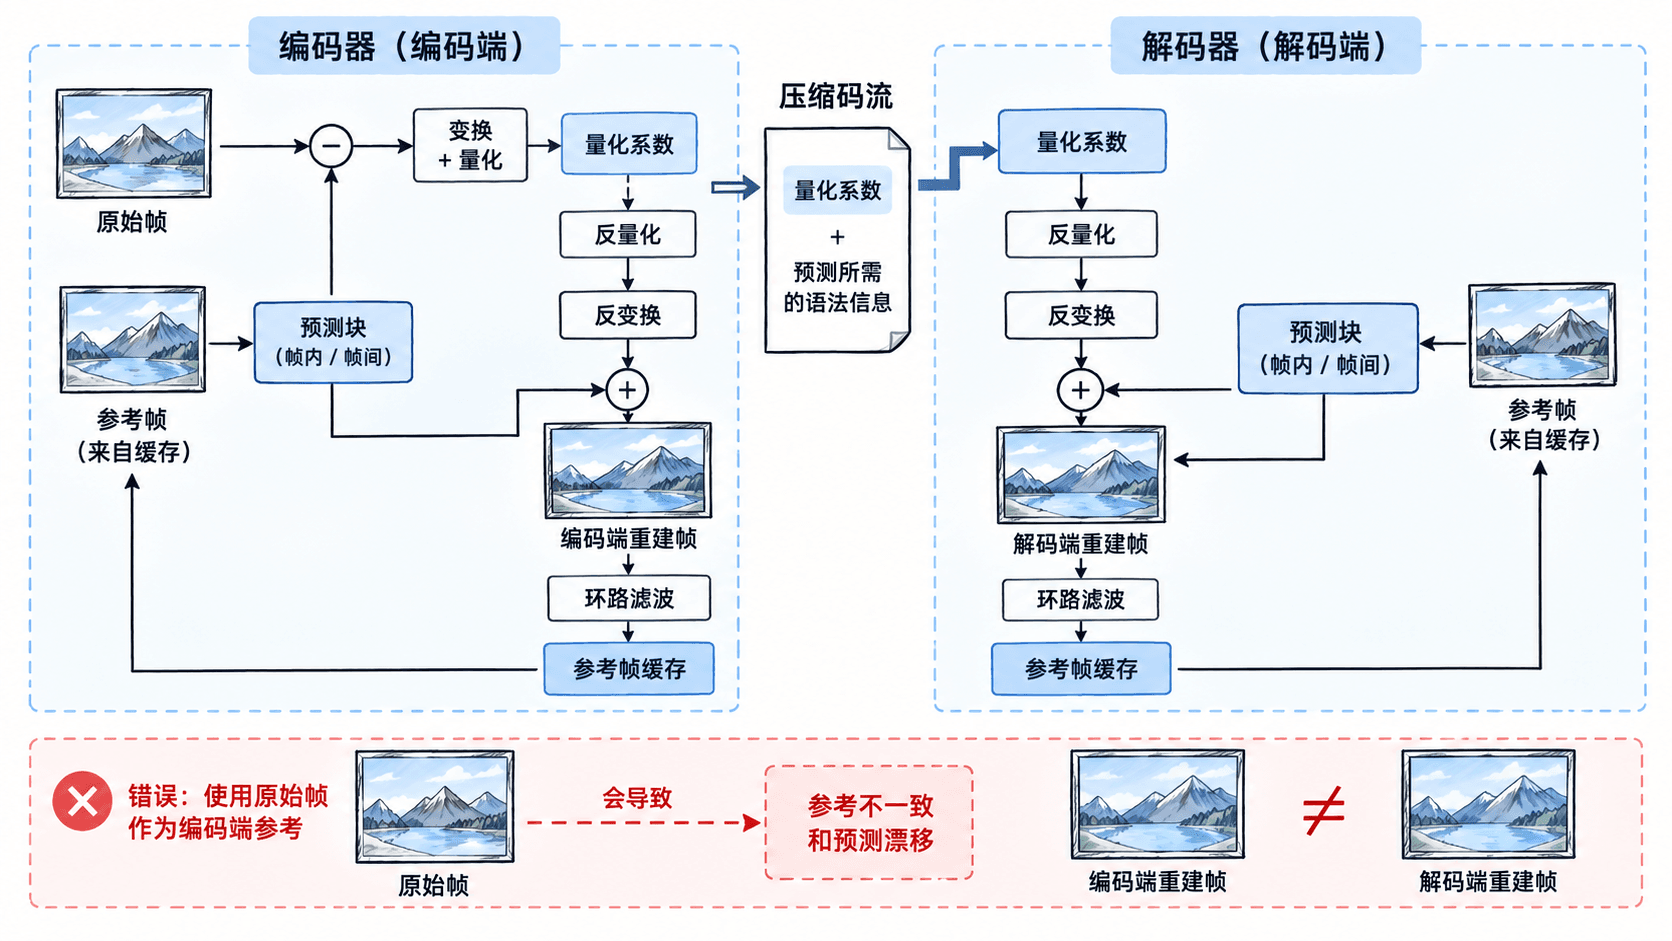
用单个像素说明:原始值为 103,预测值为 100,残差为 3。若量化与重建后得到的残差是 2,则重建值为 102。编码器下一次预测需要使用相应的重建值 102,而不能擅自改用原始值 103。
实际重建过程还有帧内预测依赖、滤波边界与标准规定的整数运算。只要编码器和符合标准的解码器使用一致的规范重建过程,就能避免由参考不一致导致的预测漂移。这里所说的一致性,是指规范要求的解码重建一致,而不是重建图像等于原始图像。
用 FFmpeg 检查压缩码流
下面使用 FFmpeg 生成一段可重复测试的视频,再借助 ffprobe 检查压缩结果。适用环境为安装了 FFmpeg、ffprobe 且 FFmpeg 构建中包含 libx264 编码器的系统。
先执行以下命令,生成 5 秒、1280×720、30 fps 的 H.264 视频:
ffmpeg -f lavfi -i testsrc2=size=1280x720:rate=30 -t 5 -an -c:v libx264 -preset medium -crf 23 -pix_fmt yuv420p -y codec-demo.mp4预期结果:生成 codec-demo.mp4,视频编码为 H.264,正常情况下包含约 150 帧。控制台会输出编码进度及 libx264 统计信息,最终文件大小随 FFmpeg 版本、编码器构建与测试内容变化。
再读取码流基本信息:
ffprobe -v error -select_streams v:0 -show_entries stream=codec_name,width,height,pix_fmt,r_frame_rate,nb_frames -of json codec-demo.mp4预期输出:
{
  "programs": [],
  "streams": [
    {
      "codec_name": "h264",
      "width": 1280,
      "height": 720,
      "pix_fmt": "yuv420p",
      "r_frame_rate": "30/1",
      "nb_frames": "150"
    }
  ]
}
这里展示的是常见版本的示意输出;不同 ffprobe 版本可能省略 programs 或增加其他容器字段,应以 streams 中的核心参数为准。
若想观察帧类型,可执行:
ffprobe -v error -select_streams v:0 -show_entries frame=key_frame,pict_type -of csv=p=0 codec-demo.mp4预期结果:输出逐帧记录,可见 I、P,也可能有 B 帧;具体排列取决于编码器设置。I 帧表示采用帧内编码的图像类型,P、B 帧可包含帧间预测,但不能把这些类型直接等同于某个固定压缩率。
需要注意,ffprobe 展示的是码流语法和容器信息,并不会自动导出编码器内部每个块的原始预测残差、变换系数与量化误差。若要逐块定位这些内部环节,需要使用具有编码过程日志、调试输出或可修改源码的编码器实现。
最终应能把观察结果对应回编码链:原始帧提供待编码信息,预测减少冗余,变换重排残差信息,量化引入主要有损误差,熵编码生成紧凑码流,而内部重建保证编码端使用与解码端一致的参考信息。