
编码与格式 / 系统课时
比较 CABAC 与 AV1 算术编码
比较 CABAC 与 AV1 算术编码
同样一个视频语法符号,H.264/H.265 的 CABAC 通常将其转换为二进制决策后逐位编码,而 AV1 可以直接对多个可能取值进行算术编码。理解这两条路径,就能解释概率模型、压缩效率与计算开销之间的关系,并知道为什么不能只凭编码方式判断哪种标准更快。
学习目标
- 理解 CABAC 的二值化、上下文建模与算术编码过程。
- 掌握 AV1 多符号范围编码和自适应概率更新的基本思路。
- 通过数值案例比较两种方案的理论码长、处理次数与实现代价。
CABAC 如何编码一个多值符号
CABAC 是 Context-Adaptive Binary Arithmetic Coding,即上下文自适应二进制算术编码。H.264/AVC 的部分 Profile 及 H.265/HEVC 使用这一技术;H.264 Baseline Profile 不使用 CABAC。
CABAC 的主要处理过程包括三个环节:
- 二值化:将具有多个取值的语法元素映射成由 0 和 1 构成的 bin 序列。
- 上下文建模:根据语法位置、邻近块信息等条件选择概率状态。
- 算术编码:依据当前概率把编码区间划分为两个子区间,选择对应区间并更新状态。
例如,某个语法元素有 0、1、2、3 四种取值。为了理解二值化,可以暂时采用固定两位映射:0 对应 00,1 对应 01,2 对应 10,3 对应 11。
当输入值为 2 时,算术编码器需要处理两个 bin:先处理 1,再处理 0。实际 CABAC 的二值化方式由具体语法元素决定,可能使用一元码、截断一元码或其他规定形式,不能把这个两位映射当成 H.264/H.265 的通用规则。
CABAC 的常规编码路径使用有限精度的概率状态与区间表,而不是每次都执行完整浮点概率乘法。它还具有 bypass 编码模式,可以更低的上下文建模开销处理某些 bin。
AV1 为什么采用多符号编码
AV1 使用上下文自适应的多符号算术范围编码。对于一个具有 N 种可能取值的符号,编码器可以使用一份累积分布函数(CDF)描述各取值的概率,并通过一次符号编码操作选择对应区间,不必先统一拆成二进制 bin 序列。
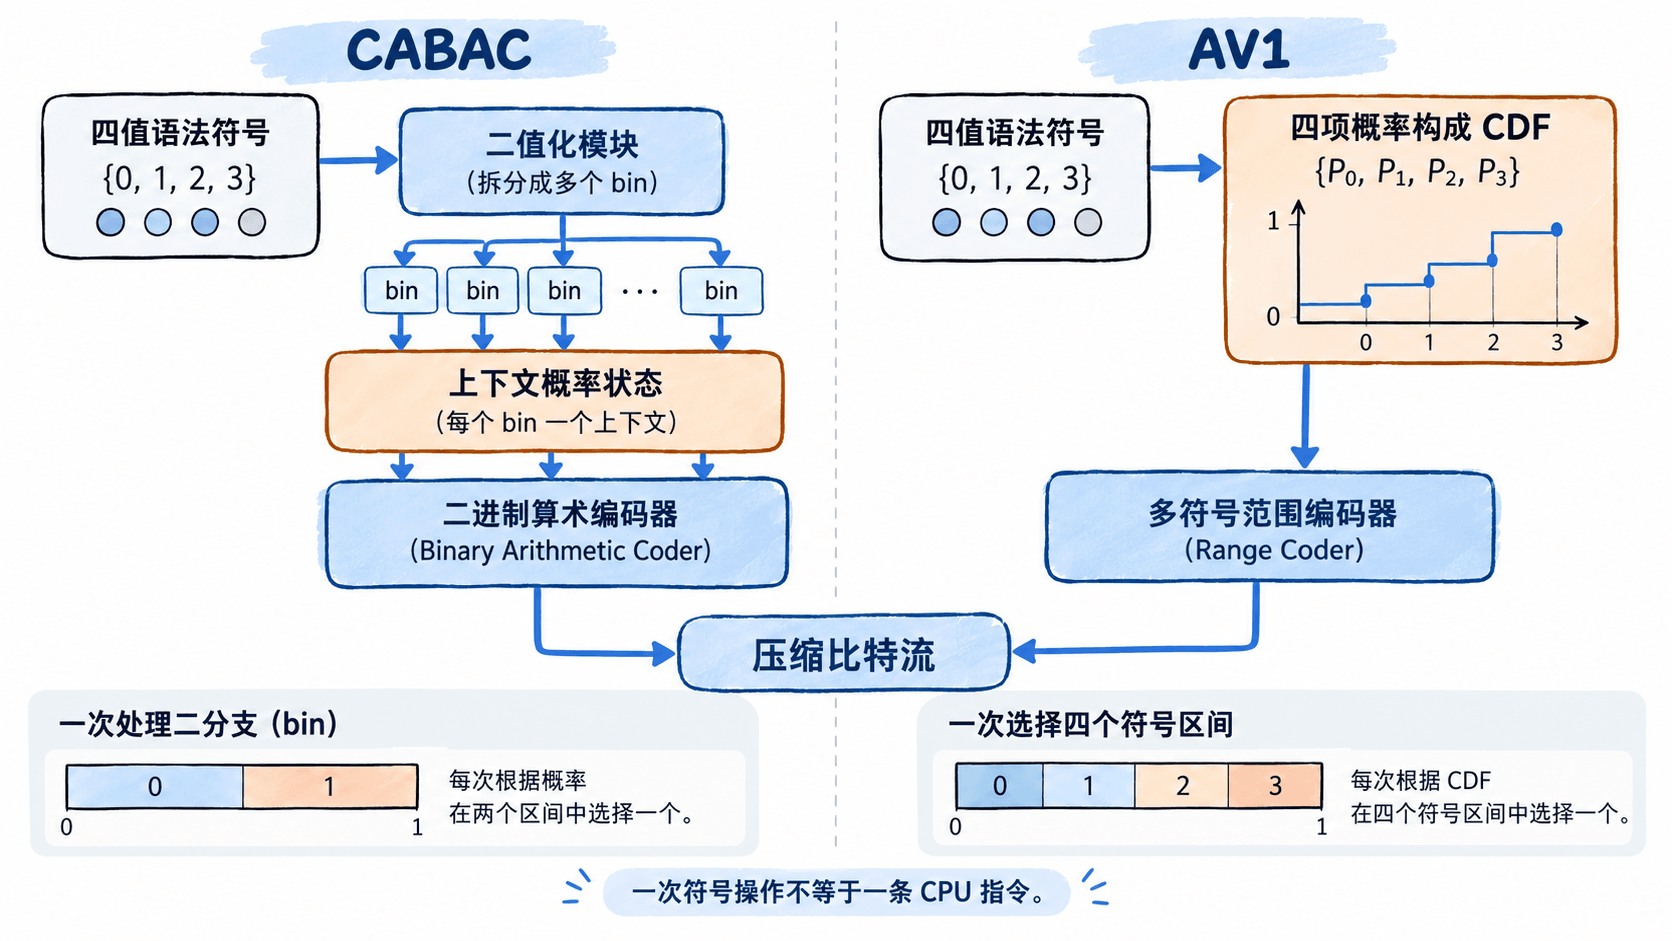
假设当前上下文存在四个候选符号 A、B、C、D,概率分别为 0.5、0.25、0.125、0.125。理想化地将初始区间设为 [0,1),可以划分为:
| 符号 | 概率 | 对应区间 |
|---|---|---|
| A | 0.5 | [0,0.5) |
| B | 0.25 | [0.5,0.75) |
| C | 0.125 | [0.75,0.875) |
| D | 0.125 | [0.875,1) |
编码 C 时,范围编码器选中 [0.75,0.875),再经过区间归一化和比特输出等操作继续处理下一个符号。这里的区间仅用于原理演示,并非 AV1 实际整数范围编码器的逐位执行结果。
AV1 规范使用基于 15 位概率尺度的 CDF 表示,并为每个符号保留非零概率。解码时根据区间定位符号,之后按规范更新 CDF;编码器必须使用对应的概率更新规则,才能保持编解码同步。
概率更新怎样影响压缩率
上下文自适应意味着编码器不会一直使用固定的概率模型。当近期符号分布发生变化时,模型会向新观察到的分布调整。
例如,最初四个符号都具有 25% 的概率,随后连续出现大量 A。适应后的模型会逐渐提高 A 的概率,使其消耗的平均码长降低。
从信息论角度,概率为 的符号,其理想信息量为:
若 A 的概率由 0.25 增至 0.5,则其理想码长由 2 bit 降至 1 bit。这里计算的是信息量,不表示每次算术编码恰好输出一个完整比特;实际码流还受整数精度、归一化及模型变化影响。
两种方案的更新对象不同:
| 比较项 | CABAC | AV1 多符号编码 |
|---|---|---|
| 概率对象 | 二进制 bin 的上下文状态 | 多值符号的 CDF |
| 模型更新 | 按 bin 更新相关上下文状态 | 按符号更新对应 CDF,部分路径可禁用更新 |
| 单次符号处理 | 多值语法元素可能需要多个 bin | 多值符号可以直接编码 |
| 主要代价 | 二值化、上下文选择及逐 bin 处理 | CDF 查询、区间计算及概率更新 |
AV1 的 CDF 更新并不是简单累加历史频数。规范根据符号取值、累计符号数量和字母表大小确定更新步长,累计计数最多增长到 32;因此模型既能响应近期变化,也不会无限累加历史计数。
用四符号案例比较处理开销
考虑一个理想化的独立符号源,概率分布为 A=0.5、B=0.25、C=0.125、D=0.125。
其理论平均信息量为:
如果 CABAC 使用一个假设的前缀二值化方案:A=0、B=10、C=110、D=111,那么平均需要处理的 bin 数量为:
这个示例中,CABAC 平均处理 1.75 个 bin,而多符号编码平均执行 1 次符号编码操作。两者都可能接近 1.75 bit/符号的理论下界。
因此,多符号编码减少了逐 bin 的串行处理机会,但一次多符号操作可能涉及更多区间边界判断和 CDF 更新。不能由操作次数直接推导 CPU 周期数或解码帧率。
实际视频的熵编码效率还受到预测质量、变换系数分布、上下文设计及语法结构影响。即使 AV1 在某个序列上生成更小的码流,也不能把全部收益归因于多符号算术编码。
怎样判断两种设计的工程取舍
如果目标是理解算法差异,可以优先检查三个指标:每个语法元素需要多少次编码决策、每次决策涉及多少概率状态、最终产生多少比特。
如果要做真实性能测试,则应固定测试机器、解码器版本、线程数量和测试视频,并分别记录吞吐量与码流大小。H.265 和 AV1 的完整解码速度不能直接充当 CABAC 与多符号编码器的独立性能对比,因为帧内预测、运动补偿、变换及环路滤波也会产生开销。
一个可执行的纸面练习是:使用 A=50%、B=25%、C=12.5%、D=12.5% 的概率分布,分别写出固定两位编码与前缀编码的平均二进制长度。固定两位方案为 2 bit/符号,前缀方案为 1.75 bit/符号,差值为 0.25 bit/符号。这说明符号表示与概率分布的匹配程度会影响处理和编码效率,但不能把前缀码的结果直接视为 CABAC 的实际输出。
在工程判断中,CABAC 的二进制概率状态和成熟硬件实现具有优势;AV1 的多符号编码则提供了直接利用多值概率分布的方式。具体压缩收益与吞吐性能必须以相同约束下的实现测量为准。