
编码与格式 / 系统课时
通过率失真代价比较预测模式
通过率失真代价比较预测模式
面对同一图像块,最接近原始像素的预测模式不一定产生最小的视频码流。本课通过一个包含失真、残差和编码比特数的具体算例,建立率失真代价函数,比较多种帧内预测模式,并理解拉格朗日乘子如何影响编码器的最终选择。
学习目标
- 理解失真 、码率 与率失真代价 的含义。
- 使用相同的量化和重建条件,计算并比较多个预测模式的代价。
- 解释拉格朗日乘子变化时,编码器为什么会切换预测模式。
为什么预测误差最小不等于编码最优
在帧内编码中,编码器可以对同一个图像块尝试不同方向的预测。例如,使用上方参考像素生成预测值,或者沿水平、垂直、角度方向进行预测。不同模式会产生不同残差,也会影响变换、量化和熵编码的结果。
如果只比较原始块与预测块之间的平方误差,可能选中一个预测很准、但模式信令或量化后残差需要较多比特的方案。实际编码还必须考虑最终重建质量和所消耗的比特数。
例如,对同一个块测试三种模式,得到如下假设结果。失真统一采用重建块相对原始块的平方误差和(SSE),比特数包含模式相关语法及其残差编码开销。
| 预测模式 | 重建失真 | 编码比特数 |
|---|---|---|
| 垂直预测 A | 80 | 120 |
| 水平预测 B | 110 | 70 |
| 角度预测 C | 65 | 170 |
模式 C 的重建失真最小,但它需要 170 bit;模式 B 虽然失真较大,却只需要 70 bit。如果没有统一的比较标准,就无法判断多花费的比特是否值得。
建立率失真代价函数
编码器通常采用拉格朗日形式的率失真代价:
其中:
- :原始像素与最终重建像素之间的失真,常见选择包括 SSE,某些决策阶段也使用 SATD 等代理指标。
- :编码该候选模式所需的比特数,实际编码器可以使用熵编码器估算值。
- :拉格朗日乘子,决定比特开销在总代价中的权重。
- :综合代价;在同一决策条件下,选择 最小的候选模式。
对于包含 个采样值的块,SSE 可以写为:
是原始采样值, 是经过预测、残差量化和反量化重建后的采样值。这里不能直接用预测像素代替重建像素,否则计算的是预测误差,不一定代表实际编码后的失真。
越大,增加一个比特带来的代价越高,编码器越倾向节省码率; 越小,编码器越愿意使用更多比特改善重建质量。其数值必须与失真度量及比特估算方式匹配,不能脱离实现直接比较。
对三个预测模式进行数值比较
沿用前面的候选数据,设 。分别计算:
| 模式 | 失真项 | 码率惩罚项 | 总代价 |
|---|---|---|---|
| A | 80 | 60 | 140 |
| B | 110 | 35 | 145 |
| C | 65 | 85 | 150 |
最终选择模式 A。它既不是失真最低的模式,也不是比特最少的模式,而是在当前权重下综合代价最低的方案。
这也说明比较必须公平:三个模式应使用同一原始块、相同的重建质量定义、兼容的量化条件,并计入同一范围内的编码语法开销。不能让 A 的 包含残差数据,却只统计 B 的模式标识比特。
拉格朗日乘子如何改变决策
保持三个候选的 和 不变,只改变 ,可以观察模式切换。以下是固定候选数据的教学算例,并非重新量化后的视频编码结果。
| 最优模式 | ||||
|---|---|---|---|---|
| 0.1 | 92 | 117 | 82 | C |
| 0.5 | 140 | 145 | 150 | A |
| 1.0 | 200 | 180 | 235 | B |
当 时,编码器重视质量,选择失真最小的 C;当 时,码率惩罚显著增加,选择比特最少的 B。
还可以计算两种模式的切换临界点。例如 A 与 B 代价相等时:
得到 。在只比较 A 和 B 的前提下,低于 0.6 时 A 更优,高于 0.6 时 B 更优;等于 0.6 时两者代价相同,需要由编码器的平局规则决定。
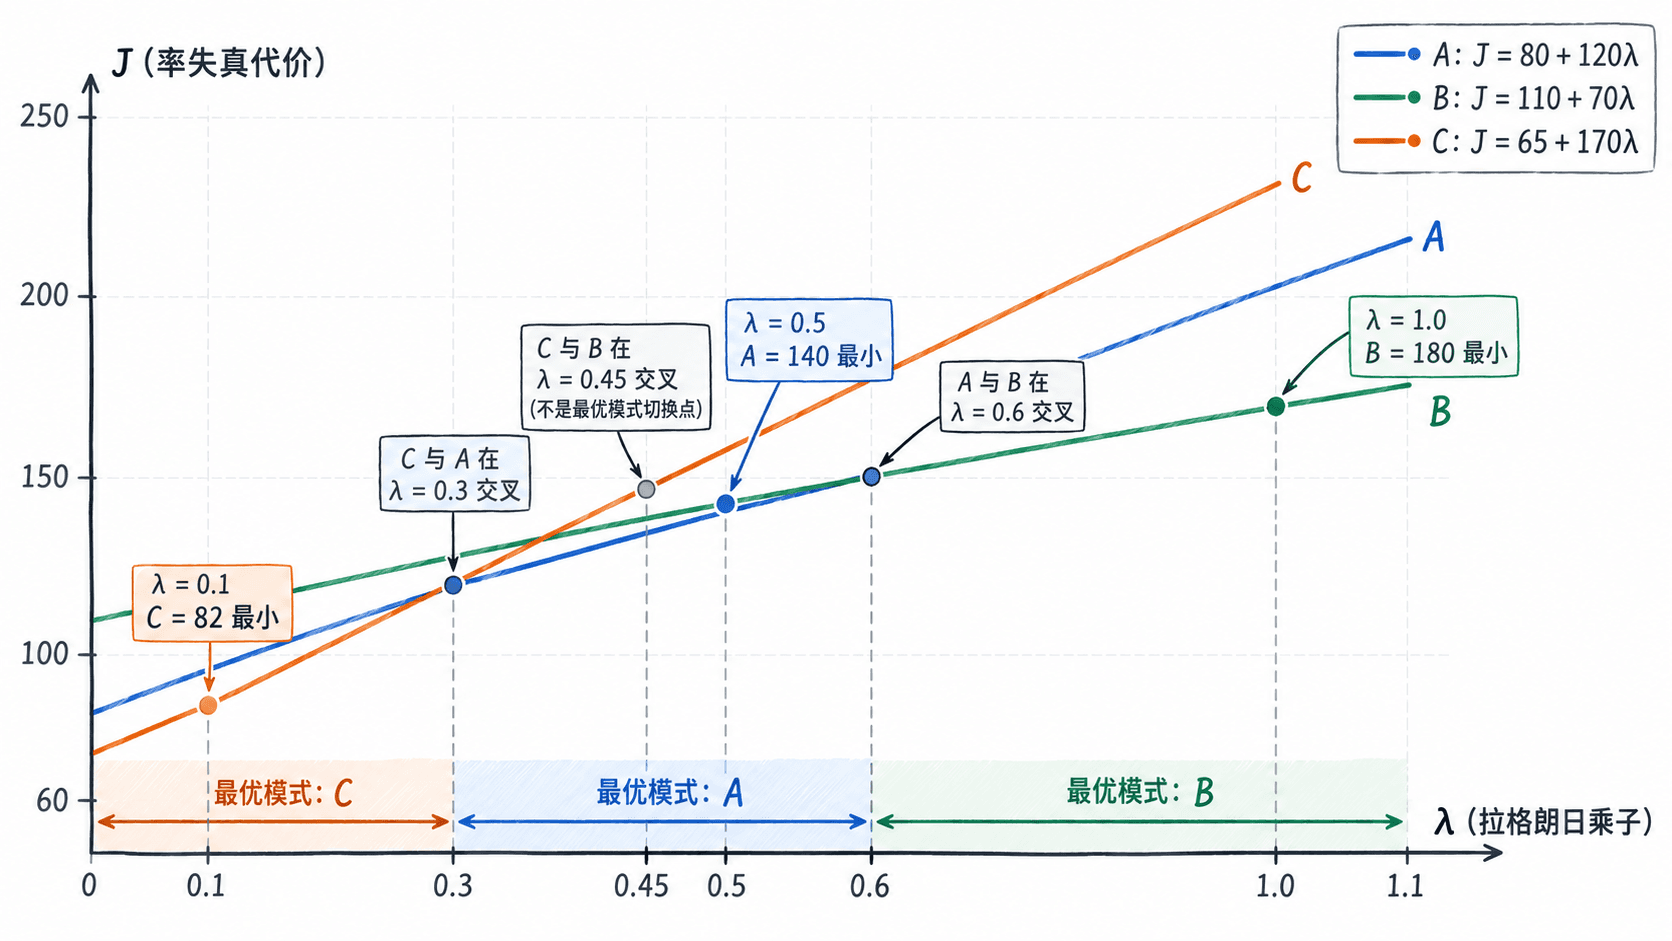
这张图中的每条直线代表一种固定候选模式,斜率就是它的编码比特数 。比特越多,直线随 增长得越快。编码器在每个 位置取三条线中最低的一条,便得到最优模式的切换区域。
编码器如何实际执行模式决策
实际帧内模式决策不是先得到一组固定失真数值,再随意调整权重。对于每个候选模式,编码器需要运行与重建有关的步骤,才能获得可比较的 和 。
- 从当前块已重建的邻近样本生成候选预测块。
- 计算原始块与预测块的残差,对残差执行变换和量化。
- 对量化系数反量化、反变换,再与预测块相加,得到重建块。
- 根据重建块与原始块计算失真,并估算模式语法、量化系数等相关比特数。
- 使用相同的代价规则计算 ,选出当前候选集合中代价最低的模式。
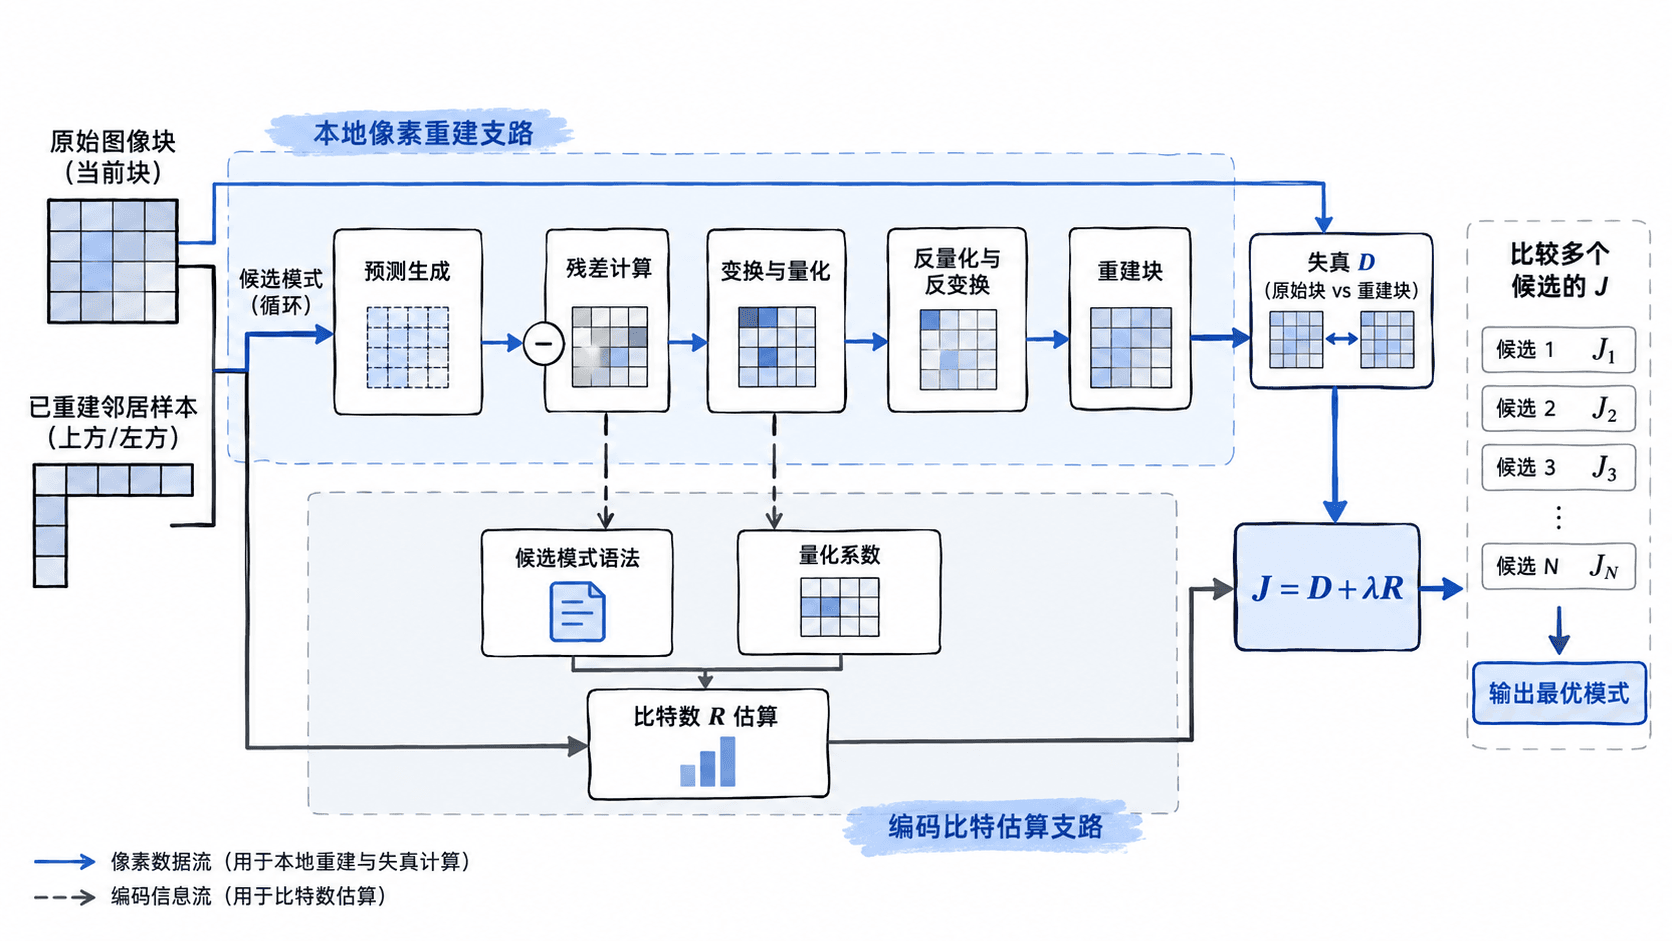
在工程实现中,完整遍历所有预测方向并精确执行熵编码估算可能很耗时,因此常先用 SAD 或 SATD 加估算比特做粗筛,再对少量候选执行更精细的重建与率失真计算。粗筛的代理代价不应与完整重建后的 SSE 代价直接混排。
同样需要注意,邻近块的可用性、量化参数、上下文自适应熵编码状态和色度处理都可能影响决策。评价候选时应保持比较条件一致,并按编码器的规则处理相关状态,避免某个候选的试算影响后续候选。
判断结果是否可信
可以用三个检查项审核一份模式决策结果:
- 重建一致性:失真必须来自该候选实际产生的重建样本,而不是未经量化的预测残差;若使用 SATD 等代理指标,应明确其用途。
- 比特口径一致:所有候选都计入相同范围的模式信息和残差开销,不能混用完整码流比特与局部估算值。
- 最小代价可复算:代入同一 后,选中模式的 不大于其他候选;若相等,应有确定的平局规则。
尝试将上表中的 改为 0.4,可计算出 A 为 128、B 为 138、C 为 133,因此仍选择 A。这个练习既检查公式代入是否正确,也能验证模式选择并非单纯按最低失真或最低码率排序。
率失真决策最终比较的是相同条件下的重建失真与编码成本。只要候选的度量口径一致,并正确设置与量化条件匹配的 ,编码器就能把不同预测模式放到同一代价尺度上进行选择。