
编码与格式 / 系统课时
用概率上下文理解熵编码
用概率上下文理解熵编码
同样是记录预测模式和量化系数,为什么有的符号只需要很少的比特,有的却需要更多?答案在于符号出现的概率。通过具体的概率表和编码算例,你将理解视频编码器如何利用上下文减少码率,以及为什么熵编码本身不会损失画质。
学习目标
- 理解符号概率与平均编码长度的关系,能够计算简单的编码开销。
- 通过预测模式和量化系数案例,理解上下文建模与算术编码的基本思想。
- 区分有损量化与无损熵编码,判断哪些环节会产生不可逆误差。
为什么高频符号可以用更少比特
视频编码器并不是直接把每个预测模式或系数都用固定长度写入码流,而是先把语法元素转换成可编码的符号,再利用它们出现概率的差异进行压缩。
假设某个简化编码场景只有四种符号,统计得到以下分布:
| 符号 | 出现概率 | 固定长度编码 | 示例变长编码 |
|---|---|---|---|
| A | 50% | 00 | 0 |
| B | 25% | 01 | 10 |
| C | 12.5% | 10 | 110 |
| D | 12.5% | 11 | 111 |
固定长度方案每个符号都需要 2 bit。右侧变长码是一个前缀码,没有任何完整码字是另一个码字的开头,因此可以无歧义地逐个解码。
变长编码的平均长度为:
如果编码 800 个符号,并且频率恰好符合这张表,固定长度需要 1600 bit,示例变长码只需要 1400 bit,节省 12.5%。这里暂不计入概率模型、码流封装等额外开销。
从信息论角度看,概率为 的符号,其理想信息量为 bit。概率越高,信息量越低。熵编码就是利用这个规律,使整体平均码长接近符号分布的熵,而不是让每个符号都使用相同的比特数。
上下文为什么能进一步减少码率
仅统计全局概率还不够。视频里的符号分布往往取决于相邻块、预测方向、系数位置,以及已经编码的其他语法元素。上下文建模就是利用编码器和解码器都能够获得的条件信息,估计当前符号出现的概率。
以一个经过简化的帧内预测模式编码过程为例,假设当前块的候选预测模式受左侧和上方已重建块的模式影响。
| 条件 | 常用候选模式命中概率 | 未命中概率 |
|---|---|---|
| 不区分邻块,使用全局模型 | 60% | 40% |
| 邻块预测方向相近 | 90% | 10% |
| 邻块预测方向差异较大 | 55% | 45% |
这些数字是教学用的假设数据,并非某个视频编码标准规定的概率。
在方向相近的条件下,命中候选模式的理想信息量为 bit;如果仍使用全局模型,则为 bit。单个符号在实际码流中不能简单理解为写入 0.152 bit,但跨多个符号进行算术编码时,可以实现接近这种平均开销的效果。
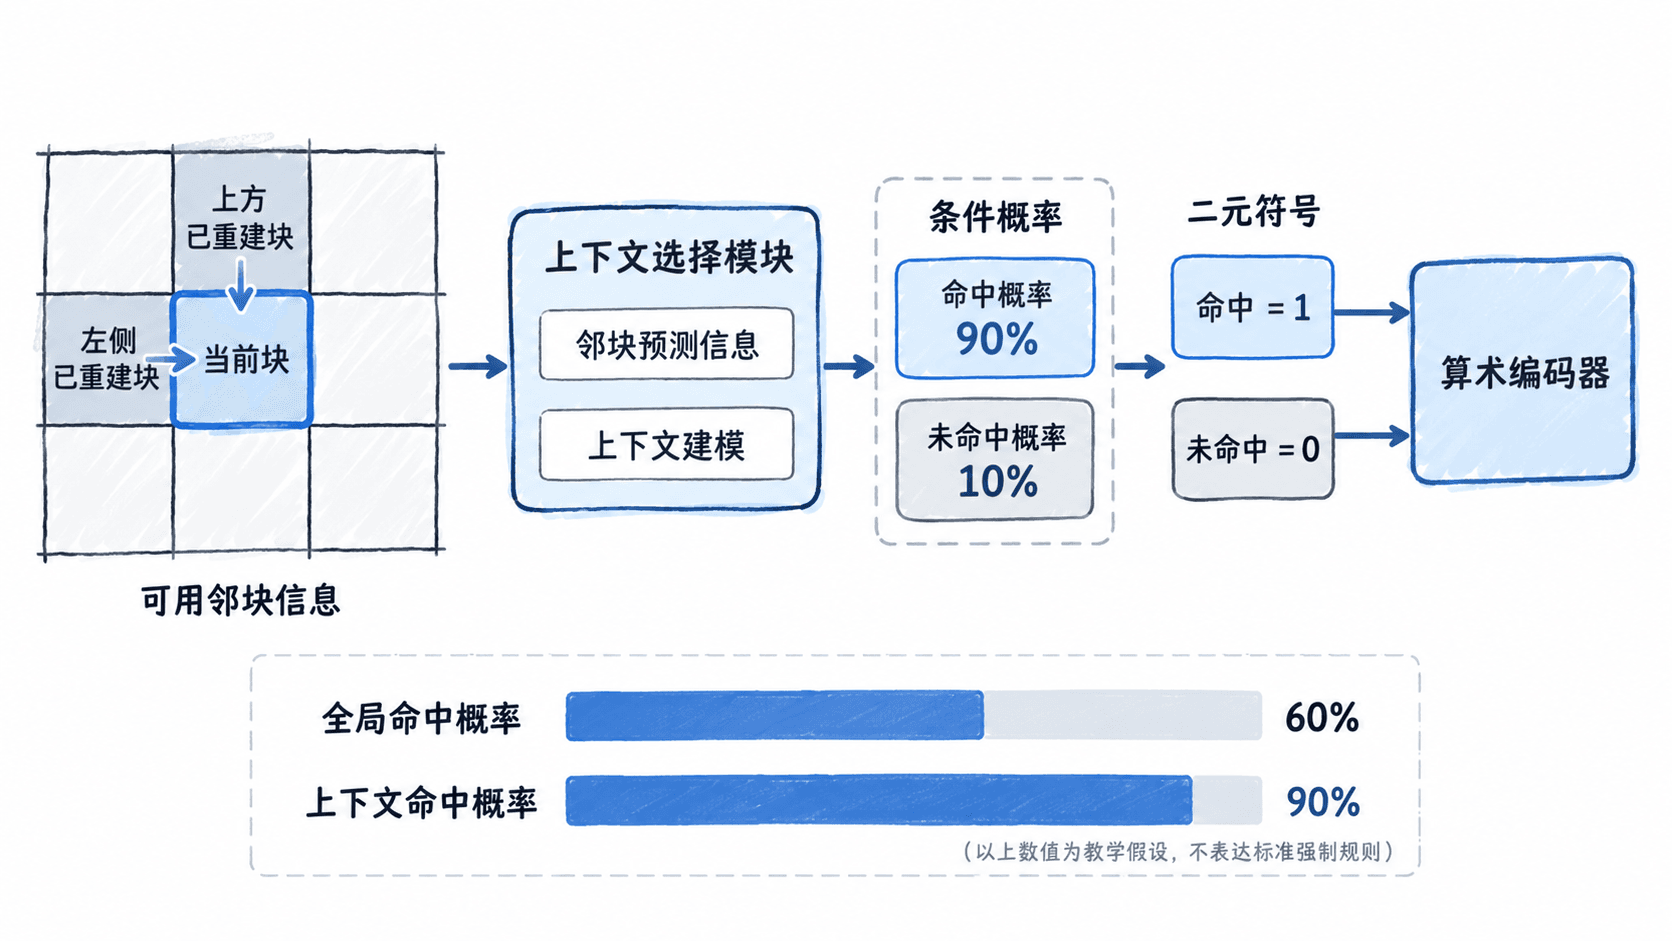
需要注意,H.264/AVC、H.265/HEVC 等标准对预测模式的候选构造和语法编码有具体规则,并不等于直接把左、上块的模式编号当作一个通用概率表。这里的例子解释的是条件概率思想,而不是某个标准的逐字段实现。
量化系数如何形成不同概率上下文
经过变换与量化后,残差系数通常包含大量零值,非零系数也常以较小绝对值为主。编码器可以利用这一分布,将系数相关语法元素拆解为是否非零、绝对值大小和符号位等信息进行编码。
假设某组量化系数为:
[0, 0, 0, 1, 0, -1, 0, 3]
这 8 个系数中有 5 个零值,零值比例为 62.5%。因此,表达系数是否非零的二元符号具有明显的概率偏向。
再假设按系数位置分组后,得到以下统计:
| 上下文 | 零值概率 | 非零概率 | 编码判断 |
|---|---|---|---|
| 高频位置 | 90% | 10% | 零值更容易预测 |
| 低频位置 | 55% | 45% | 非零情况更常见 |
对于零值事件,高频位置的理想信息量约为 0.152 bit,而低频位置约为 0.862 bit。采用不同上下文模型,可以避免让这两类位置共用不合适的概率估计。
上述系数数组只是一个说明概率分布的示例。真实编码器对残差系数还会按照标准规定的扫描、显著性标记、绝对值级别等语法进行处理;不同标准的上下文划分和编码方式不完全相同。
另外,不能认为所有符号都具有强烈概率偏向。例如,在缺少可利用相关性的情况下,正负符号可能接近各占一半,此时符号位的平均信息量接近 1 bit,进一步压缩的空间很小。
算术编码如何利用概率区间
前缀码通常为一个完整符号分配整数长度的码字,而算术编码使用一个不断缩小的数值区间来表示整个符号序列,因此可以更细致地利用概率差异。
为了便于计算,假设只有 A、B 两个符号,概率分别为 75% 和 25%。初始区间为 ,每次都按照当前区间长度的 75% 分给 A,余下 25% 分给 B。
编码序列 ABA 的过程如下:
| 步骤 | 当前符号 | 更新后的区间 |
|---|---|---|
| 初始 | 无 | [0, 1) |
| 第一次 | A | [0, 0.75) |
| 第二次 | B | [0.5625, 0.75) |
| 第三次 | A | [0.5625, 0.703125) |
最终只要选择位于目标区间内、且可以明确终止的二进制小数,就能代表这段序列。例如 位于最终区间内。若解码器已知符号数量为 3,并使用相同概率模型,就能依次恢复 A、B、A。
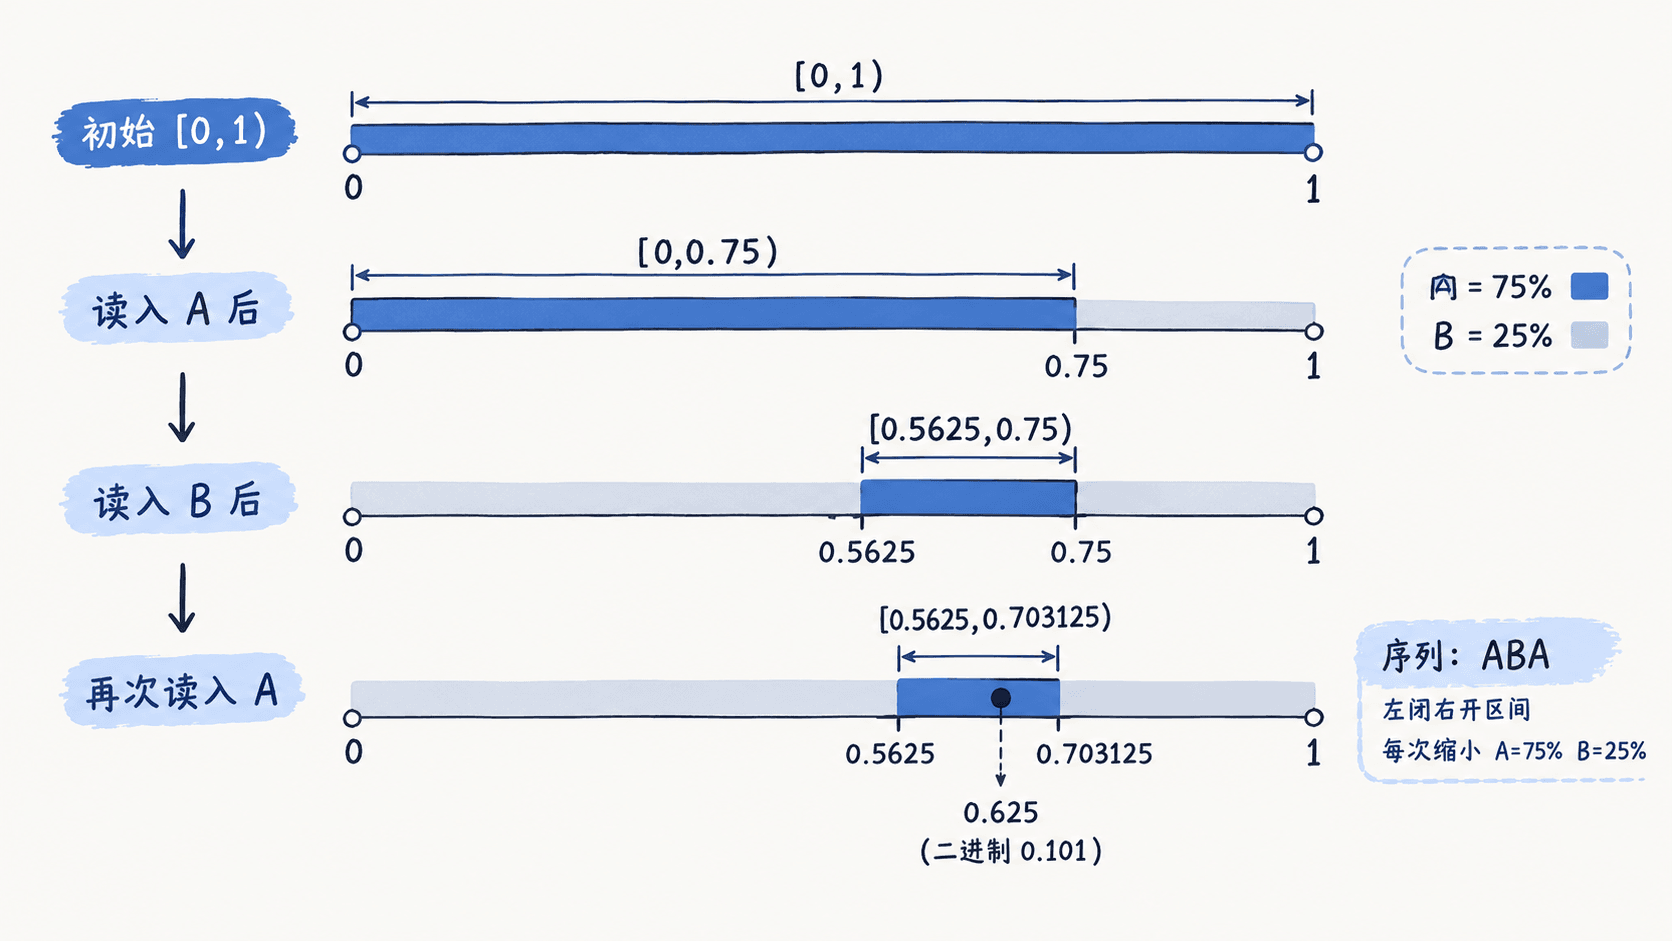
实际视频标准不会直接用无限精度浮点数保存区间,而是使用有限精度整数计算、区间归一化和比特输出机制。H.264/AVC 与 H.265/HEVC 中的 CABAC(上下文自适应二进制算术编码)会将相关语法转换为二元符号,并根据上下文概率状态编码;部分二元符号可采用旁路编码,不使用常规的上下文概率更新。
编码器与解码器必须遵循同一套上下文初始化、选择及更新规则。解码器不需要额外获知编码器私有的统计过程,只需要按照标准和码流中的必要语法同步重建概率状态。
熵编码和量化分别负责什么
量化与熵编码经常连续出现,但两者承担不同职责。量化会减少系数精度,通常产生不可逆误差;熵编码只改变符号的二进制表示方式,正确解码后应当逐个恢复熵编码之前的符号。
例如,一个变换系数为 23,采用简化的标量量化规则,量化步长为 10:
反量化得到 20,与原始的 23 相差 3。这个误差来自量化,而不是后续的熵编码。
| 环节 | 输入 | 输出 | 是否产生量化误差 |
|---|---|---|---|
| 量化 | 23,步长 10 | 整数 2 | 是 |
| 熵编码 | 整数符号 2 | 压缩比特序列 | 否 |
| 熵解码 | 压缩比特序列 | 整数符号 2 | 否 |
| 反量化 | 整数 2,步长 10 | 重建值 20 | 保留已有误差 |
这只是标量量化的简化算例,实际视频编码的量化与反量化还涉及标准规定的缩放、舍入和其他处理。
怎样判断概率建模是否有效
评价上下文模型时,应比较相同输入符号序列在不同模型下的实际比特开销,而不是只看某一种符号被分配了多少比特。
可以进行一个纸面实验:给定 100 个是否非零的二元符号,其中 90 个为零、10 个为非零。忽略模型传输和码流开销,分别计算两种模型的理想编码长度。
- 均匀概率模型:零和非零都按 50% 估计,平均 1 bit/符号,总计 100 bit。
- 匹配实际分布的模型:零概率 90%,非零概率 10%,总长度约为 bit。
理想节省约为 53.1 bit。实际编码还会受到概率状态精度、上下文更新、终止编码和码流封装的影响,因此不能把 46.9 bit 当成 CABAC 必然产生的最终大小。
如果上下文划分得过细,每组样本太少,模型反而可能估计不准。真实编码器需要在符号分布的可预测性、模型复杂度及编码开销之间做取舍。
判断一个熵编码方案是否正确,可同时检查两个结果:编码后再解码的符号序列与编码前完全一致;在相同量化结果和相同语法语义下,概率模型更准确时,统计上通常能获得更低的平均编码开销。画质是否发生变化,则应回到量化、预测和重建过程检查,而不是把所有压缩损失归因于熵编码。