
编码与格式 / 系统课时
用反量化和逆变换重建像素
用反量化和逆变换重建像素
编码器完成预测、变换和量化后,得到的并不是最终像素,而是一组有损的量化系数。要让这些系数重新变成可用于显示和后续预测的图像,必须经过反量化、逆变换、预测值相加与像素裁剪。本篇用一个可计算的 2×2 示例还原整个过程,并解释编码器为什么必须在内部执行相同的重建操作。
学习目标
- 理解反量化、逆变换、预测补偿和裁剪各自解决的问题。
- 使用具体系数计算重建像素,识别量化、舍入和裁剪造成的误差。
- 解释编码器与解码器为什么必须保持一致的重建参考图像。
重建链路从哪里开始
视频编码通常先根据相邻已重建像素生成预测块,再用原始块减去预测块,得到残差。残差经过正变换和量化后形成量化系数,随后通过熵编码写入码流。
解码器无法直接获得原始残差,只能使用码流中的量化系数和相关参数恢复一个近似残差,再与自己生成的预测块相加。
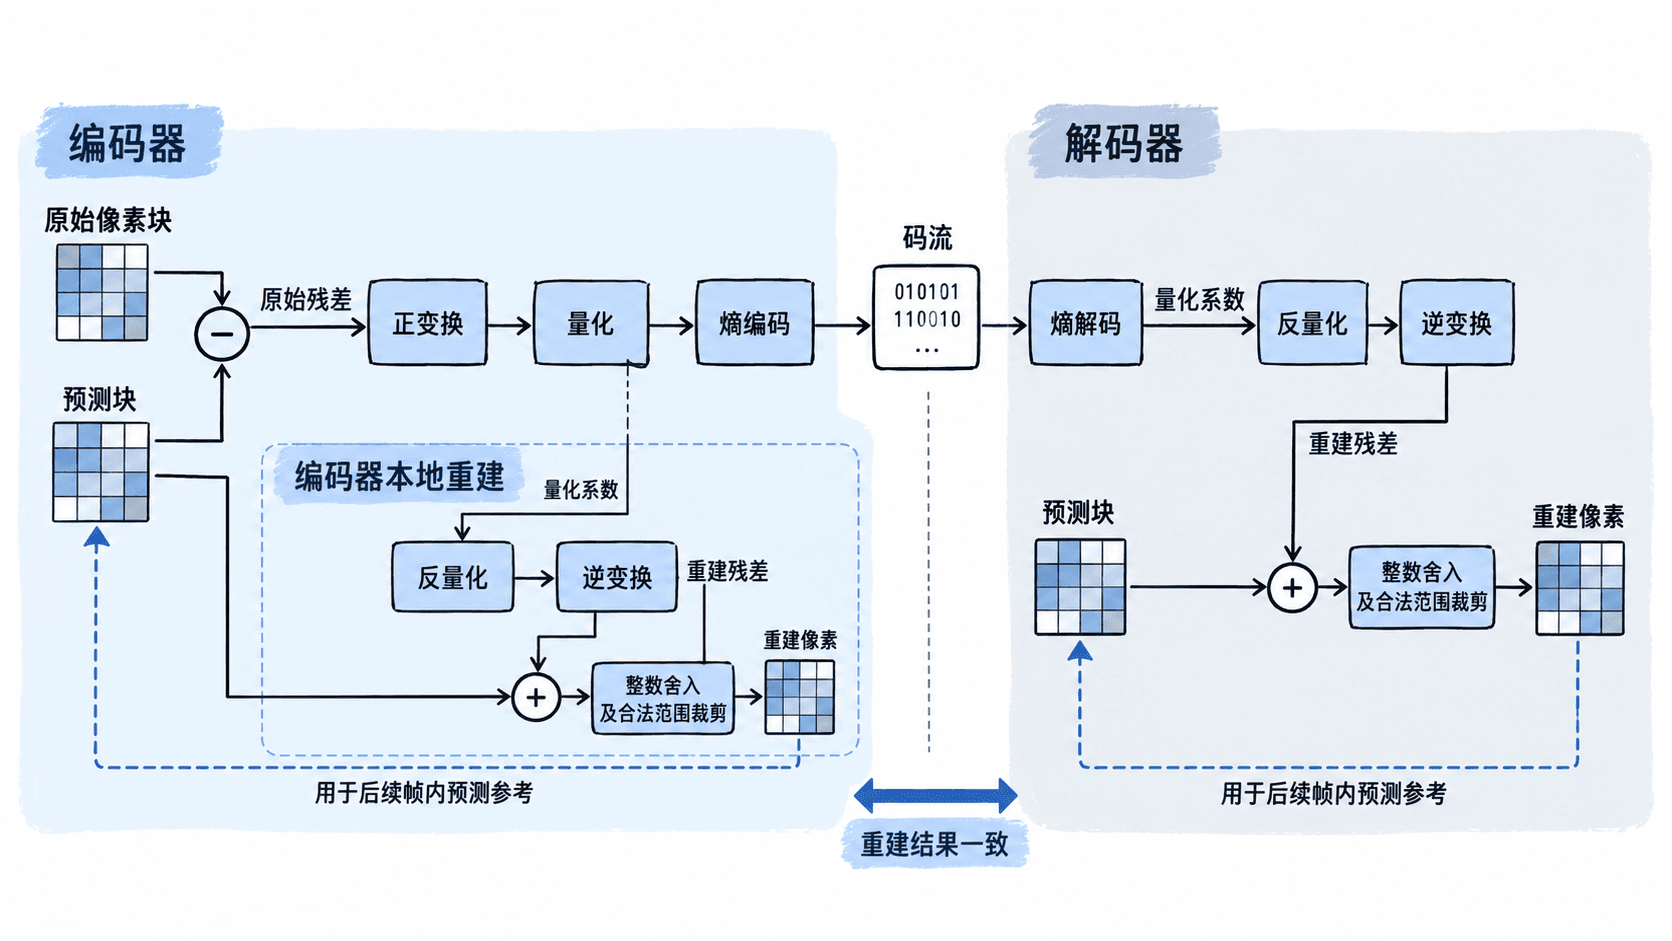
各阶段的输入和作用如下:
| 阶段 | 输入 | 输出与作用 |
|---|---|---|
| 反量化 | 量化系数、量化参数 | 恢复近似变换系数 |
| 逆变换 | 反量化系数 | 恢复空间域残差 |
| 预测补偿 | 残差、预测块 | 得到待裁剪的像素值 |
| 舍入与裁剪 | 中间像素值、位深 | 得到合法的整数重建像素 |
实际编解码标准可能采用整数变换、缩放矩阵、固定精度移位和特定的舍入规则,不一定是简单的浮点逆变换。理解时可以先用数学模型把四个阶段分开,但实现时必须严格遵循对应标准。
反量化为什么不能恢复原始系数
量化的本质是将连续或较高精度的变换系数映射到有限的整数等级。为了观察误差,先采用一个教学用的均匀标量量化模型,量化步长设为 8:
其中 是原始变换系数, 是量化后的整数。反量化使用:
假设原始系数为 19,则量化得到 2,反量化只能恢复为 16,误差为 -3。原始系数为 21 时也会得到相同的量化等级 3 吗?按照上述公式,21/8=2.625,四舍五入得到 3,恢复值为 24。可见量化等级由区间决定,不能简单认为所有邻近系数都映射到同一个整数。
选取一组没有半整数舍入歧义的数据:
| 原始系数 | 量化系数 | 反量化系数 | 恢复误差 |
|---|---|---|---|
| 19 | 2 | 16 | -3 |
| -11 | -1 | -8 | +3 |
| 6 | 1 | 8 | +2 |
| 2 | 0 | 0 | -2 |
当系数被量化为零时,原来的小幅度纹理信息就可能彻底丢失。反量化只能根据量化等级恢复代表值,而无法从码流中推断原始系数究竟是多少。
用逆变换算出重建残差
下面采用正交归一化的 2×2 Hadamard 变换作为算例,展示系数如何回到空间域。它只是教学示例,不代表 H.264 等标准实际使用的具体变换核。
设反量化后的系数矩阵为:
令正交变换矩阵为:
二维逆变换为:
由于 是对称矩阵,将数值代入后得到:
这表示四个空间位置的恢复残差分别为 8、16、0、8。残差可能为正,也可能为负,不能直接当作最终像素显示。
假设预测块为:
逐位置相加得到:
这是本例最终的重建像素块,四个值都落在 8 位像素允许的 0~255 范围内。
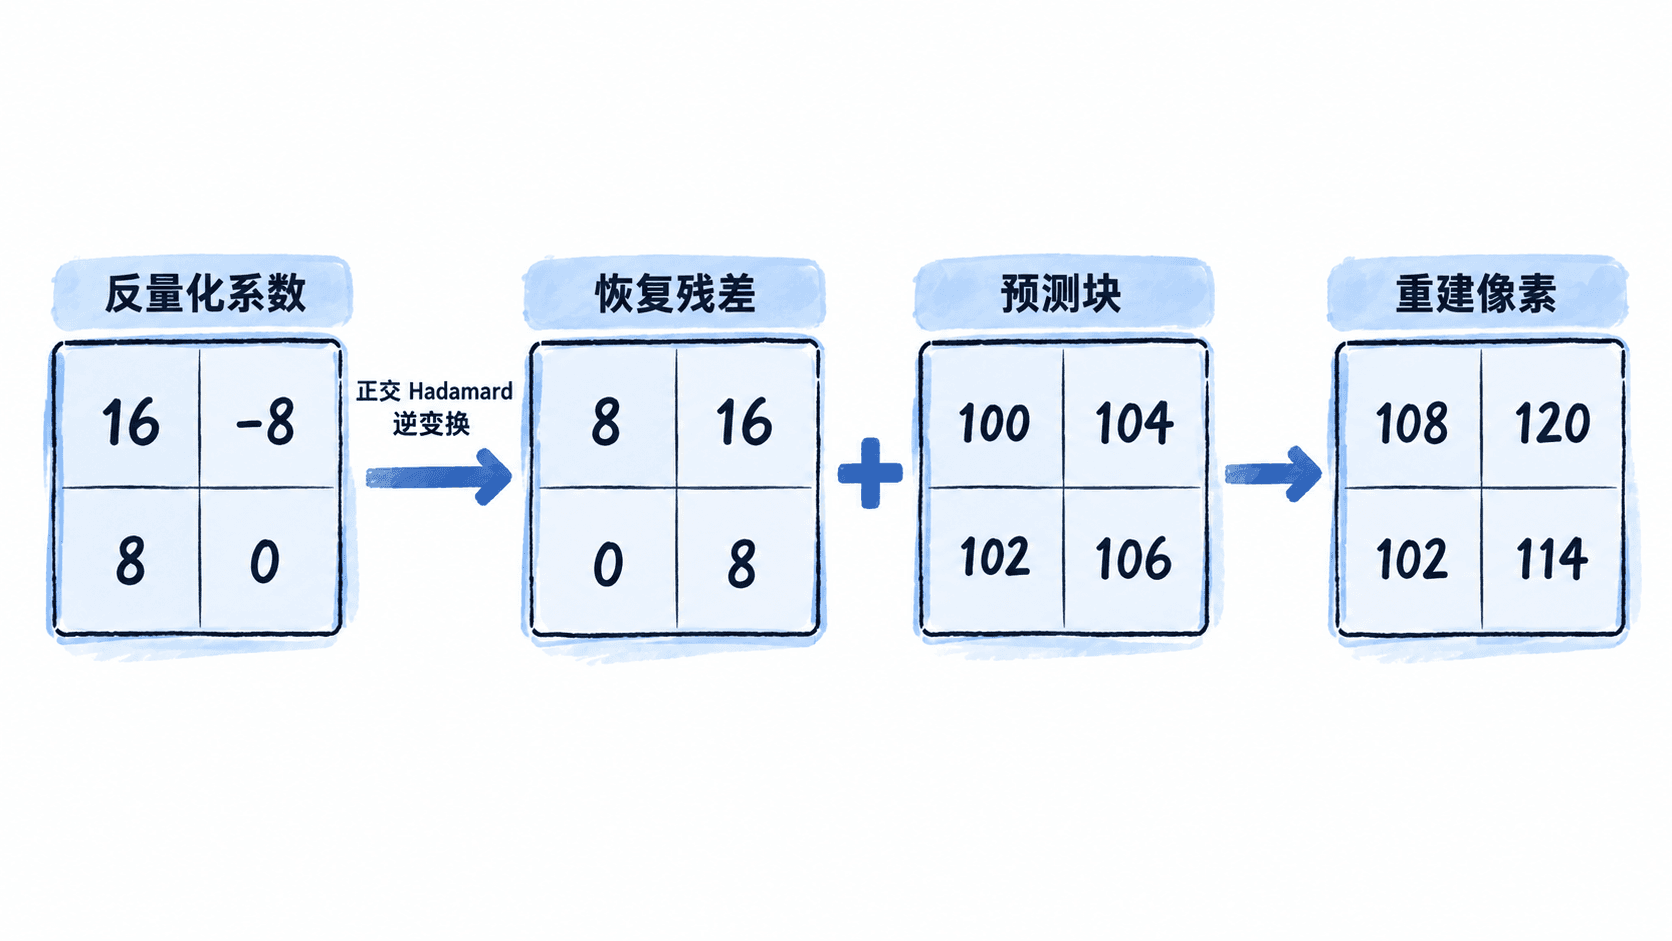
实际视频编码通常使用更大的变换块,且不同编码模式、块尺寸或标准可能选择不同变换方式,部分模式还会跳过变换。无论采用哪种方式,逆变换阶段都必须与编码端的变换定义和规范计算精度匹配。
舍入和裁剪怎样影响像素
恢复残差可能包含非整数中间值,整数变换实现也可能需要通过移位完成规定的定点舍入。最终输出到整数像素缓冲区前,应遵循编码标准的舍入顺序。
以 8 位像素为例,合法像素范围为 0~255。教学模型中的裁剪可以表示为:
这里 是预测值, 是恢复残差。该表达式用于说明行为,标准实际实现中的舍入和裁剪位置应以规范为准。
| 预测值 | 恢复残差 | 相加结果 | 最终 8 位像素 |
|---|---|---|---|
| 100 | 15.6 | 115.6 | 116 |
| 250 | 12 | 262 | 255 |
| 4 | -10 | -6 | 0 |
第二行发生上限裁剪,第三行发生下限裁剪。裁剪后无法再从像素 255 判断未经裁剪的结果究竟是 256 还是 300。
位深决定合法范围:8 位为 0~255,10 位为 0~1023,12 位为 0~4095。在完整实现中,不能把所有视频都按 8 位处理;同时也要区分内部中间计算范围与最终样本范围。
另一个容易混淆的地方是误差来源。量化会丢弃系数精度,属于主要的有损来源;舍入可能引入小幅离散化差异;裁剪会改变超出合法范围的结果。逆变换本身并不自动消除量化误差。
用代码核对整个数值过程
下面使用 Python 3 和 NumPy 演示本课教学模型,运行前安装依赖:
python -m pip install numpy预期结果:命令正常结束,NumPy 安装成功或提示依赖已经满足。不同环境的安装日志及版本号可能不同。
随后保存为 reconstruct.py 并执行。为保证可复现,代码明确使用固定量化步长、指定的 2×2 变换矩阵和 8 位像素裁剪;这不是标准视频解码器实现。
import numpy as np

# 使用教学用正交 Hadamard 变换,明确变换核和量化步长
h = np.array([[1, 1], [1, -1]], dtype=float) / np.sqrt(2)
quantized = np.array([[2, -1], [1, 0]], dtype=float)
prediction = np.array([[100, 104], [102, 106]], dtype=float)

# 反量化后逆变换,恢复空间域残差
coefficients = quantized * 8
residual = h.T @ coefficients @ h

# 浮点误差在这里不应改变理论整数结果
reconstructed = np.clip(np.rint(prediction + residual), 0, 255).astype(int)
print('Residual:')
print(np.rint(residual).astype(int))
print('Reconstructed:')
print(reconstructed)
运行命令:
python reconstruct.py预期输出:
Residual:
[[ 8 16]
 [ 0  8]]
Reconstructed:
[[108 120]
 [102 114]]
代码中的 np.rint 按最近整数舍入,恰好在两个整数中间时采用偶数舍入规则。不要直接把这个规则当成某个视频编码标准的规范舍入方式。这里各重建结果都是理论整数,因此不会触发平局舍入差异。
可以把 prediction 的右上角从 104 改为 250,此时右上角相加为 266,裁剪后会得到 255;这可以独立验证裁剪逻辑。
编码器为什么也要重建像素
帧内预测会使用已经重建且满足当前预测可用性规则的邻近参考样本。如果编码器使用原始像素进行后续预测,而解码器只能使用有损重建像素,双方的预测结果就可能不同。
举一个最小例子:编码器原始参考像素为 100,经过有损编码后重建值是 96。假设后续位置采用直接复制该参考值的预测模式。
- 错误做法:编码器使用原始参考值 100,解码器使用重建参考值 96,预测立即相差 4。
- 正确做法:编码器和解码器均使用重建参考值 96,预测一致,后续残差的解释也保持一致。
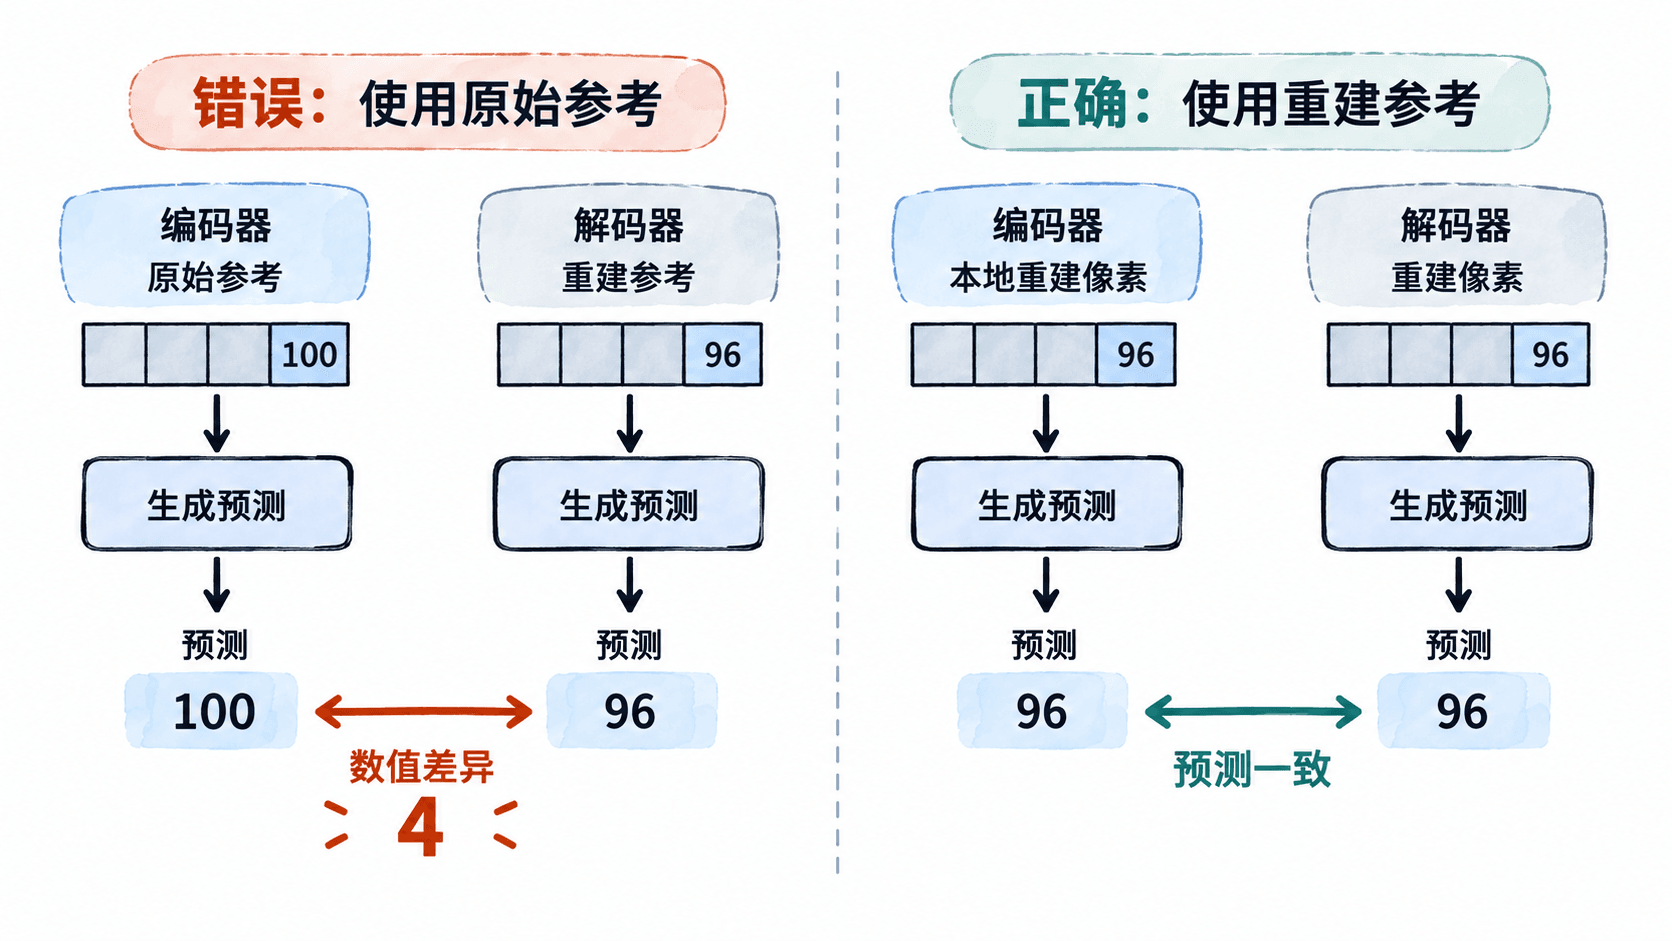
一旦参考值不一致,预测误差可能沿后续块传播;在帧间预测中还可能沿参考帧传播,形成解码漂移。因此,编码器通常包含一条与解码器规范重建过程对应的本地重建路径。
实际编码器还需要使环路滤波、参考样本可用性、边界处理和固定精度计算等环节与标准要求一致。尤其不能让编码器采用任意浮点运算结果,而解码器采用不同的整数舍入结果,否则即使量化系数相同也可能出现参考像素偏差。
判断重建实现是否正确,可以先核对本课 2×2 示例的残差和像素结果,再检查负残差、超范围裁剪、不同位深以及量化为零的系数。真正的编解码器还必须使用对应标准的符合性测试码流验证。最终需要保持的关系是:量化带来的失真可以存在,但编码器与解码器对规范重建像素的计算必须一致。