
数据结构与算法 / 系统课时
连通分量怎么一次求完
连通分量怎么一次求完
无向图可能由多个彼此不可达的区域组成。要一次找全所有连通分量,关键不是重复从每个节点完整遍历,而是“外层扫描全部节点,内层只从未访问节点启动一次 BFS”。这样孤立点也不会漏掉,每个节点仍只处理一次。
学习目标
- 掌握“外层扫描 + BFS”统计全部连通分量的结构
- 正确处理孤立点、重复边和重复访问
- 分析遍历全部连通块的时间与空间复杂度
为什么一次 BFS 不够
一次 BFS 只能覆盖与起点连通的节点。如果图里还有其他区域,它们不会进入当前队列,因此必须继续检查尚未访问的节点。每当外层扫描遇到一个未访问节点,就说明发现了一个新的连通分量,并从这里启动新的 BFS。
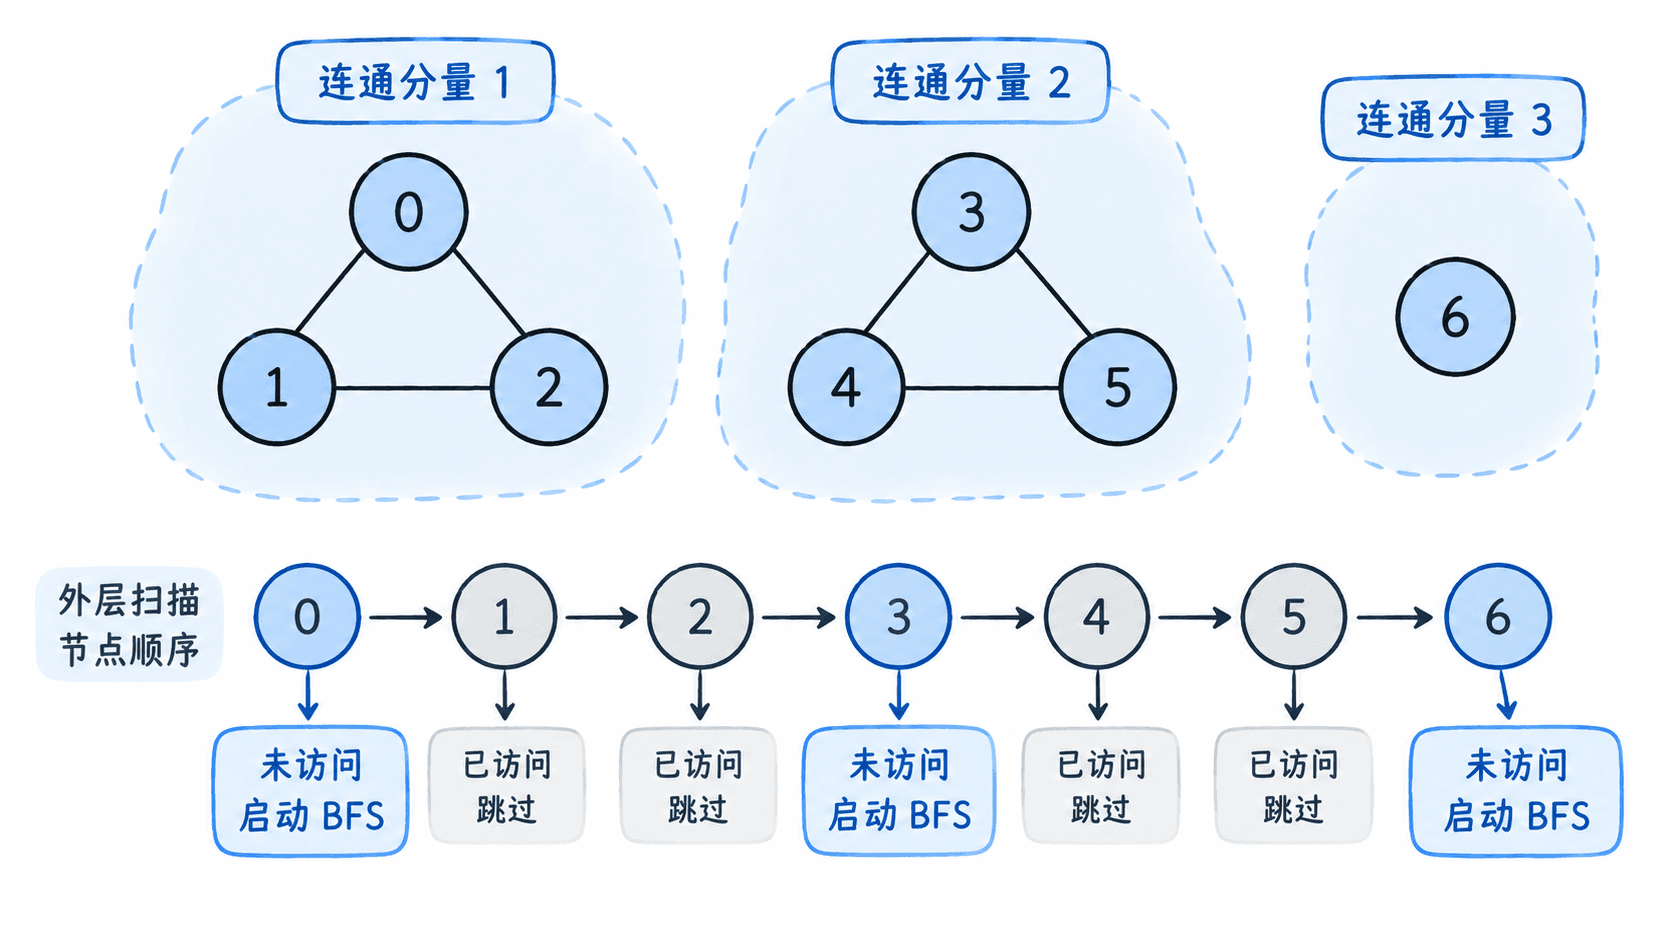
这种写法看起来会启动多次 BFS,但不会把同一节点反复遍历。节点一旦入队就立即标记为已访问,之后外层扫描或其他邻接边再次遇到它时都会直接跳过。
用外层扫描启动新的连通块
如果节点编号已知为 0 到 n-1,应当先为全部 n 个节点建立邻接表,而不是只记录出现在边集合里的节点。否则没有任何边的孤立点会直接消失,连通分量数量也会算少。
遍历过程只有两个核心状态:visited 记录是否处理过节点,components 保存每次 BFS 收集到的节点集合。外层发现未访问节点时创建新分量,内层 BFS 负责把与它可达的节点全部收进来。
一个可运行的统计示例
下面的图有 7 个节点,其中 0、1、2 相连,3、4、5 相连,6 是孤立点,因此应得到 3 个连通分量。
from collections import deque

def connected_components(n, edges):
    graph = [[] for _ in range(n)]

    for u, v in edges:
        graph[u].append(v)
        graph[v].append(u)

    visited = [False] * n
    components = []

    for start in range(n):
        if visited[start]:
            continue

        # 每个未访问起点对应一个新的连通分量。
        visited[start] = True
        queue = deque([start])
        component = []

        while queue:
            node = queue.popleft()
            component.append(node)

            for neighbor in graph[node]:
                if visited[neighbor]:
                    continue
                visited[neighbor] = True
                queue.append(neighbor)

        components.append(component)

    return components

def main():
    edges = [
        (0, 1),
        (1, 2),
        (3, 4),
        (4, 5),
    ]

    print(connected_components(7, edges))

if __name__ == "__main__":
    main()
预期输出
[[0, 1, 2], [3, 4, 5], [6]]示例中的节点和邻接边都按固定顺序存储,所以输出顺序稳定。若邻接表来自集合或其他无序容器,同一连通分量内部的遍历顺序可能不同,但分组结果不应改变。
孤立点和重复边怎么处理
孤立点的邻接表为空,但外层扫描仍会发现它尚未访问,于是它会单独形成一个只含自身的连通分量。自环不会产生新分量;重复边也不会导致节点被重复加入队列,因为 visited 在入队时已经置为 True。
如果输入允许大量重复边,算法仍然正确,但这些边会增加实际扫描次数。是否预先去重取决于输入规模与后续用途,不能为了“看起来干净”就无条件增加一套去重结构。
复杂度与适用范围
用邻接表表示无向图时,构图需要 空间;遍历阶段每个节点访问一次,每条无向边从两端各检查一次,因此总时间复杂度仍是 。visited、队列和组件结果会占用额外的 级空间。
这里讨论的是无向图连通分量。若是有向图,“强连通分量”和“弱连通分量”是不同问题,不能直接把同一段 BFS 代码当作强连通分量算法。如果图只不断新增边、且要反复回答“两个节点是否连通”,并查集通常比每次重新遍历整张图更合适。