
数据结构与算法 / 系统课时
路径压缩为什么更快
路径压缩为什么更快
普通并查集如果不断形成很深的父指针树,一次 find 可能需要沿很多层才能到达根。路径压缩与按秩合并分别从“查询后变扁”和“合并时避免变高”两个方向控制树高,使大量连续操作接近常数时间。
学习目标
- 理解深链为什么会拖慢连续的
find操作 - 掌握路径压缩与按秩合并分别优化什么
- 能解释并查集近似常数级摊销复杂度的来源
深树让 find 重复走相同路径
如果父指针形成 4 → 3 → 2 → 1 → 0,那么查询 find(4) 必须访问多个节点。下一次查询 4、3 或 2 时,如果树结构没有改变,又会重复走这些父指针。
路径压缩利用一次查询已经找到根这一事实,在递归返回或迭代回溯时,把沿途节点直接改为指向根。之后再查询这些节点,通常只需要一两次访问。
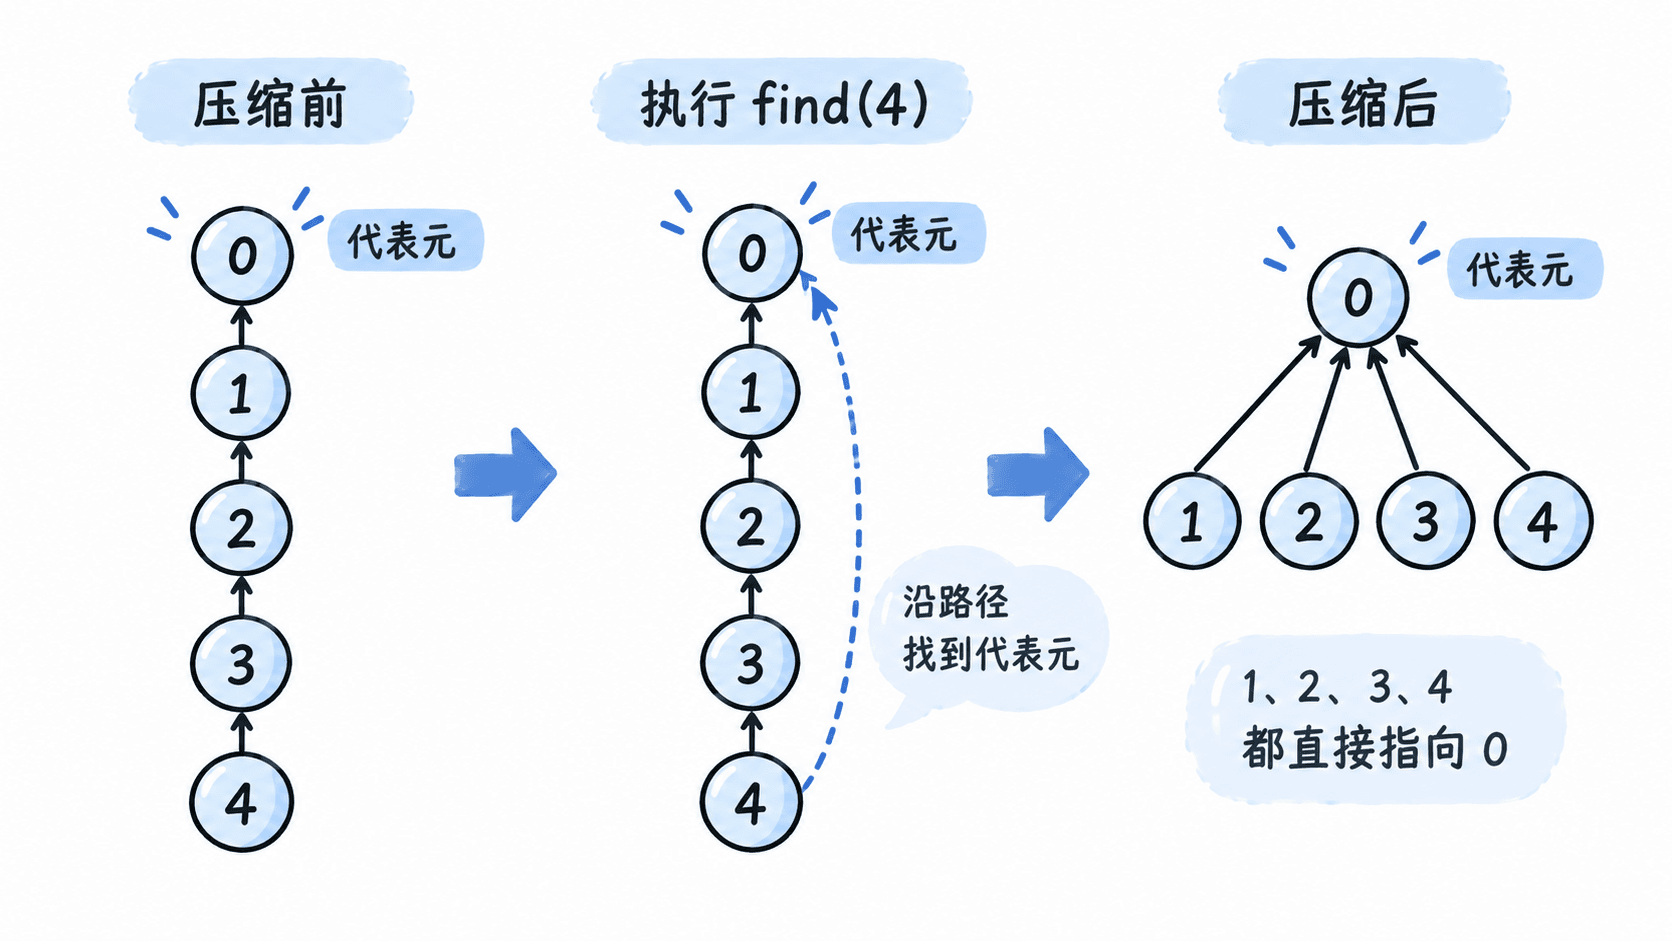
路径压缩不会改变集合成员,也不会改变代表元;它只重写中间节点的父指针,因此属于保持语义不变的结构优化。
路径压缩在 find 中完成
最常见的递归写法只有一处关键赋值:先找到父节点的根,再把当前节点的父节点直接更新为这个根。
class DisjointSet:
    def __init__(self, n: int):
        self.parent = list(range(n))
        self.rank = [0] * n

    def find(self, x: int) -> int:
        if self.parent[x] != x:
            # 回溯时让沿途节点直接指向代表元。
            self.parent[x] = self.find(self.parent[x])
        return self.parent[x]

    def union(self, a: int, b: int) -> bool:
        root_a = self.find(a)
        root_b = self.find(b)
        if root_a == root_b:
            return False

        # 总是把较矮的树挂到较高的树下面。
        if self.rank[root_a] < self.rank[root_b]:
            root_a, root_b = root_b, root_a

        self.parent[root_b] = root_a
        if self.rank[root_a] == self.rank[root_b]:
            self.rank[root_a] += 1
        return True


dsu = DisjointSet(5)
# 为了直接观察压缩效果,构造一棵合法但较深的父指针树。
dsu.parent = [0, 0, 1, 2, 3]

print(dsu.parent)
print(dsu.find(4))
print(dsu.parent)
预期输出
[0, 0, 1, 2, 3]
0
[0, 0, 0, 0, 0]
第一次 find(4) 仍要沿路径找到 0,但执行结束后,原来路径上的 2、3、4 都已经直接指向根。优化的收益主要体现在后续操作,而不是让第一次查询凭空跳过尚未知晓的父节点。
按秩合并从源头限制树高
只做路径压缩已经很有效,但 union 仍可能不断制造较高的树。按秩合并为每棵树维护一个近似高度 rank:合并时让低秩树的根指向高秩树的根;只有两个根秩相同时,新根的秩才增加 1。
这两个优化作用在不同阶段:路径压缩发生在查询过程中,让已经访问过的路径变短;按秩合并发生在集合合并时,尽量避免产生深路径。实际工程和竞赛实现通常同时使用二者。
为什么复杂度几乎是常数
只有按秩合并时,树高已经受到明显限制;再配合路径压缩后,一批 find 和 union 操作的摊销时间复杂度为 ,其中 是反 Ackermann 函数。
它增长得极慢,在现实可处理的数据规模上通常不超过一个很小的常数。因此工程上经常把优化后的并查集理解为“单次操作几乎是常数时间”,但严格分析时仍应写成摊销 ,而不是直接声称理论复杂度为 。
路径压缩适合连续查询同一批连通关系,按秩合并适合持续加入连接。二者同时使用时,既减少已有长路径,又抑制新长路径形成,这正是并查集在大规模动态连通任务中高效的关键。