
数据结构与算法 / 系统课时
先看哪些约束再选算法
先看哪些约束再选算法
复杂图题最容易出错的地方不是不会某个算法,而是看到关键词就直接套模板。更稳妥的做法是先读规模、权值、查询次数和动态性,再确定问题类型与可接受复杂度,最后才选择具体算法。
学习目标
- 用节点边规模判断时间与空间上限
- 根据权值、查询次数和动态性排除不合适算法
- 建立一套可重复使用的图算法选型顺序
先固定四类约束
第一类是规模:节点数记为 n,边数记为 m。当 m 与 n 同量级时通常是稀疏图;当 m 接近 n² 时要警惕邻接矩阵、全源算法和高阶复杂度的成本。
第二类是权值:无权图、非负权图、含负权边、DAG 的选择完全不同。第三类是查询次数:一次单源查询和数万次点对查询不能用同一套成本估算。第四类是动态性:边是否会插入、删除或修改,会直接决定预处理结果能否长期复用。
用约束驱动选型
下面的流程图不是“算法大全”,而是先排除明显不合适方案,再把候选范围缩到少数几类。
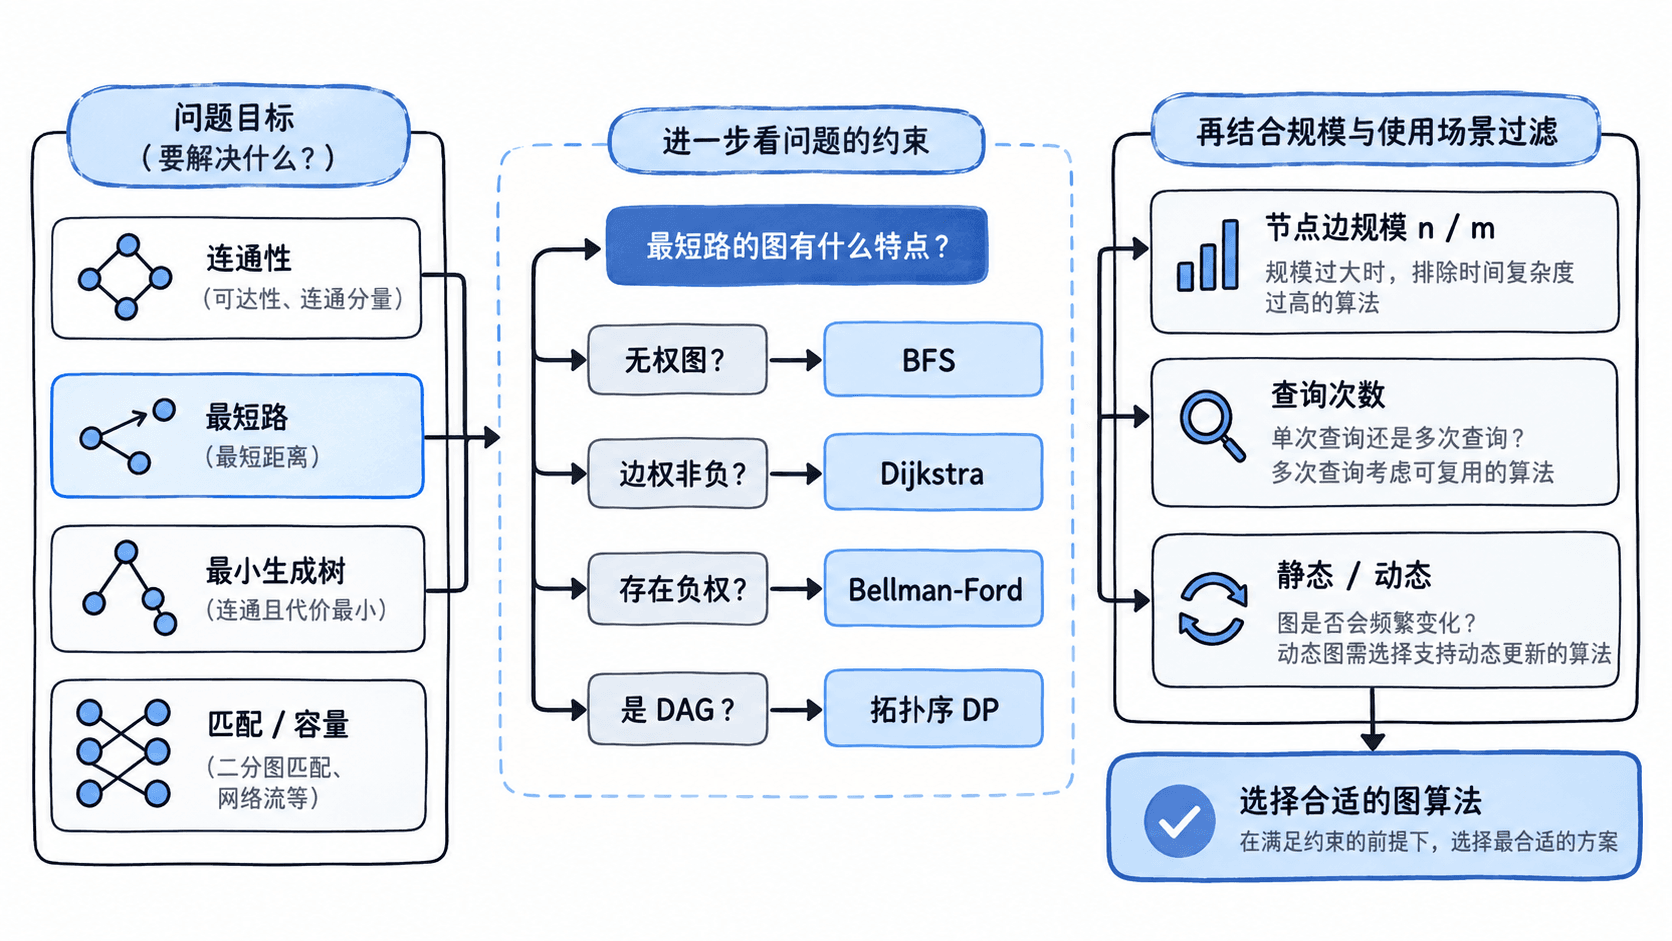
对常见静态图,可以先用下表做第一轮判断。
| 约束 | 常见候选 |
|---|---|
| 无权最短路 | BFS |
| 非负权单源最短路 | 堆优化 Dijkstra |
| 含负权边且规模允许 | Bellman-Ford |
| DAG 上最短路或最长路 | 拓扑序 + 动态规划 |
| 小规模多源最短路 | Floyd-Warshall |
| 最小生成树 | Kruskal 或 Prim |
| 仅判断连通块合并 | 并查集 |
表格只给候选,不替代复杂度检查。例如 Floyd-Warshall 是 ,即使题目问“任意两点最短路”,当 n 很大时也不能仅凭关键词选择它。
一套实际判断顺序
- 先确认目标究竟是连通性、最短路、生成树、匹配还是容量分配;目标不同,算法族就不同。
- 再看
n、m,先估算候选算法是否能在时限和内存内运行。 - 检查边权特征,尤其是是否无权、是否存在负权、是否为 DAG,这一步经常直接决定最短路算法。
- 看查询次数。一次查询可以接受按需搜索,大量重复查询才值得考虑更重的预处理。
- 最后看图是否变化。静态图上的预处理在删边、改权后可能全部失效,动态问题不能假设结果永久可复用。
这个顺序的核心是先处理“会否定方案”的条件。例如 Dijkstra 在存在负权边时不是“稍慢”,而是前提不成立;而 Bellman-Ford 在超大稀疏图上即使正确,也可能因为 太慢而不可用。
看一个选型例子
假设有 n=200000 个点、m=300000 条边,所有边权非负,只需要从一个源点求到其他点的最短距离,而且图在查询期间不变化。
首先这是单源最短路;规模大且图稀疏,排除 邻接矩阵方案;边权非负,允许使用 Dijkstra;只查询一次,没有必要做全源预处理。于是“邻接表 + 优先队列 Dijkstra”是自然候选,典型复杂度约为 。
如果同一张图改成无权图,则 BFS 会更直接;如果加入负权边,Dijkstra 的前提被破坏;如果图还是 DAG,则即使有负权,也可以在拓扑序上做线性级动态规划。真正决定算法的是约束组合,而不是题目里出现了哪个熟悉名词。
动态性和多查询是第二层筛选
“查询很多”并不自动意味着 Floyd-Warshall,“图会变化”也不自动意味着需要高级动态算法。先把每次查询成本、预处理成本、更新成本分别估算,再判断总成本。
例如只新增边的连通性问题可以用并查集持续合并;而删除边会破坏这种单向累积特性,常见做法是离线后逆序处理,或改用更适合动态连通性的结构。选型时只要坚持先验证算法前提,再计算总复杂度,就能避免大多数“算法本身会写,但一提交就超时或答错”的问题。