
数据结构与算法 / 系统课时
图题超时先查哪一层
图题超时先查哪一层
图题超时不等于“算法名字选错了”。同一个复杂度量级下,建模导致边数膨胀、图表示不合适、数据结构操作过慢或实现重复扫描,都可能把本来能过的方案拖到超时。本节建立一条从上到下的定位顺序,用可测量的指标找到真正瓶颈。
学习目标
- 按模型、表示、算法、数据结构和实现细节逐层定位超时来源
- 根据顶点数、边数和操作次数判断理论复杂度是否已经不可接受
- 用计数和小规模实验验证是否存在无效扫描或重复处理
先判断超时发生在哪一层
排查时不要先改常数,而应从最上层开始。上层问题通常会放大下层成本,例如把一个状态拆成过多顶点后,即使用最优实现也可能无法通过。
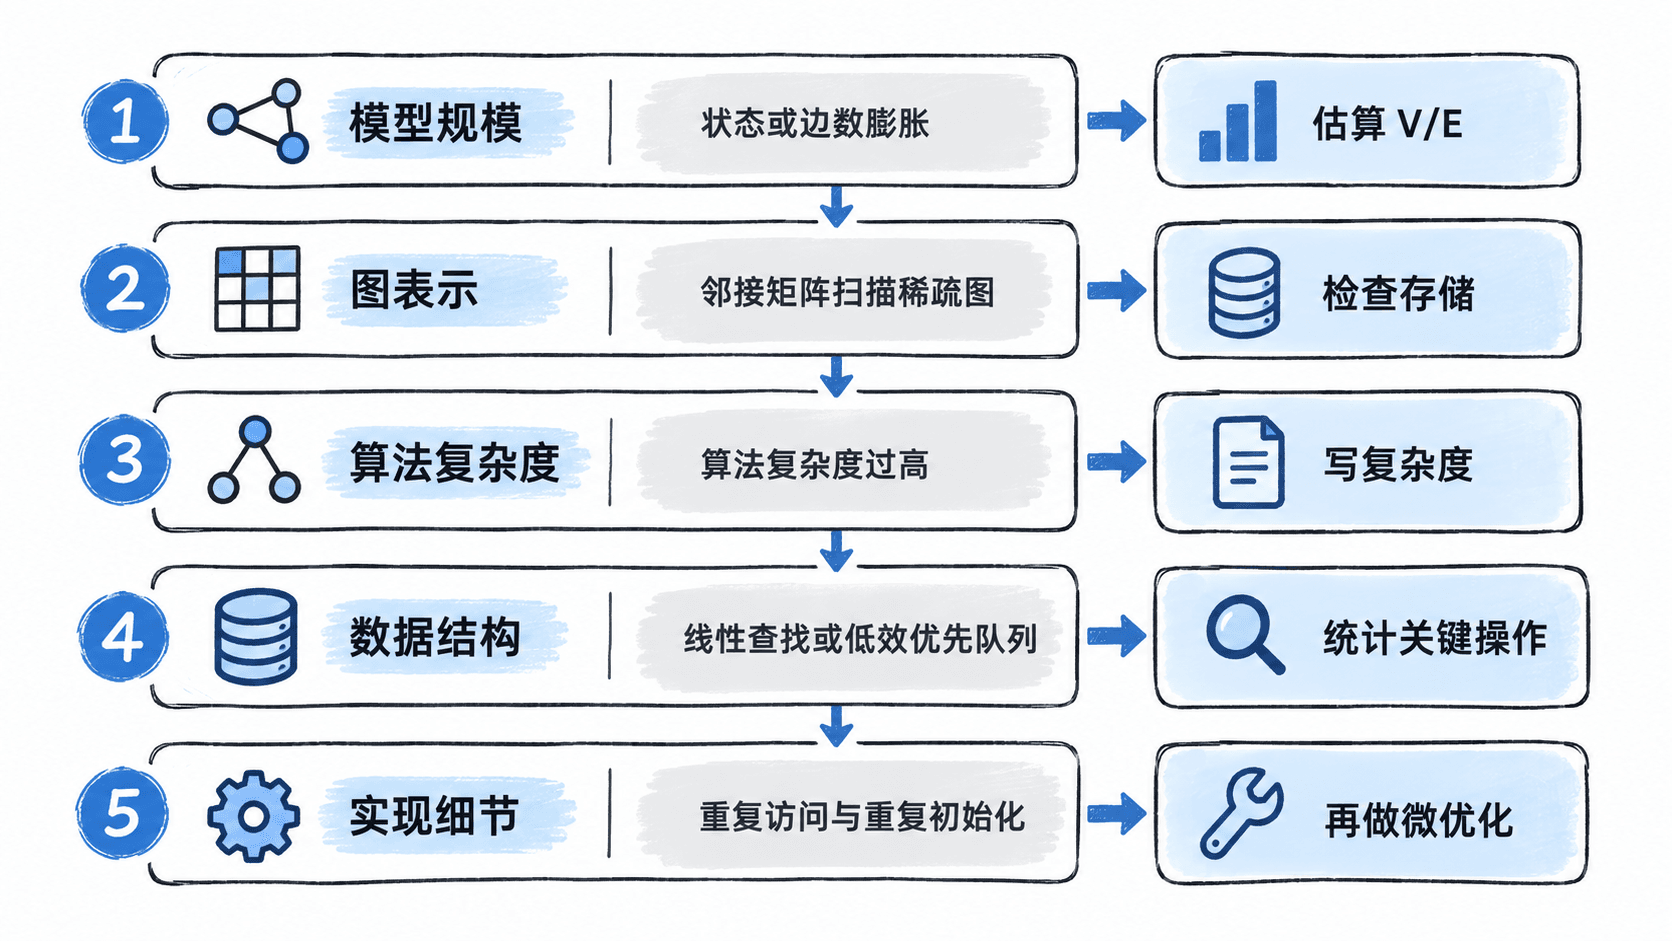
第一层看模型。先写出最大顶点数 和边数 ,尤其警惕状态图、分层图、时间维度展开后规模成倍增长。若原题只有 个对象,但建模后产生 条边,问题已经不是语言常数。
第二层看表示。稀疏图通常用邻接表,使遍历所有邻边接近 ;如果使用邻接矩阵,每访问一个顶点都扫描整行,遍历成本会接近 。只有图很稠密、需要常数时间判断两点是否直接相连时,矩阵才可能合适。
用复杂度预算排除不可能方案
把核心循环翻译成数量级,而不是只记算法名称。例如普通 BFS、DFS 是 ;使用二叉堆的 Dijkstra 常写作 ;如果对每个源点重新运行一次,整体还要再乘一个源点数量。
判断时应把题目上限代进去。如果 、,线性或带对数因子的遍历通常仍有讨论价值;若代码实际上执行 次操作,就已经到了约 量级,此时优化语法细节没有意义。
统计关键操作而不是凭感觉猜
下面的程序用同一张稀疏无向图分别执行邻接矩阵 BFS 和邻接表 BFS,并统计“检查邻居”的次数。两种写法都能得到正确访问结果,但额外扫描量完全不同。
from collections import deque

n = 6
edges = [(0, 1), (0, 2), (1, 3), (2, 3), (3, 4), (4, 5), (1, 5)]

matrix = [[False] * n for _ in range(n)]
adj = [[] for _ in range(n)]
for u, v in edges:
    matrix[u][v] = matrix[v][u] = True
    adj[u].append(v)
    adj[v].append(u)

def bfs_matrix(start):
    visited = [False] * n
    visited[start] = True
    q = deque([start])
    checks = 0
    while q:
        u = q.popleft()
        for v in range(n):
            checks += 1
            if matrix[u][v] and not visited[v]:
                visited[v] = True
                q.append(v)
    return checks

def bfs_list(start):
    visited = [False] * n
    visited[start] = True
    q = deque([start])
    checks = 0
    while q:
        u = q.popleft()
        for v in adj[u]:
            checks += 1
            if not visited[v]:
                visited[v] = True
                q.append(v)
    return checks

print("matrix checks:", bfs_matrix(0))
print("list checks:", bfs_list(0))
预期输出
matrix checks: 36
list checks: 14
这个计数方法可以迁移到真实题目:统计出队次数、边松弛次数、堆操作次数、状态生成数量,或某个昂贵函数的调用次数。如果某个值远高于理论上限,就能继续追到具体循环,而不是盲目重写整份代码。
最后再查数据结构与实现细节
理论方案能通过后,再检查每个高频操作的代价。优先队列是否真的提供对数级取最小值;判重是否用了哈希表、布尔数组或合适的距离数组;删除、查找或合并是否意外落到线性复杂度。一个 主循环里嵌入一次 查找,很容易悄悄变成 。
实现层常见的额外成本还包括:同一状态反复入队而没有过期判断、每轮查询都清空巨型数组、递归中复制大对象、把边列表重复排序,以及在热点循环中频繁构造临时容器。确认这些问题前,应先证明模型和算法量级正确。
实际排查顺序可以固定为:先写出最大 、 和状态数量,再确认图表示,再计算主算法复杂度,然后统计关键操作次数,最后才处理容器选择、初始化和常数优化。这样能优先修掉数量级错误,也避免在一个理论上必然超时的方案上浪费时间。