
数据结构与算法 / 系统课时
SPFA 为什么常被误用
SPFA 为什么常被误用
SPFA 把 Bellman-Ford 的“每轮扫描全部边”改成只处理距离刚被更新的顶点,很多数据上确实很快,但最坏复杂度仍可能退化到 。理解队列机制和退化风险,才能避免把它当成负权图上的默认最短路算法。
学习目标
- 理解 SPFA 如何用队列减少无效松弛,以及
inQueue标记的作用。 - 能实现带可达负环检测的 SPFA,并读懂距离更新与重新入队的条件。
- 能识别 SPFA 的最坏情况风险,并根据图的约束选择更稳定的算法。
队列优化了什么
Bellman-Ford 每一轮都会扫描全部边,即使很多顶点的距离根本没有变化。SPFA 的想法是:只有当某个顶点 u 的距离变短后,从 u 出发的边才可能产生新的有效松弛,因此把这类顶点放入队列等待处理。
顶点出队后扫描其出边;若某个邻点 v 的距离被更新,而且 v 当前不在队列中,就把它重新入队。inQueue 用来避免同一顶点在同一时刻重复排队,但它不能阻止一个顶点在整个运行过程中被反复入队。
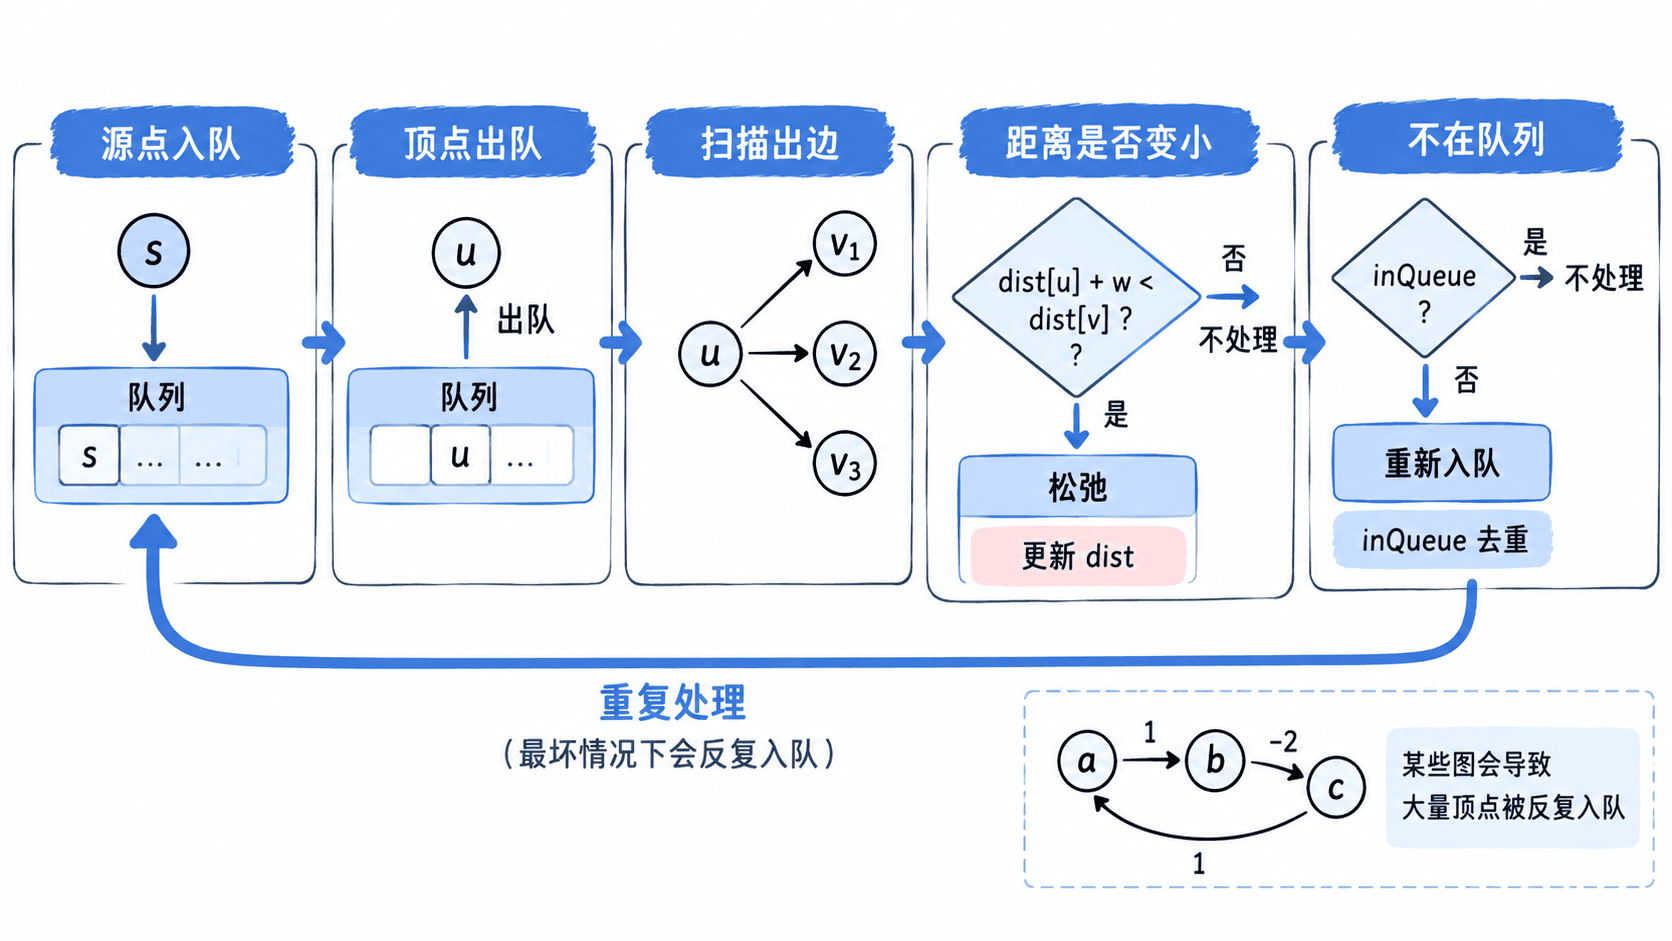
这种机制减少的是“平均情况下的无效扫描”,并没有改变算法的最坏情况上界。
为什么会退化
如果一次更新不断触发后续顶点变短,而这些顶点又反过来影响前面的顶点,队列就会频繁震荡。某些特殊图会让大量顶点被反复入队,最终工作量接近 Bellman-Ford 的 。
常见的 SLF、LLL 等启发式策略会调整队列中顶点的处理顺序,有时能改善实际性能,但它们不能给出更好的最坏复杂度保证。因此,不能因为随机数据上跑得快,就把 SPFA 当成“比 Bellman-Ford 更优”的通用结论。
完整实现与验证
下面使用邻接表和双端队列实现 SPFA。edge_count[v] 记录当前使 dist[v] 取得最优值的路径边数;若达到顶点数,说明这条改进路径中包含环,而且严格变短只能由可达负环造成。
from collections import deque
from math import inf

def spfa(n, edges, source):
    graph = [[] for _ in range(n)]
    for u, v, w in edges:
        graph[u].append((v, w))

    dist = [inf] * n
    in_queue = [False] * n
    edge_count = [0] * n
    dist[source] = 0

    q = deque([source])
    in_queue[source] = True

    while q:
        u = q.popleft()
        in_queue[u] = False

        for v, w in graph[u]:
            new_dist = dist[u] + w
            if new_dist < dist[v]:
                dist[v] = new_dist
                edge_count[v] = edge_count[u] + 1

                if edge_count[v] >= n:
                    return None, True

                if not in_queue[v]:
                    q.append(v)
                    in_queue[v] = True

    return dist, False

def main():
    edges = [
        (0, 1, 4),
        (0, 2, 5),
        (1, 2, -2),
        (1, 3, 6),
        (2, 3, 3),
        (3, 4, 2),
    ]
    dist, has_negative_cycle = spfa(5, edges, 0)
    printable = [None if d == inf else int(d) for d in dist]
    print("dist =", printable)
    print("negative_cycle =", has_negative_cycle)

if __name__ == "__main__":
    main()
预期输出
dist = [0, 4, 2, 5, 7]
negative_cycle = False
这个结果与 Bellman-Ford 一致,但处理顺序由“哪些顶点刚刚变短”决定,而不是固定扫描全部边。实际耗时因此高度依赖图结构和数据分布。
什么时候不该优先用 SPFA
边权全部非负时,优先使用带优先队列的 Dijkstra;图是 DAG 时,拓扑序最短路更直接;存在负权边且需要可预测的复杂度时,Bellman-Ford 虽然慢,但上界清晰。
SPFA 更适合你明确接受最坏情况风险、图规模和数据分布经过验证,而且负权边确实存在的场景。把“常常很快”误解成“复杂度更好”,正是它最常见的误用来源。