
数据结构与算法 / 系统课时
二分图最大匹配怎么建模
二分图最大匹配怎么建模
当问题要求“把两类对象一一配对,并让成功配对数尽量多”时,常常可以直接建模为二分图最大匹配。本节用任务分配场景说明如何识别左右两侧顶点、构造边,并通过增广路理解为什么匹配还能继续扩大。
学习目标
- 能把两类对象及其兼容关系转换为二分图
- 理解匹配、最大匹配与增广路之间的关系
- 能实现并验证基于 DFS 的增广路算法
先把业务关系翻译成二分图
二分图的关键不是“图长什么样”,而是顶点能否被分成两个集合,且边只跨集合连接。比如有 3 名工程师 A、B、C 和 3 个任务 1、2、3,工程师只能接自己擅长的任务,那么工程师放在左侧、任务放在右侧,每条“可以承担”的关系就是一条边。
最大匹配要求选出尽量多条边,同时任何顶点最多出现在一条被选中的边里。也就是说,一名工程师最多分到一个任务,一个任务也只能交给一名工程师。
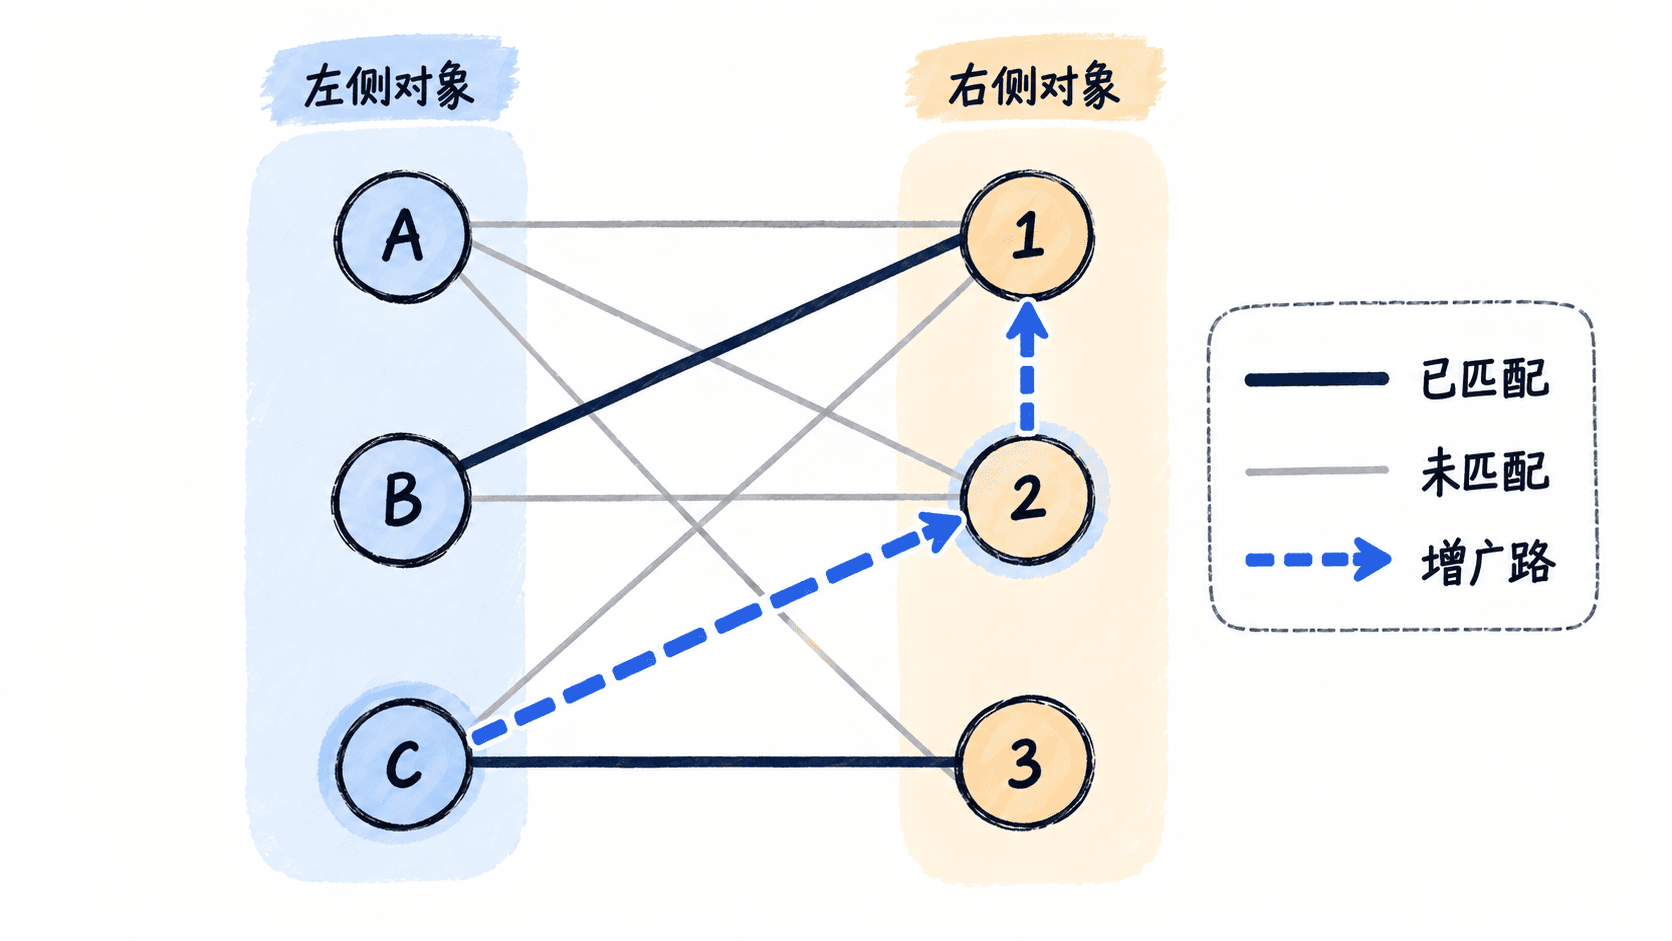
建模时最容易犯的错,是把“同一侧内部的关系”也当成匹配边。例如工程师之间的协作关系不是本问题的匹配边;只有“工程师能否执行某任务”才决定左右两侧之间是否连边。
增广路为什么能让匹配多一条
假设当前已有若干匹配边。若从一个尚未匹配的左侧顶点出发,沿“未匹配边、已匹配边、未匹配边……”交替前进,最后到达一个尚未匹配的右侧顶点,就找到了一条增广路。
把这条路上的状态全部翻转:原来未匹配的边改成匹配边,原来匹配的边取消匹配。因为路径首尾原本都空闲,翻转后总匹配数恰好增加 1。算法不断寻找这样的路径,直到再也找不到增广路时,当前匹配就是最大匹配。
这也是实现时“尝试抢占一个已分配任务,再让原持有者改找别的任务”的本质。
用 DFS 实现增广过程
下面用邻接表保存“每个左侧顶点可以连接哪些右侧顶点”。match_right[v] 记录右侧顶点 v 当前匹配到的左侧顶点;每次尝试为一个左侧顶点找位置时,都重新创建 visited,避免同一轮搜索反复访问同一个右侧顶点。
def maximum_bipartite_matching(graph, right_size):
    match_right = [-1] * right_size

    def augment(left, visited):
        for right in graph[left]:
            if visited[right]:
                continue
            visited[right] = True

            # 右侧空闲,或原匹配对象还能改配到别处,就占用该位置
            if match_right[right] == -1 or augment(match_right[right], visited):
                match_right[right] = left
                return True
        return False

    matched = 0
    for left in range(len(graph)):
        visited = [False] * right_size
        if augment(left, visited):
            matched += 1

    pairs = []
    for right, left in enumerate(match_right):
        if left != -1:
            pairs.append((left, right))
    return matched, pairs

if __name__ == "__main__":
    graph = [
        [0, 1],  # A -> 任务 1、2
        [0, 2],  # B -> 任务 1、3
        [1],     # C -> 任务 2
    ]

    count, pairs = maximum_bipartite_matching(graph, right_size=3)
    print("最大匹配数:", count)
    print("匹配结果:", sorted(pairs))
预期输出
最大匹配数: 3
匹配结果: [(0, 0), (1, 2), (2, 1)]
结果表示三个左侧对象都成功匹配。具体匹配组合可能因遍历顺序不同而变化,但最大匹配数应保持不变。
复杂度与建模边界
设左侧顶点数为 ,边数为 。这种逐个左侧顶点执行 DFS 寻找增广路的实现,时间复杂度通常记为 ,空间复杂度为 。对于中小规模匹配问题,这个实现足够直观;数据规模更大时,可考虑 Hopcroft-Karp 算法,将复杂度降低到 。
只有“每个对象最多匹配一次”的问题才能直接套用普通二分图最大匹配。如果一个人可承担多个任务、任务有容量限制,问题会更接近多重匹配或网络流。若边还带有收益、成本并要求总收益最大,则需要进一步使用带权匹配或最小费用最大流,而不是仅比较匹配数量。
判断建模是否正确时,可以先问两个问题:是否能明确分出左右两类对象;每条合法关系是否只连接左右两侧。只要这两点成立,最大匹配往往就是自然的求解起点。