
数据结构与算法 / 系统课时
最短路题怎么快速选算法
最短路题怎么快速选算法
最短路题真正难的常常不是写算法,而是先选对算法。可以把选择压缩成四个问题:查询是单源还是全源、边权是否受限、图是否有负权或负环、点边规模多大;按这个顺序筛选,能快速排除大多数误用。
学习目标
- 根据查询模式、边权性质和图规模筛选候选算法
- 区分 BFS、0-1 BFS、Dijkstra、Bellman-Ford、Floyd 与 Johnson 的适用条件
- 识别负权、负环和稠密图带来的算法边界
先看查询模式和边权
如果只问一个源点到其他点的距离,就优先考虑单源算法;如果要回答大量任意点对查询,再考虑一次性预处理全源距离。接着检查边权,因为这一步会直接决定能否使用更快的专用算法。
| 图的条件 | 常用选择 | 典型复杂度 | 关键限制 |
|---|---|---|---|
| 无权图或所有边权相同 | BFS | 按层扩展即可 | |
| 边权只有 0 和 1 | 0-1 BFS | 用双端队列 | |
| DAG,边权任意 | 拓扑序动态规划 | 图必须无环 | |
| 一般图,边权非负 | Dijkstra + 堆 | 不能有负权边 | |
| 一般图,有负权边 | Bellman-Ford | 可检测源点可达负环 | |
| 小规模全源查询 | Floyd-Warshall | 需要 空间 | |
| 稀疏图全源、含负权但无负环 | Johnson | 约 | 实现更复杂 |
表里的复杂度用于快速判断数量级,不是绝对阈值。真正能跑多大还取决于语言、常数、内存限制和数据分布,所以比赛或工程中仍要结合具体约束估算。
用决策顺序排除误用
最稳妥的思路不是背“某算法适合某题”,而是按限制逐层排除。先看图是否有特殊结构,再看边权,最后结合查询次数和规模决定是否值得做全源预处理。
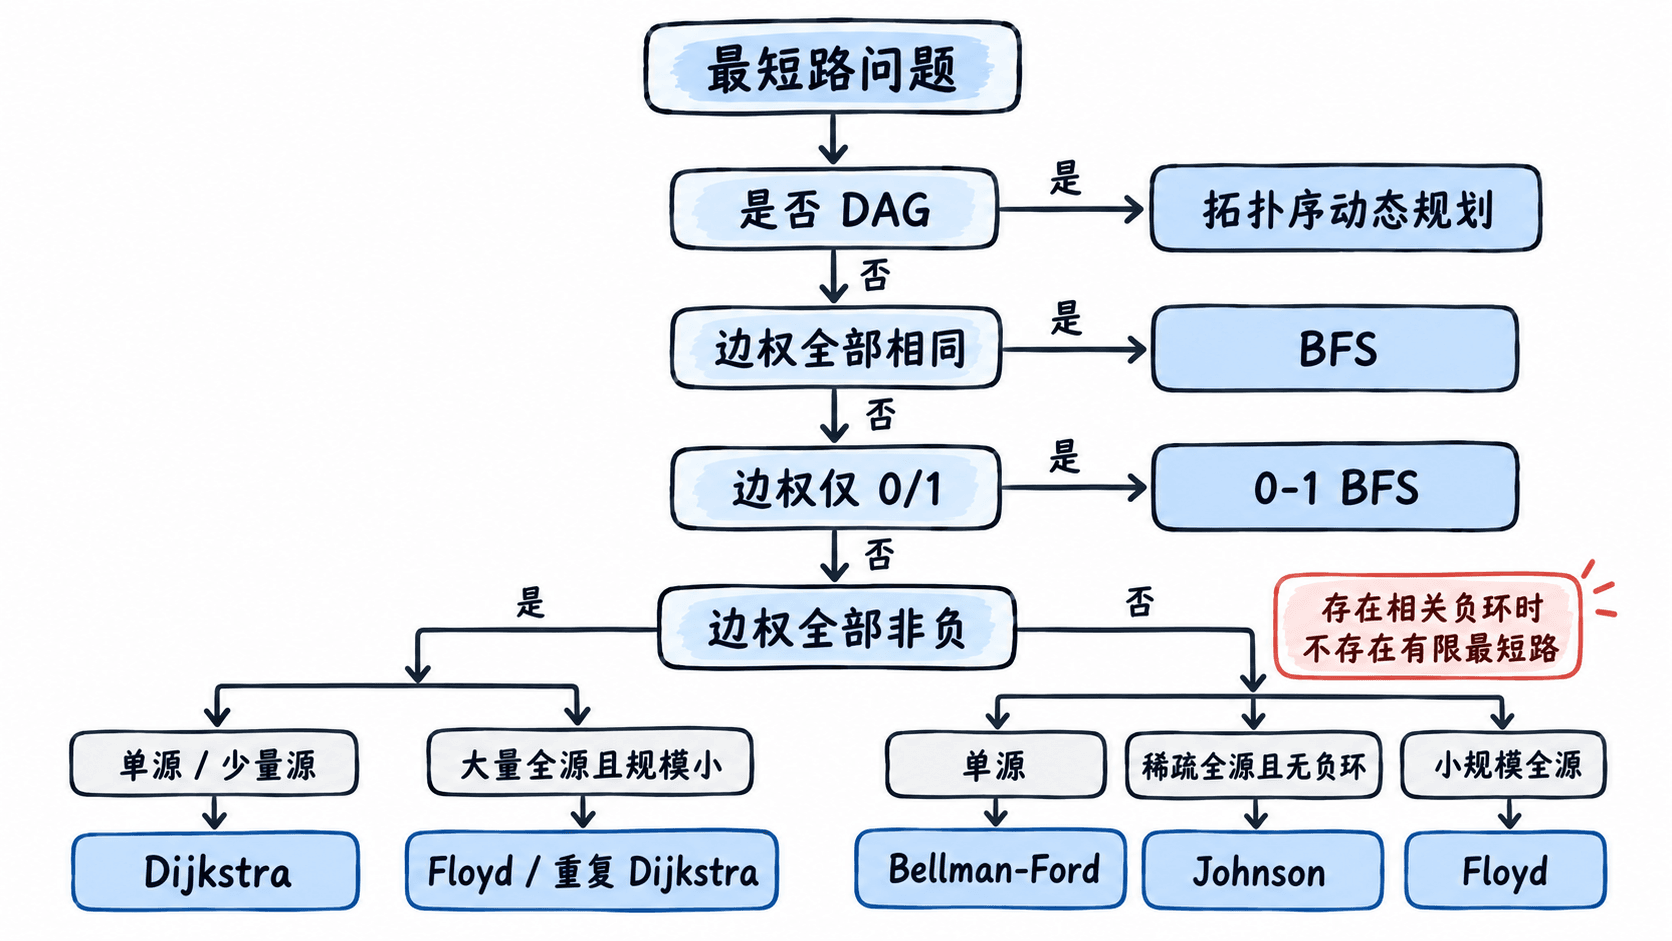
实际做题时可以按下面的顺序判断:
- 先看是否是 DAG。 如果图天然无环,拓扑序上的松弛可以在线性时间内完成,而且允许负权边。
- 再看边权是否特殊。 无权图用 BFS,只有 0/1 权值用 0-1 BFS,不需要堆。
- 一般非负权图优先 Dijkstra。 尤其是边远少于 的稀疏图,邻接表加堆通常最实用。
- 出现负权边就排除 Dijkstra。 单源可考虑 Bellman-Ford;若存在可达负环,则相关最短路没有有限值。
- 全源查询再比较预处理成本。 小规模或较稠密图常用 Floyd;稀疏大图更适合多次 Dijkstra,存在负权且无负环时可考虑 Johnson。
规模决定理论上能不能跑
选择算法时要同时估算时间和内存。例如 时,Floyd 大约需要执行 次状态尝试,是否可接受要看语言和时间限制;若 ,仅 个距离单元就已经很难存放,Floyd 通常可以直接排除。
Dijkstra 更依赖边数。如果 很大但 只与 同数量级,邻接表加堆可以只访问真实存在的边;反过来,图接近完全图时,堆的优势会缩小,此时应结合实现常数、矩阵表示和查询次数重新评估。
三个高频陷阱
看到负权边还用 Dijkstra 是最常见错误。Dijkstra 的“最小未确定距离一旦取出就不会再变”依赖非负权;负边会破坏这个前提,即使图里没有负环也不能保证正确。
把 SPFA 当作稳定的 Bellman-Ford 加速版 也有风险。它在部分数据上很快,但最坏复杂度仍可能退化到 ,而且容易被构造数据拖慢,所以不应仅凭“有负权”就默认选择 SPFA。
忽略查询次数 会导致重复做无谓计算。只问一次源点时没必要先算全源;反过来,如果同一张小图要回答成千上万次点对查询,先用 Floyd 预处理,之后每次查询 ,往往比反复跑单源算法更合适。
一张纸上的选择规则
遇到题目时,先圈出 V、E、边权范围、是否有负边、是否可能有负环、查询源点数量,再决定算法。没有这些信息就直接套模板,最容易出现“代码写对了但复杂度或前提错了”的问题。
可以记住最短的判断链:特殊结构先用专用算法;非负一般图用 Dijkstra;负权单源用 Bellman-Ford;小规模全源用 Floyd;稀疏全源再考虑重复 Dijkstra 或 Johnson。