
数据结构与算法 / 系统课时
Dinic 怎样加速最大流
Dinic 怎样加速最大流
最大流的难点不在“能不能找到一条增广路”,而在于如何减少重复搜索。Dinic 把残量网络分阶段处理:先用 BFS 建立分层图,再用 DFS 一次尽量推满这一层的可行流,从而显著减少无效增广。
学习目标
- 理解分层图、可行边与阻塞流分别解决什么问题。
- 能实现带当前弧优化的 Dinic,并验证最大流结果。
- 知道 Dinic 的复杂度、适用范围和常见调试不变量。
为什么分层能减少无效搜索
任意增广算法都在残量网络上工作:一条边还有剩余容量时可以继续向前送流,已经送出的流又会通过反向边提供“撤销”空间。若每次只是随意找一条增广路,搜索容易反复经过已经证明无效的区域。
Dinic 每一轮先从源点做 BFS,记录每个点到源点的最短层数。之后只允许沿满足 level[v] = level[u] + 1 的残量边前进,这些边组成分层图。DFS 因而不会在同一轮里走回头路,也不会沿着更长的绕行路径尝试送流。
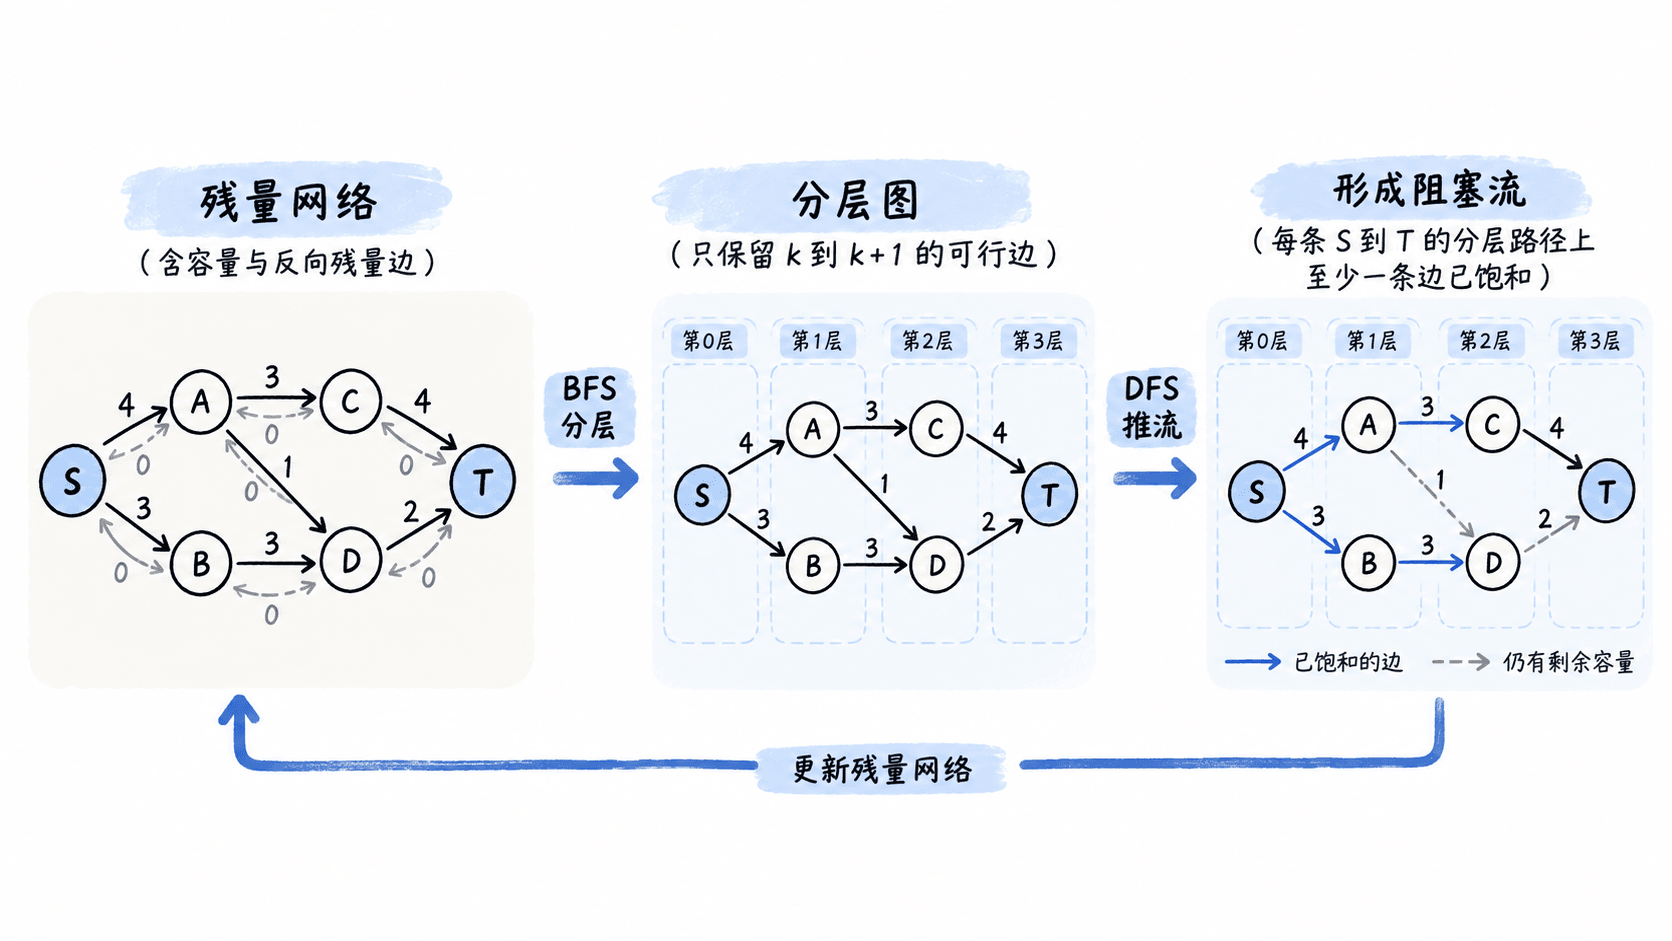
一轮阻塞流完成后,当前分层图中已经不存在还能继续增广的源汇路径。若下一轮汇点仍可达,新的最短源汇距离会严格增加;若汇点已经不可达,当前流就是最大流。
阻塞流和当前弧优化
“阻塞”并不表示分层图里的所有边都饱和,而是表示每一条从源点到汇点的分层路径上,至少有一条边已经没有剩余容量。这样,本轮继续在旧分层图里搜索也不会再增加总流量。
实现时通常再维护 ptr[u],记录节点 u 下一条尚未彻底检查的邻接边。某条边已经满流、层级不合法,或递归后无法继续送流,就不必在同一轮里从头检查。这个当前弧优化对实际性能很重要。
实现一个可运行的 Dinic
下面使用邻接表保存残量边。每次加入容量为 c 的正向边,同时加入容量为 0 的反向边;推流时同时减少正向残量、增加反向残量。
from collections import deque
from dataclasses import dataclass

@dataclass
class Edge:
    to: int
    rev: int
    cap: int

class Dinic:
    def __init__(self, n: int):
        self.g = [[] for _ in range(n)]
        self.level = [-1] * n
        self.ptr = [0] * n

    def add_edge(self, u: int, v: int, cap: int) -> None:
        # rev 互相指向对方,更新残量时可以 O(1) 找到反向边。
        fwd = Edge(v, len(self.g[v]), cap)
        rev = Edge(u, len(self.g[u]), 0)
        self.g[u].append(fwd)
        self.g[v].append(rev)

    def bfs(self, s: int, t: int) -> bool:
        self.level = [-1] * len(self.g)
        self.level[s] = 0
        q = deque([s])

        while q:
            u = q.popleft()
            for e in self.g[u]:
                if e.cap > 0 and self.level[e.to] == -1:
                    self.level[e.to] = self.level[u] + 1
                    q.append(e.to)

        return self.level[t] != -1

    def dfs(self, u: int, t: int, pushed: int) -> int:
        if u == t or pushed == 0:
            return pushed

        while self.ptr[u] < len(self.g[u]):
            i = self.ptr[u]
            e = self.g[u][i]

            if e.cap > 0 and self.level[e.to] == self.level[u] + 1:
                flow = self.dfs(e.to, t, min(pushed, e.cap))
                if flow > 0:
                    # 正向减少、反向增加,始终保持合法残量网络。
                    e.cap -= flow
                    self.g[e.to][e.rev].cap += flow
                    return flow

            self.ptr[u] += 1

        return 0

    def max_flow(self, s: int, t: int) -> int:
        # 每次 BFS 固定一张分层图,内层 DFS 负责求这一层的阻塞流。
        total = 0
        inf = 10**18

        while self.bfs(s, t):
            self.ptr = [0] * len(self.g)
            while True:
                pushed = self.dfs(s, t, inf)
                if pushed == 0:
                    break
                total += pushed

        return total

if __name__ == "__main__":
    dinic = Dinic(6)
    for u, v, c in [
        (0, 1, 10), (0, 2, 10), (1, 2, 2),
        (1, 3, 4), (1, 4, 8), (2, 4, 9),
        (4, 3, 6), (3, 5, 10), (4, 5, 10),
    ]:
        dinic.add_edge(u, v, c)

    print(dinic.max_flow(0, 5))
预期输出
19这个结果表示:在给定容量约束下,从节点 0 到节点 5 最多可以同时输送 19 单位流量。若把边容量替换成任务配额、带宽或可分配资源,算法本身不需要改变。
复杂度与使用边界
对一般有向容量网络,Dinic 的常用最坏复杂度上界是 ,空间复杂度为 。它的优势主要来自“按层批量处理增广路”,因此在大量常见稀疏图上通常比逐条找增广路更实用。
容量必须是非负值。整数容量最省心;若使用浮点容量,需要自行处理精度阈值,否则“接近 0 的残量”可能让 BFS 或 DFS 反复访问本应视为饱和的边。对于超大或非常稠密的网络,还应根据数据规模比较 Push-Relabel 等算法。
调试时检查这些不变量
先检查层级:源点层数应为 0,DFS 只走到下一层。再检查残量:正向边减少多少,反向边就必须增加多少,任何残量容量都不能为负。最后检查阶段结束条件:当一轮 DFS 已无法再从源点推出流时才重建分层图。
如果最大流明显偏小,最常见的问题不是 BFS 本身,而是反向边索引、残量更新或 ptr 推进时机写错。把这三个不变量逐项打印验证,通常能很快定位实现错误。