
数据结构与算法 / 系统课时
字典序拓扑序怎么处理
字典序拓扑序怎么处理
普通拓扑排序只要求依赖合法,因此同一张 DAG 往往有多个答案。如果题目还要求在所有合法结果中取字典序最小的序列,就不能随意选择入度为 0 的节点,而要始终选择当前可选集合里最小的那个。
学习目标
- 理解“字典序最小”是在每一步对当前可选节点做局部最小选择。
- 会用最小堆维护所有入度为 0 的节点,并完成拓扑排序。
- 能判断何时不存在合法拓扑序,而不是返回不完整结果。
关键变化是选择策略
Kahn 拓扑排序维护“当前入度为 0 的节点集合”。普通实现可以使用队列,谁先进入就先处理;字典序最小版本则必须使用最小优先队列,让每次弹出的节点都是当前集合中标签最小的节点。
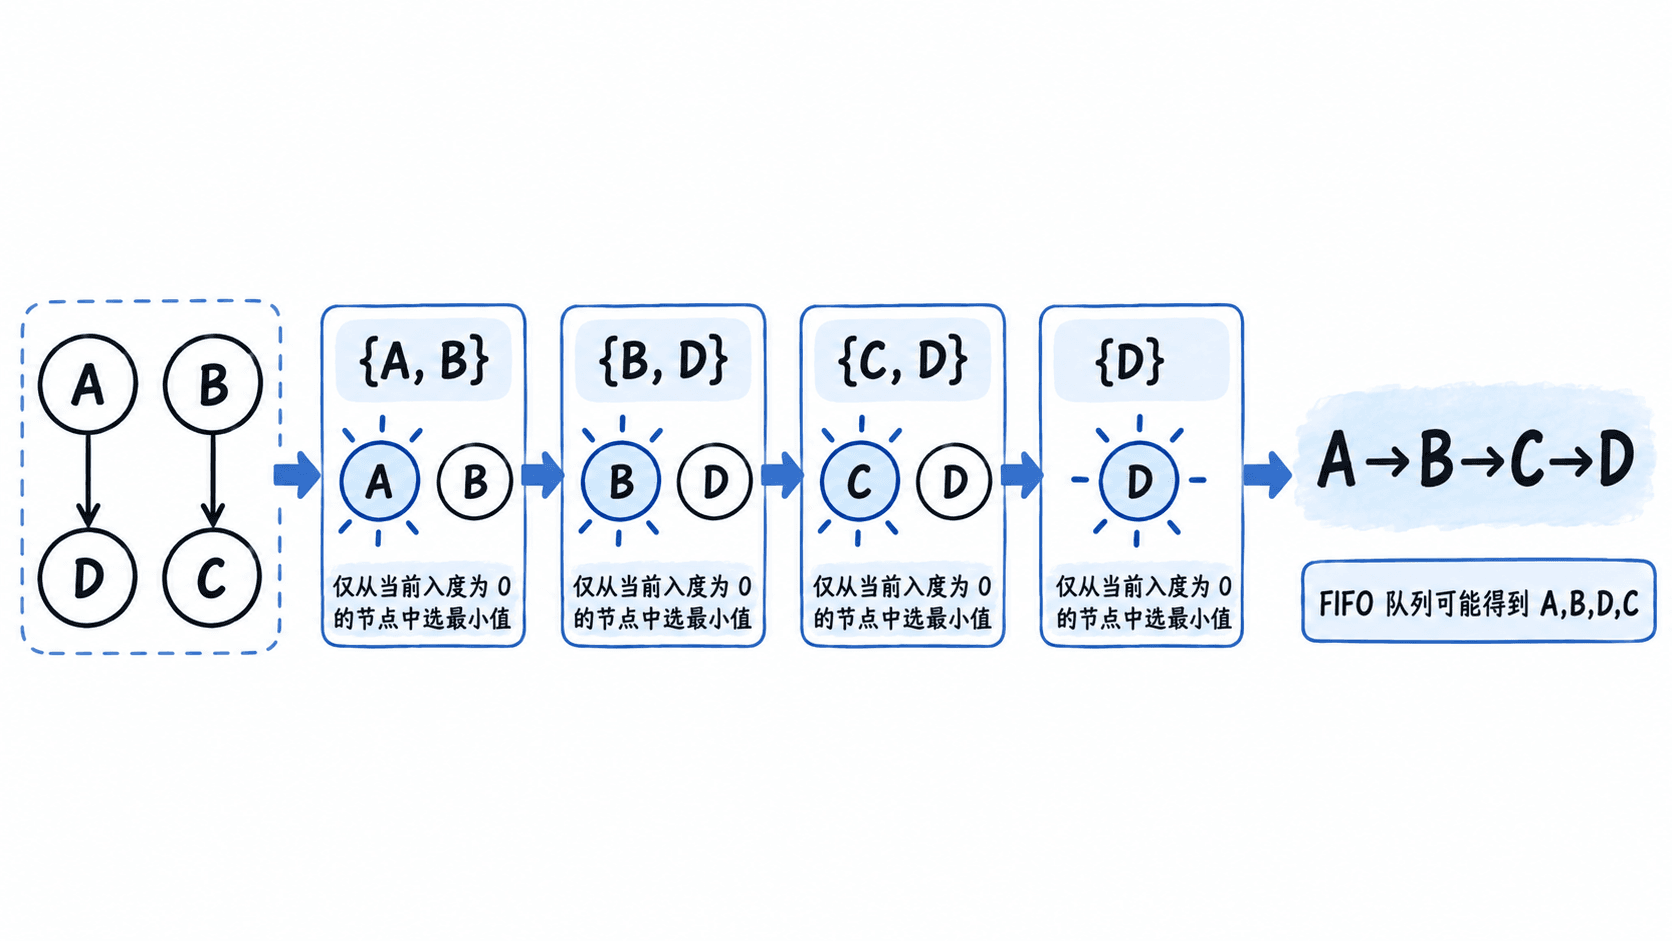
例如依赖为 A -> D、B -> C。开始时 A、B 都可选,先取 A 后,D 也变为可选;此时集合是 B、D,必须继续选择较小的 B。处理 B 后,C 加入候选,再从 C、D 中选择 C,最终得到 A B C D。
为什么贪心选择成立
每一步只能从入度为 0 的节点中选择,否则会破坏依赖约束。若当前候选集合里有多个节点,选择其中最小者不会让后续失去合法性,因为这些候选节点都已经没有未完成前驱,先处理哪一个都不会违反现有依赖。
字典序比较会在第一个不同位置决定大小,所以当前能放在这一位置的最小节点必须立即选择。若此时选择更大的节点,即使后续排列再小,也无法弥补当前这一位已经变大的事实。
用最小堆实现
Python 的 heapq 是最小堆,正好可以维护所有入度为 0 的节点。每次弹出堆顶节点加入答案,再删除它的出边;某个后继入度降到 0 时立刻入堆,继续参与下一轮最小值竞争。
import heapq

nodes = ["A", "B", "C", "D"]
edges = [
    ("A", "D"),
    ("B", "C"),
]

graph = {node: [] for node in nodes}
indegree = {node: 0 for node in nodes}

for u, v in edges:
    graph[u].append(v)
    indegree[v] += 1

heap = []

for node in nodes:
    if indegree[node] == 0:
        heapq.heappush(heap, node)

order = []

while heap:
    # 堆顶始终是当前所有可选节点中字典序最小的节点。
    u = heapq.heappop(heap)
    order.append(u)

    for v in graph[u]:
        indegree[v] -= 1
        if indegree[v] == 0:
            heapq.heappush(heap, v)

if len(order) != len(nodes):
    raise ValueError("graph contains a cycle")

print(" ".join(order))
预期输出
A B C D复杂度与边界
构图和更新入度需要遍历所有顶点与边。每个节点最多入堆、出堆各一次,堆大小最多为顶点数,因此总复杂度为 ;空间复杂度为 。若节点是整数,最小堆按数值大小排序;若节点是字符串,则按语言运行时定义的字符串比较规则排序。
当需求只是得到任意合法拓扑序时,普通队列实现更直接;只有在题目、构建系统或任务调度明确要求稳定且最小的顺序时,才需要把候选集合替换为最小优先队列。