
数据结构与算法 / 系统课时
DFS 为什么能走完整张图
DFS 为什么能走完整张图
DFS 看起来只是“沿一条路走到底再回退”,但它之所以不会漏掉可达节点,关键在于每个首次访问的节点都会扫描全部邻边,同时用 visited 阻止重复进入。本节用递归与显式栈对照同一张图,并说明非连通图为何还需要外层循环。
学习目标
- 解释 DFS 为什么能覆盖起点所在的整个连通分量。
- 理解递归调用栈与显式栈版本之间的一一对应关系。
- 正确处理环、重复边与非连通图,避免漏点或无限递归。
覆盖可达节点靠两个不变量
DFS 维护两个关键事实:节点第一次被取出处理时立即标记为已访问;一个已访问节点的每条邻边最终都会被检查。于是只要从起点到节点 存在一条路径,DFS 就会沿着这条路径逐层发现 。
visited 不是性能装饰,而是正确性条件。图中有环时,如果进入节点后不记录访问状态,递归版本会在环上反复调用,显式栈版本也会不断压入已经见过的节点。
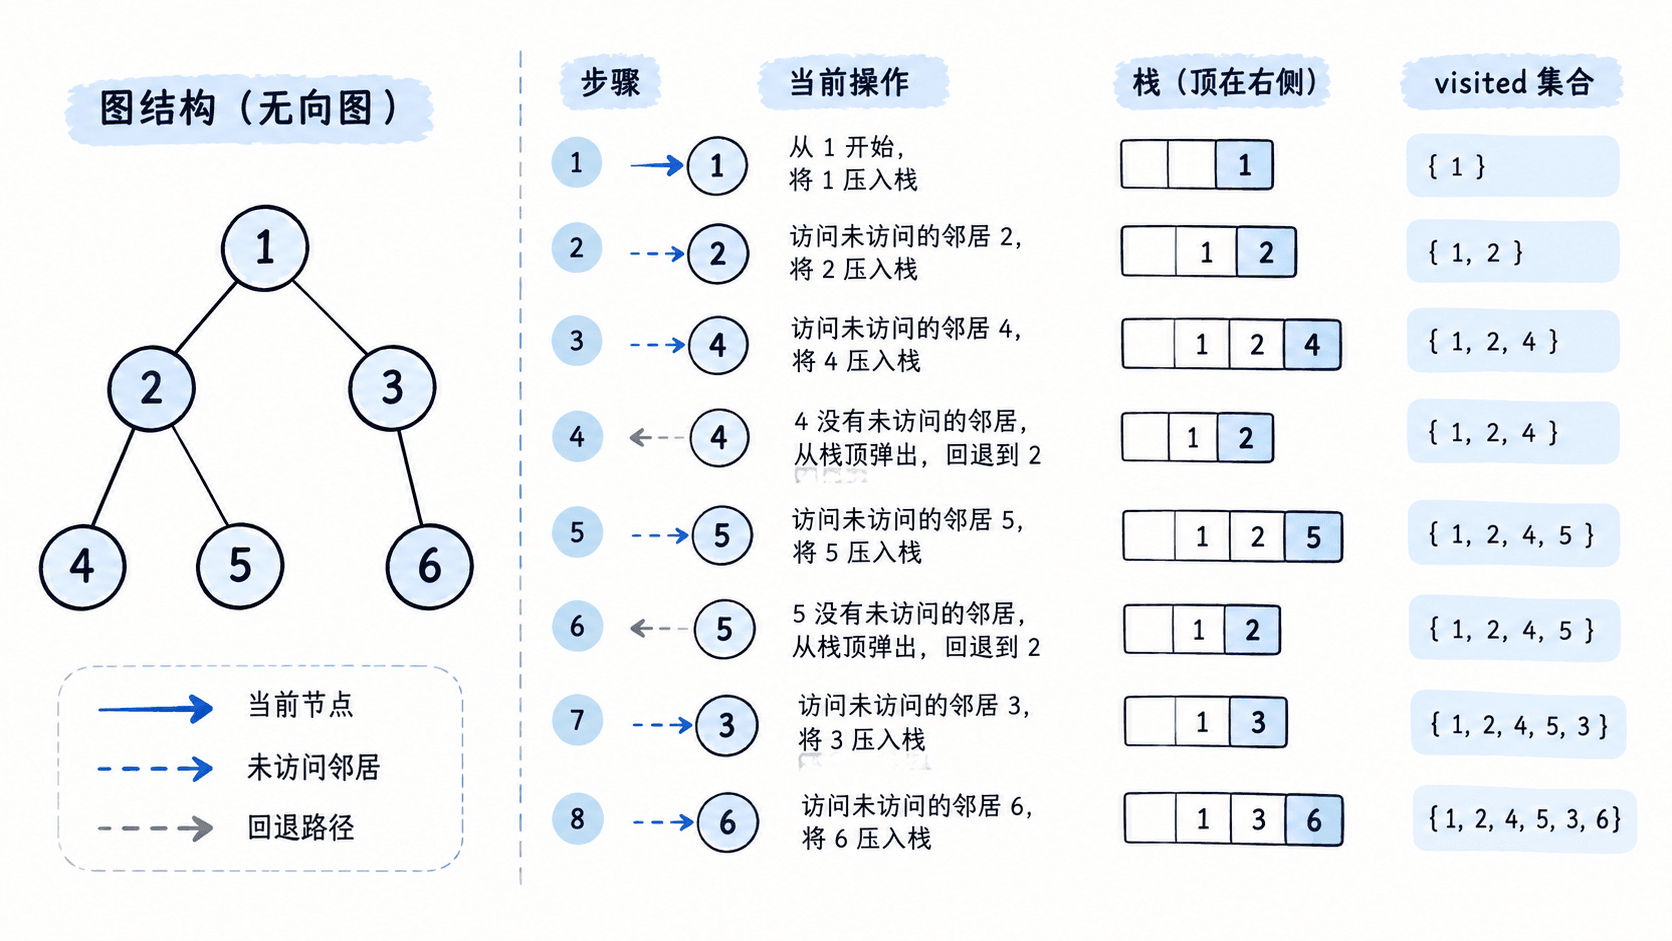
递归与显式栈只是保存现场的方式不同
递归 DFS 把“当前节点扫描到哪里、结束后返回谁”交给语言运行时调用栈保存;显式栈则由程序自己保存待处理节点。只要二者使用相同的邻接顺序,并在合适时机标记 visited,它们覆盖的节点集合相同。
若希望显式栈得到与递归版相同的访问顺序,通常要逆序压入邻居。原因是栈后进先出:递归先访问较小邻居时,显式栈应让它最后入栈、最先弹出。
用同一张图对照两个版本
下面程序构造一张含两个连通分量的无向图。递归版和显式栈版都通过外层循环处理尚未访问的节点,因此会覆盖整张图,而不只是节点 1 所在的分量。
#include <algorithm>
#include <iostream>
#include <stack>
#include <vector>

using namespace std;

void dfs_recursive(int u, const vector<vector<int>>& graph,
                   vector<char>& visited, vector<int>& order) {
    visited[u] = true;
    order.push_back(u);

    for (int v : graph[u]) {
        if (!visited[v]) {
            dfs_recursive(v, graph, visited, order);
        }
    }
}

vector<int> run_recursive(const vector<vector<int>>& graph) {
    vector<char> visited(graph.size(), false);
    vector<int> order;

    for (int start = 1; start < static_cast<int>(graph.size()); ++start) {
        if (!visited[start]) {
            dfs_recursive(start, graph, visited, order);
        }
    }
    return order;
}

vector<int> run_iterative(const vector<vector<int>>& graph) {
    vector<char> visited(graph.size(), false);
    vector<int> order;

    for (int start = 1; start < static_cast<int>(graph.size()); ++start) {
        if (visited[start]) {
            continue;
        }

        stack<int> st;
        st.push(start);
        while (!st.empty()) {
            int u = st.top();
            st.pop();

            if (visited[u]) {
                continue;
            }
            visited[u] = true;
            order.push_back(u);

            // 逆序压栈,使较小编号邻居先被弹出。
            for (auto it = graph[u].rbegin(); it != graph[u].rend(); ++it) {
                if (!visited[*it]) {
                    st.push(*it);
                }
            }
        }
    }
    return order;
}

void print_order(const vector<int>& order) {
    for (size_t i = 0; i < order.size(); ++i) {
        if (i > 0) {
            cout << ' ';
        }
        cout << order[i];
    }
    cout << '\n';
}

int main() {
    const int n = 8;
    vector<vector<int>> graph(n + 1);

    const vector<pair<int, int>> edges = {
        {1, 2}, {1, 3}, {2, 4}, {2, 5}, {3, 6}, {7, 8}
    };

    for (auto [u, v] : edges) {
        graph[u].push_back(v);
        graph[v].push_back(u);
    }
    for (auto& neighbors : graph) {
        sort(neighbors.begin(), neighbors.end());
    }

    print_order(run_recursive(graph));
    print_order(run_iterative(graph));
    return 0;
}
预期输出:
1 2 4 5 3 6 7 8
1 2 4 5 3 6 7 8
两行一致不是 DFS 的硬性要求,而是这个示例通过排序邻接表和逆序压栈刻意保持了同一访问次序。真实程序只要覆盖集合正确,合法 DFS 顺序可能不止一种。
什么时候递归会变成风险
递归版最简洁,但图的深度可能接近节点数。若存在很长的链,调用深度过大可能触发栈溢出;此时显式栈更可控,也更适合需要保存额外遍历状态的实现。
无论使用哪种写法,邻接表上的 DFS 时间复杂度都是 ,因为每个节点至多完成一次首次访问,每条边只会被有限次检查。空间复杂度是 加图本身的存储,其中递归调用栈或显式栈在最坏情况下都可能达到 。
真正需要记住的边界是:一次从起点发起的 DFS 只保证覆盖该起点的可达区域;要“走完整张图”,必须对所有尚未访问的节点继续启动 DFS。