
游戏引擎 / 系统课时
用批处理减少重复工作
用批处理减少重复工作
上百个敌人或血条同时变化时,真正浪费 CPU 的往往不是一次计算,而是同帧重复查找同一数据、反复写入相同界面属性,以及大量分散的小回调。本课以 Cocos Creator 3.8 的血条刷新为例,将多次更新请求合并为每帧一次批量提交,并说明何时需要进一步分帧。
学习目标
- 找出重复取值、重复状态写入和分散回调的开销来源。
- 实现按对象去重的更新队列,并在帧末集中刷新。
- 理解连续数据存储的收益和批处理的正确性边界。
找出可以合并的工作
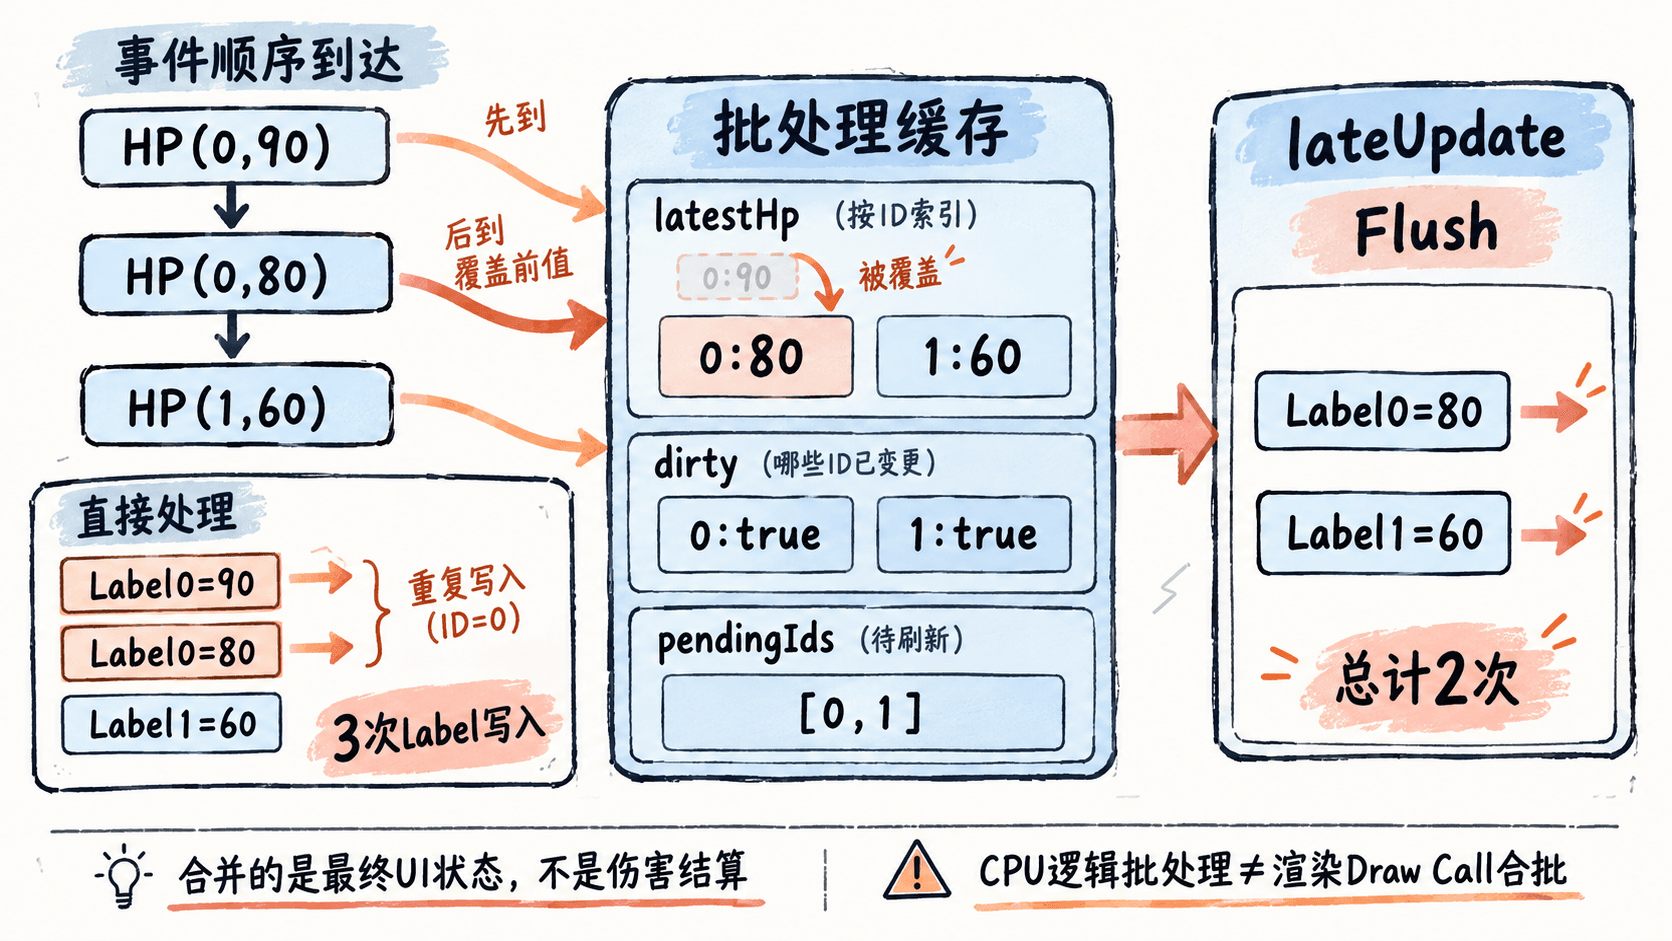
假设同一帧中,角色 0 的生命值依次变成 90 和 80,角色 1 的生命值变成 60。若每次变化都立即设置 Label.string,就发生三次 UI 写入;如果界面只需要展示帧末最新生命值,最终只需要写两次。
批处理并非简单把循环挪到另一个函数,而是让重复读共享数据、重复写同一目标、重复触发昂贵接口的次数下降。需要保留每次伤害用于结算或回放时,不能把伤害事件本身丢弃;这里只合并最终可见的 UI 状态。
用一个组件收集并刷新
在 Canvas 下准备两个带 Label 组件的血条文本,把以下 BatchedHpUI.ts 挂在活动节点上,并按角色 ID 顺序绑定 hpLabels 数组。业务系统收到生命值变化时调用 queueHp(id, hp);示例的 start() 模拟同帧连续事件,可直接在预览中检查行为。
import { _decorator, Component, Label, log, warn } from 'cc';
const { ccclass, property } = _decorator;

@ccclass('BatchedHpUI')
export class BatchedHpUI extends Component {
  @property([Label]) hpLabels: Label[] = [];

  private latestHp = new Float32Array(0);
  private dirty = new Uint8Array(0);
  private readonly pendingIds: number[] = [];

  onLoad(): void {
    // 数值和脏标记连续存放,避免为每次事件新建对象
    this.latestHp = new Float32Array(this.hpLabels.length);
    this.dirty = new Uint8Array(this.hpLabels.length);
  }

  start(): void {
    if (this.hpLabels.length < 2) {
      warn('至少绑定两个血条 Label');
      return;
    }
    this.queueHp(0, 90);
    this.queueHp(0, 80);
    this.queueHp(1, 60);
  }

  public queueHp(id: number, hp: number): void {
    if (!Number.isInteger(id) || id < 0 ||
        id >= this.hpLabels.length || !Number.isFinite(hp)) return;
    // 同一ID在本帧只保留最新的可见数值
    this.latestHp[id] = Math.max(0, hp);
    if (this.dirty[id] === 0) {
      this.dirty[id] = 1;
      this.pendingIds.push(id);
    }
  }

  lateUpdate(): void {
    if (this.pendingIds.length === 0) return;
    let writes = 0;
    for (const id of this.pendingIds) {
      const label = this.hpLabels[id];
      if (label && label.isValid) {
        label.string = String(Math.round(this.latestHp[id]));
        writes++;
      }
      this.dirty[id] = 0;
    }
    this.pendingIds.length = 0;
    log(`本帧实际写入=${writes}`);
  }
}
预期输出(两个 Label 有效,首次批量提交):
本帧实际写入=2页面上第一个血条显示 80,第二个显示 60。同帧若再收到十次角色 0 的绝对生命值更新,它仍只在刷新时写一次。事件若在本帧 lateUpdate 之后到达,将在下一帧提交。
数据局部性和批量循环
Float32Array 与 Uint8Array 把数值和脏标记按 ID 放在连续内存中,循环可复用缓冲区;pendingIds 仅记录变更对象,避免每帧扫描全部血条。真实战斗中还可以将共同使用的目标位置、配置常量或查询结果移到循环外,只读取一次。
对上百个单位的移动或 AI 计算,可让一个管理器集中遍历连续状态数组,减少重复回调与中间对象;但每个单位必须更新的世界变换依然要做。这里降低的是脚本和属性写入次数,并不等于渲染层减少 Draw Call。
合并与分帧不能混用语义
最终状态覆盖适用于血量显示、进度文字或地图标记;累计伤害、金币增量及需要逐条触发的音效则不能直接“最后值胜出”。涉及物理积分、命中判定和严格顺序的事件,要保留完整处理顺序。
当多个不同对象都有不可省略的昂贵工作时,可改用固定预算的轮询队列,把非实时任务分散到数帧;此时需要明确最大允许延迟,不能把每帧必需的物理更新随意延后。
用可观察指标判断收益
对比改造前后的每帧消息数、实际 Label.string 写入次数、脚本耗时和 P95/P99 帧时间。若同帧重复消息很多,写入次数应明显下降;如果每个目标本来只变化一次,去重队列反而可能增加一点管理成本。
最终应保留可证明省时、且不破坏业务顺序的批处理;对真正无法合并的计算,再考虑缓存共享数据或有延迟预算的分帧调度。