
区块链原理 / 系统课时
按字节解析原始交易序列化字段
按字节解析原始交易序列化字段
给定一串 Bitcoin 原始交易十六进制数据,怎样还原输入、输出和锁定时间?这里用一笔 82 字节的教学样本逐段定位字段,处理 CompactSize 变长整数,再用 Python 检查所有字节是否恰好被解析完。
学习目标
- 读懂交易字段的排列顺序、小端整数与 CompactSize 编码。
- 从完整十六进制样本还原输入、输出和 locktime,并核对字节偏移。
- 识别 SegWit 交易比传统序列化多出的标记与见证区域。
交易字节流如何排列
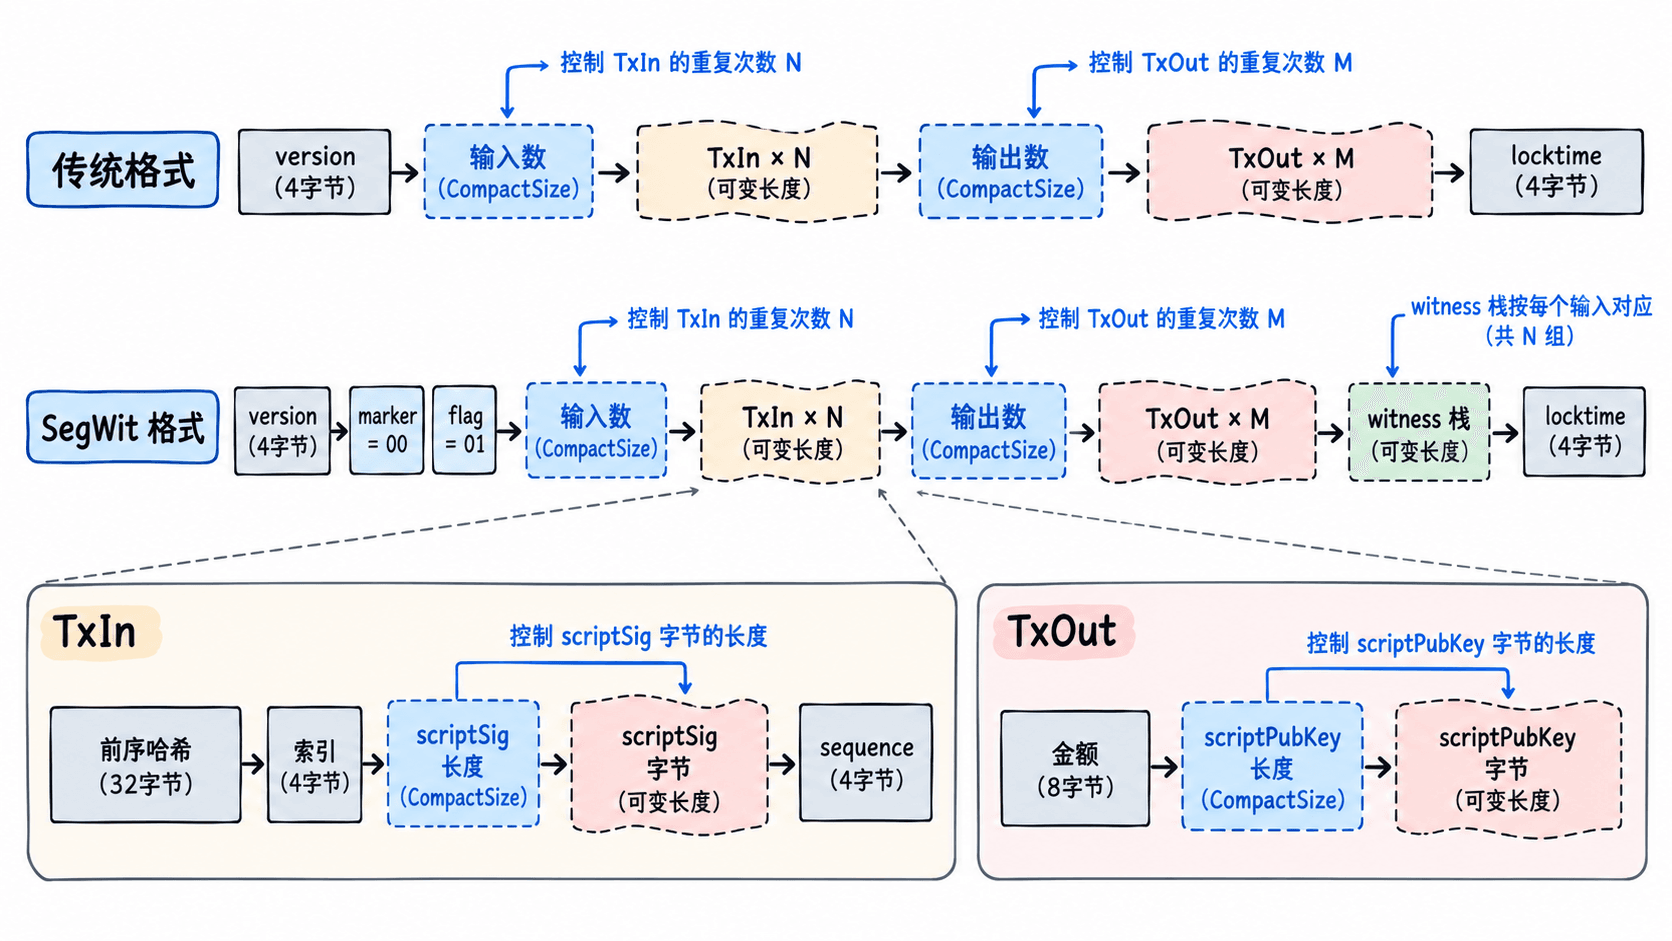
传统交易依次写入 4 字节 version、输入数量及输入列表、输出数量及输出列表,最后以 4 字节 locktime 结束。version 按有符号 32 位小端整数解析,locktime 是无符号 32 位小端整数;数量字段使用 CompactSize,而不是固定 4 字节。
每个非 coinbase 输入(TxIn)包含:前序交易哈希 32 字节、前序输出索引 4 字节、scriptSig 的 CompactSize 长度与内容、sequence 4 字节。每个输出(TxOut)包含:金额 8 字节(单位 sat)、scriptPubKey 的 CompactSize 长度与内容。交易哈希在字节流中的顺序与通常显示的 txid 十六进制字符串相反。
CompactSize 如何确定下一段的位置
解析器必须先读取一个前缀,再决定是否继续取后续字节;取得的值可能是输入数量、输出数量或脚本字节数。
| 数值范围 | 编码 | 总长度 |
|---|---|---|
| 0~252 | 数值本身 | 1 字节 |
| 253~65535 | fd + 2 字节小端整数 |
3 字节 |
| 65536~4294967295 | fe + 4 字节小端整数 |
5 字节 |
| 更大且不超过 2⁶⁴−1 | ff + 8 字节小端整数 |
9 字节 |
例如 fd0302 表示 515,而不是 770。若脚本长度字段是 16,它表示接下来的 22 个字节;对应十六进制字符串应占 44 个字符。fd、fe、ff 分支也必须使用最短合法编码,不能用 fd0100 表示 1。
用 Python 解析一笔完整的教学样本
下面构造传统序列化格式:版本 2、一个输入、一个输出、金额 1000 sat、输出脚本 0014 加 20 个 22 字节、locktime=0。前序哈希是人为填充值,输入未提供有效解锁数据,因此仅供解析,不能当作有效可广播交易。代码也支持识别常见 00 01 SegWit 结构。
# 教学样本只用于核对字节布局,不验证签名或 UTXO。
hex_tx = (
    "02000000" + "01" + "11" * 32 + "00000000"
    + "00" + "feffffff" + "01"
    + "e803000000000000" + "16" + "0014" + "22" * 20
    + "00000000"
)
raw = bytes.fromhex(hex_tx)
pos = 0

def take(n):
    global pos
    if pos + n > len(raw):
        raise ValueError("交易字节已截断")
    part = raw[pos:pos + n]
    pos += n
    return part

def number(n, signed=False):
    return int.from_bytes(take(n), "little", signed=signed)

def compact_size():
    tag = number(1)
    if tag < 253:
        return tag
    width = {253: 2, 254: 4, 255: 8}[tag]
    value = number(width)
    if value < {253: 253, 254: 65536, 255: 4294967296}[tag]:
        raise ValueError("非最短 CompactSize 编码")
    return value

version = number(4, signed=True)
segwit = raw[pos:pos + 1] == bytes([0])
if segwit and take(2) != bytes([0, 1]):
    raise ValueError("本示例只支持 00 01 见证标志")

vin_count = compact_size()
if vin_count == 0:
    raise ValueError("输入数量不能为 0")
inputs = []
for _ in range(vin_count):
    prev_txid = take(32)[::-1].hex()  # 常见 txid 显示顺序与原始哈希字节相反
    prev_vout = number(4)
    script_sig = take(compact_size())
    sequence = number(4)
    inputs.append((prev_txid, prev_vout, len(script_sig), sequence))

vout_count = compact_size()
outputs = []
for _ in range(vout_count):
    value_sat = number(8)
    script_pubkey = take(compact_size())
    outputs.append((value_sat, script_pubkey.hex()))

if segwit:
    for _ in range(vin_count):
        # 每个输入独立携带一个见证栈,每项有自己的变长字节数。
        for _ in range(compact_size()):
            take(compact_size())

locktime = number(4)
if pos != len(raw):
    raise ValueError("末尾存在未解析的额外字节")

print(f"version={version}, segwit={segwit}")
print(f"vin={vin_count}, vout={vout_count}")
print(f"input[0] prev_vout={inputs[0][1]}, scriptSig={inputs[0][2]}B, sequence=0x{inputs[0][3]:08x}")
print(f"output[0] value={outputs[0][0]} sat, scriptPubKey={len(outputs[0][1]) // 2}B")
print(f"locktime={locktime}, bytes={pos}/{len(raw)}")
预期输出:
version=2, segwit=False
vin=1, vout=1
input[0] prev_vout=0, scriptSig=0B, sequence=0xfffffffe
output[0] value=1000 sat, scriptPubKey=22B
locktime=0, bytes=82/82
用偏移定位常见解析错误
| 字节偏移(从 0 起) | 十六进制片段 | 解析结果 |
|---|---|---|
| 0~3 | 02000000 |
version=2 |
| 4 | 01 |
1 个输入 |
| 5~36 | 11 重复 32 次 |
前序交易哈希 |
| 37~45 | 00000000 00 feffffff |
索引 0、空 scriptSig、sequence=0xfffffffe |
| 46 | 01 |
1 个输出 |
| 47~54 | e803000000000000 |
1000 sat |
| 55~77 | 16 0014 + 20 个 22 |
22 字节 scriptPubKey |
| 78~81 | 00000000 |
locktime=0 |
这里 0014 是输出脚本中的见证程序前缀,不代表当前交易已经采用 SegWit 序列化。只有在 version 后遇到 00 01 标记,才按扩展格式解析:先读全部输入和输出,再按输入顺序读取各自见证栈,最后读取 locktime。SegWit 的 txid 不包含见证数据,而 wtxid 包含见证数据。
若 bytes 不是 82/82,先检查 CompactSize 是否把脚本长度当作十六进制字符数,再检查多字节整数的小端序。字节解析成功只证明结构能够读完,不代表前序 UTXO 存在、签名有效或交易符合共识规则。字段定义可对照 Bitcoin 开发者参考 与 BIP 141。