
游戏客户端架构 / 系统课时
怎样给资源补齐可机器读取的元数据
怎样给资源补齐可机器读取的元数据
只靠文件名很难让导入器判断一个资源应该用于哪个平台、采用哪一级 LOD、是否生成碰撞体或使用什么压缩策略。本节建立一份可机器读取的资源元数据约定,并用可运行校验脚本验证关键字段,让后续工具能够稳定做自动决策。
学习目标
- 设计一组能支撑自动导入与构建决策的元数据字段
- 用伴随文件保存平台、LOD、碰撞、材质、压缩和运行时用途
- 在资源进入流水线前校验字段类型、取值和组合关系
元数据应该解决什么问题
资源元数据不是给人写备注,而是给工具提供稳定、可解析、可校验的决策输入。如果导入器仍然要根据目录名猜用途,或者靠美术同学手工勾选参数,流水线就无法可靠自动化。
常见字段可以收敛为以下几类:
| 字段 | 示例 | 工具要回答的问题 |
|---|---|---|
platforms |
["pc","mobile"] |
这个资源进入哪些平台构建 |
lod |
0 |
当前文件属于哪一级 LOD |
collision |
"simple" |
是否需要碰撞以及碰撞复杂度 |
materialProfile |
"character-pbr" |
应套用哪类材质导入规则 |
compression |
"normal-map" |
纹理或音频采用哪种压缩策略 |
runtimeUsage |
"character" |
运行时由哪个系统或场景消费 |
元数据只保存工具需要判断的事实,不要把可从文件本身稳定推导的信息重复写进去。例如图片宽高可由解码器读取,就不必人工维护一份 width 和 height。
用伴随文件保存元数据
一种容易跨 DCC、版本控制和构建工具协作的方式,是给资源旁边放一个同名伴随文件。例如 hero_body.fbx 对应 hero_body.assetmeta.json。JSON 的优势是格式稳定、几乎所有语言都能解析,也方便在提交前做静态检查。
下面是一份完整示例:
{
  "schemaVersion": 1,
  "platforms": ["pc", "mobile"],
  "lod": 0,
  "collision": "simple",
  "materialProfile": "character-pbr",
  "compression": "none",
  "runtimeUsage": "character"
}
这份配置的生效行为是:导入器可以直接读取字段,而不再依赖人工选择。实际流水线中,应由导入脚本把这些值映射到具体引擎或平台参数。
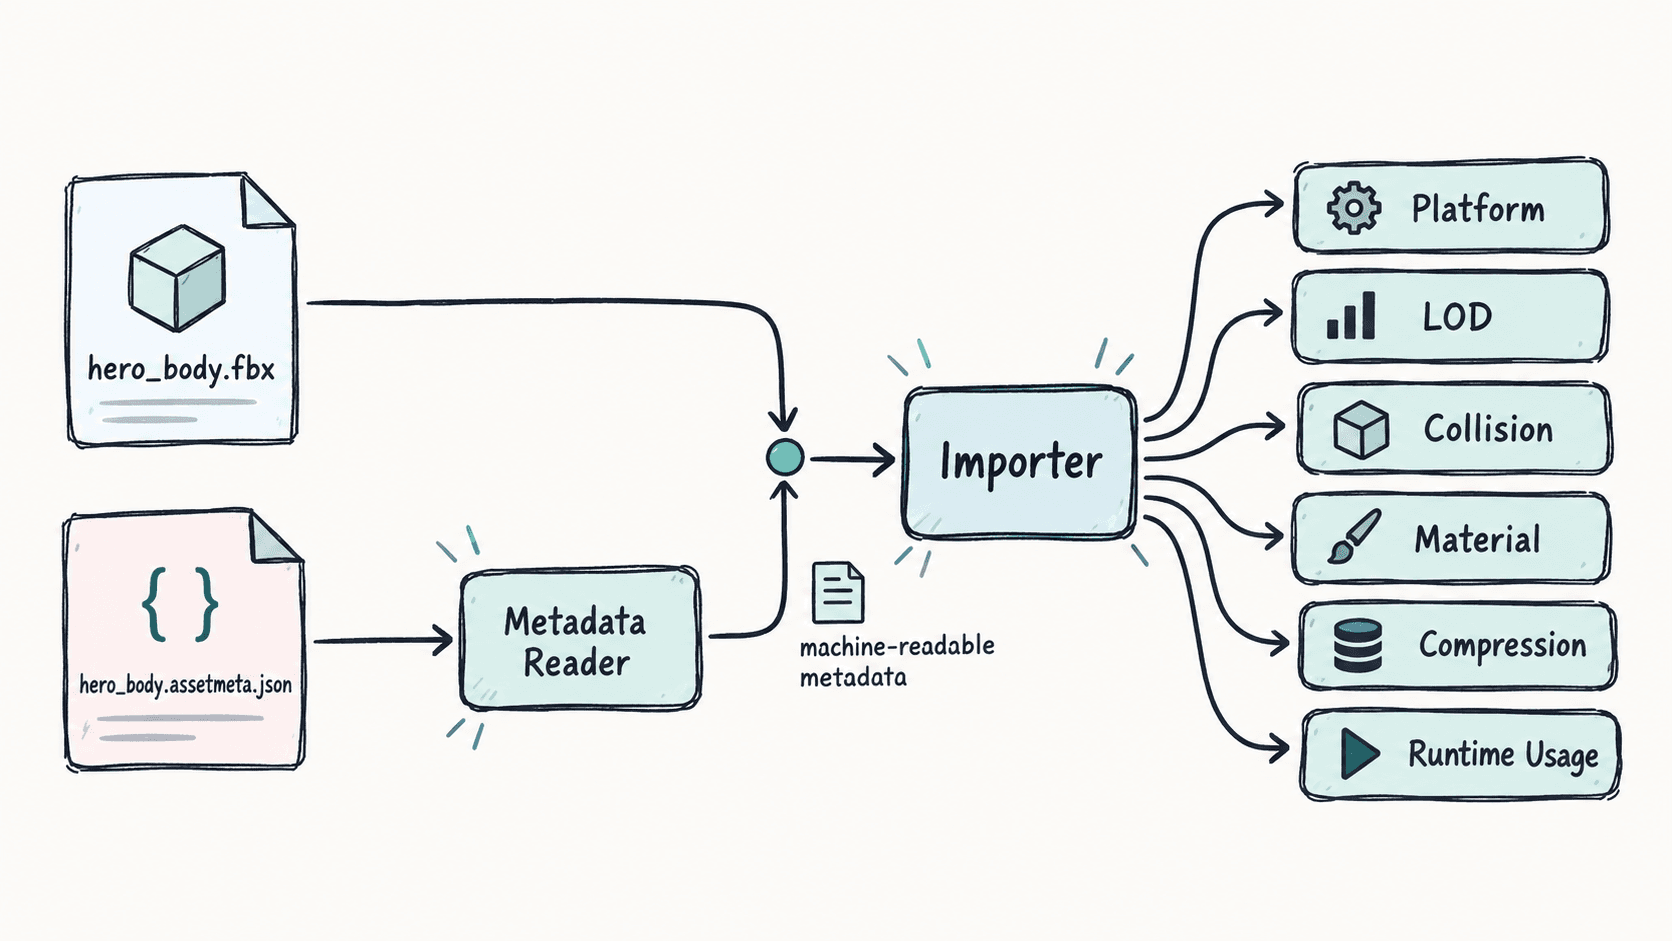
给字段建立可校验的边界
字段越自由,工具越难保证结果一致。平台、碰撞类型、压缩策略这类值应使用有限枚举;LOD 应明确数值范围;不同字段之间还要检查组合关系。
下面的脚本使用 Python 标准库读取伴随文件,并校验本节示例中的关键规则:
import json
import sys
from pathlib import Path

ALLOWED_PLATFORMS = {"pc", "mobile", "console"}
ALLOWED_COLLISION = {"none", "simple", "complex"}
ALLOWED_COMPRESSION = {"none", "color", "normal-map", "mask"}
ALLOWED_USAGE = {"character", "environment", "ui", "vfx"}

def validate_metadata(path: Path) -> list[str]:
    data = json.loads(path.read_text(encoding="utf-8"))
    errors = []

    if data.get("schemaVersion") != 1:
        errors.append("schemaVersion must be 1")

    platforms = data.get("platforms")
    if not isinstance(platforms, list) or not platforms:
        errors.append("platforms must be a non-empty array")
    elif any(item not in ALLOWED_PLATFORMS for item in platforms):
        errors.append("platforms contains unsupported value")

    lod = data.get("lod")
    if not isinstance(lod, int) or not 0 <= lod <= 4:
        errors.append("lod must be an integer from 0 to 4")

    if data.get("collision") not in ALLOWED_COLLISION:
        errors.append("collision is invalid")

    if data.get("compression") not in ALLOWED_COMPRESSION:
        errors.append("compression is invalid")

    if data.get("runtimeUsage") not in ALLOWED_USAGE:
        errors.append("runtimeUsage is invalid")

    if not isinstance(data.get("materialProfile"), str) or not data["materialProfile"]:
        errors.append("materialProfile must be a non-empty string")

    return errors

def main() -> int:
    if len(sys.argv) != 2:
        print("usage: python validate_assetmeta.py <metadata.json>")
        return 2

    path = Path(sys.argv[1])
    errors = validate_metadata(path)
    if errors:
        for error in errors:
            print(f"ERROR: {error}")
        return 1

    print("OK: metadata is valid")
    return 0

if __name__ == "__main__":
    raise SystemExit(main())
保存为 validate_assetmeta.py 后执行:
python validate_assetmeta.py hero_body.assetmeta.json预期输出:
OK: metadata is valid如果实际文件包含非法平台或超出范围的 LOD,脚本会返回非零退出码,便于后续接入提交钩子或 CI。
让元数据真正成为流水线契约
字段一旦被工具消费,就不应随意改名或改变语义。给元数据增加 schemaVersion,就是为了让读取方能够识别格式版本;需要演进时,新旧版本可以并行解析,而不是静默把旧资源解释错。
还要避免把引擎内部实现细节直接泄漏到通用元数据里。比如不要用某个引擎专属压缩枚举作为跨工具标准,而应先定义项目自己的稳定语义,再由 Unity、Unreal 或自研导入器分别映射。
当字段具备明确含义、有限取值、版本号和自动校验后,元数据才从“附加说明”变成真正可执行的流水线契约:资源作者负责声明事实,工具负责依据这些事实自动完成导入和构建决策。