
游戏客户端架构 / 系统课时
资源提交前怎样自动生成检查报告
资源提交前怎样自动生成检查报告
自动检查只有“报错”还不够:提交者必须知道哪个资源失败、严重程度多高、为什么失败,以及下一步该怎么修。本节把校验器的原始结果整理成稳定的报告格式,并用阻断级别决定提交是否应当继续。
学习目标
- 设计适合机器处理和人工阅读的校验结果结构
- 按错误级别、资源路径和检查项组织报告
- 让报告生成结果可以直接作为 CI 或提交钩子的放行依据
先统一校验器输出
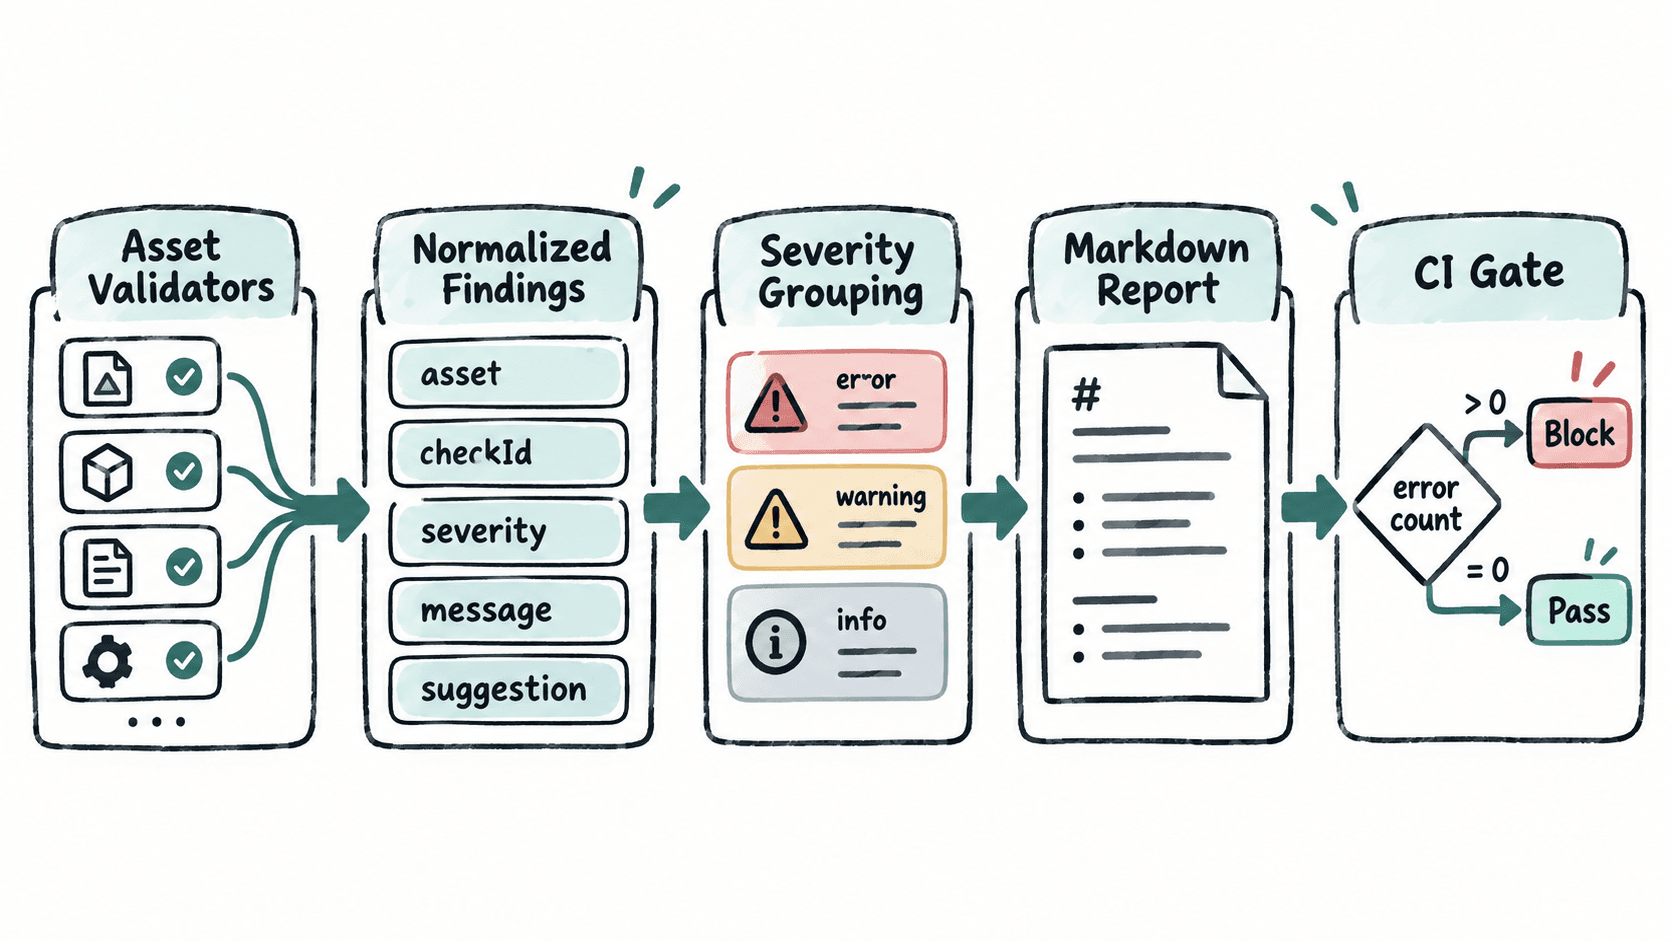
检查报告不应该直接解析每个校验器的自然语言日志。更可靠的方式是要求所有校验器先输出统一结构,至少包含 asset、checkId、severity、message 和 suggestion。
建议只保留少量稳定级别:error 表示必须阻断,warning 表示可以提交但需要关注,info 只提供提示。真正决定是否阻断的规则集中在报告生成器里,避免各校验器自行决定退出策略。
[
  {
    "asset": "assets/ui/logo.png",
    "checkId": "texture.max-size",
    "severity": "error",
    "message": "Texture width 4096 exceeds limit 2048.",
    "suggestion": "Resize the source image or lower the import max size."
  },
  {
    "asset": "assets/audio/click.wav",
    "checkId": "audio.duration",
    "severity": "warning",
    "message": "UI sound duration is 2.4s.",
    "suggestion": "Review whether the clip should be shortened."
  }
]
从校验结果到最终提交决策,中间最好保留一个独立的报告聚合层。这样校验规则可以继续增加,而报告格式和 CI 接口仍然稳定。
生成一份可读又可判定的报告
下面的脚本读取 validation.json,按严重程度排序,把结果写成 Markdown,同时用进程退出码表达是否存在阻断错误。将程序保存为 build_report.py,与 validation.json 放在同一目录后执行 python build_report.py;报告适合人工阅读,退出码适合自动化系统判断。
from __future__ import annotations

import json
from pathlib import Path

SEVERITY_ORDER = {"error": 0, "warning": 1, "info": 2}

def load_findings(path: Path) -> list[dict]:
    data = json.loads(path.read_text(encoding="utf-8"))
    required = {"asset", "checkId", "severity", "message", "suggestion"}

    for index, item in enumerate(data):
        missing = required - item.keys()
        if missing:
            raise ValueError(f"finding {index} missing fields: {sorted(missing)}")
        if item["severity"] not in SEVERITY_ORDER:
            raise ValueError(f"finding {index} has invalid severity")
    return data

def render_report(findings: list[dict]) -> str:
    findings = sorted(
        findings,
        key=lambda item: (SEVERITY_ORDER[item["severity"]], item["asset"], item["checkId"])
    )

    counts = {
        level: sum(1 for item in findings if item["severity"] == level)
        for level in SEVERITY_ORDER
    }

    lines = [
        "# Asset Validation Report",
        "",
        f"Errors: {counts['error']}, Warnings: {counts['warning']}, Info: {counts['info']}",
        ""
    ]

    for item in findings:
        lines.extend([
            f"## {item['severity'].upper()} · {item['asset']}",
            "",
            f"- Check: `{item['checkId']}`",
            f"- Problem: {item['message']}",
            f"- Suggestion: {item['suggestion']}",
            ""
        ])

    return chr(10).join(lines).rstrip() + chr(10)

def main() -> int:
    input_path = Path("validation.json")
    output_path = Path("report.md")

    findings = load_findings(input_path)
    output_path.write_text(render_report(findings), encoding="utf-8")

    errors = sum(1 for item in findings if item["severity"] == "error")
    print(f"report generated: {output_path}")
    print(f"blocking errors: {errors}")
    return 1 if errors else 0

if __name__ == "__main__":
    raise SystemExit(main())
预期输出:
report generated: report.md
blocking errors: 1
此时进程退出码为 1,因此 CI 可以阻断提交。report.md 中会先显示 error,再显示 warning,并保留资源路径、检查编号和修复建议,提交者不需要回到长日志里搜索关键行。
让报告真正帮助修复而不是堆错误
一份有效报告应优先回答“先修什么”和“去哪里修”。同一资源的多个问题可以连续展示,但不要把数十条细节压成一行;检查编号则要保持稳定,方便搜索历史记录和统计高频问题。
如果检查器能提供更精确的位置,例如材质文件中的具体字段、模型中的某个子网格或音频的某个导入属性,可以扩展统一结果结构,但不要让报告生成器重新理解各类资源格式。报告层只负责排序、分组、展示和阻断判定。
提交门禁只认稳定规则
CI 最终只需要一个明确结果:是否存在阻断级错误。警告数量可以展示,但不应因为某个校验器临时改变文案就影响门禁逻辑。
当校验结果结构稳定、严重级别可控、资源位置明确、修复建议可执行时,自动检查才真正缩短了“发现问题到修复问题”的路径,而不是把人工审核换成另一种难读的日志。