
游戏客户端架构 / 系统课时
为什么资源流水线总在反复返工
为什么资源流水线总在反复返工
资源返工往往不是美术“做错了一次”,而是错误直到导入、构建甚至真机运行时才被发现。要降低返工成本,关键是识别命名、格式、坐标、材质和平台差异这些高频断点,并把能够自动判断的问题尽量提前到流水线入口。
学习目标
- 识别资源流水线中最常见的返工来源
- 理解为什么越晚发现规则违规,修复成本越高
- 能把人工约定拆成可检查、可阻断的流水线规则
返工的根因通常是错误发现得太晚
假设角色模型的坐标轴不符合项目规范。如果导出时立即检测,修改一次即可;如果直到动画绑定完成后才发现,就可能需要重新导出和绑定;如果问题进入构建并交给关卡使用,修复还会波及预制对象、碰撞和已有场景。
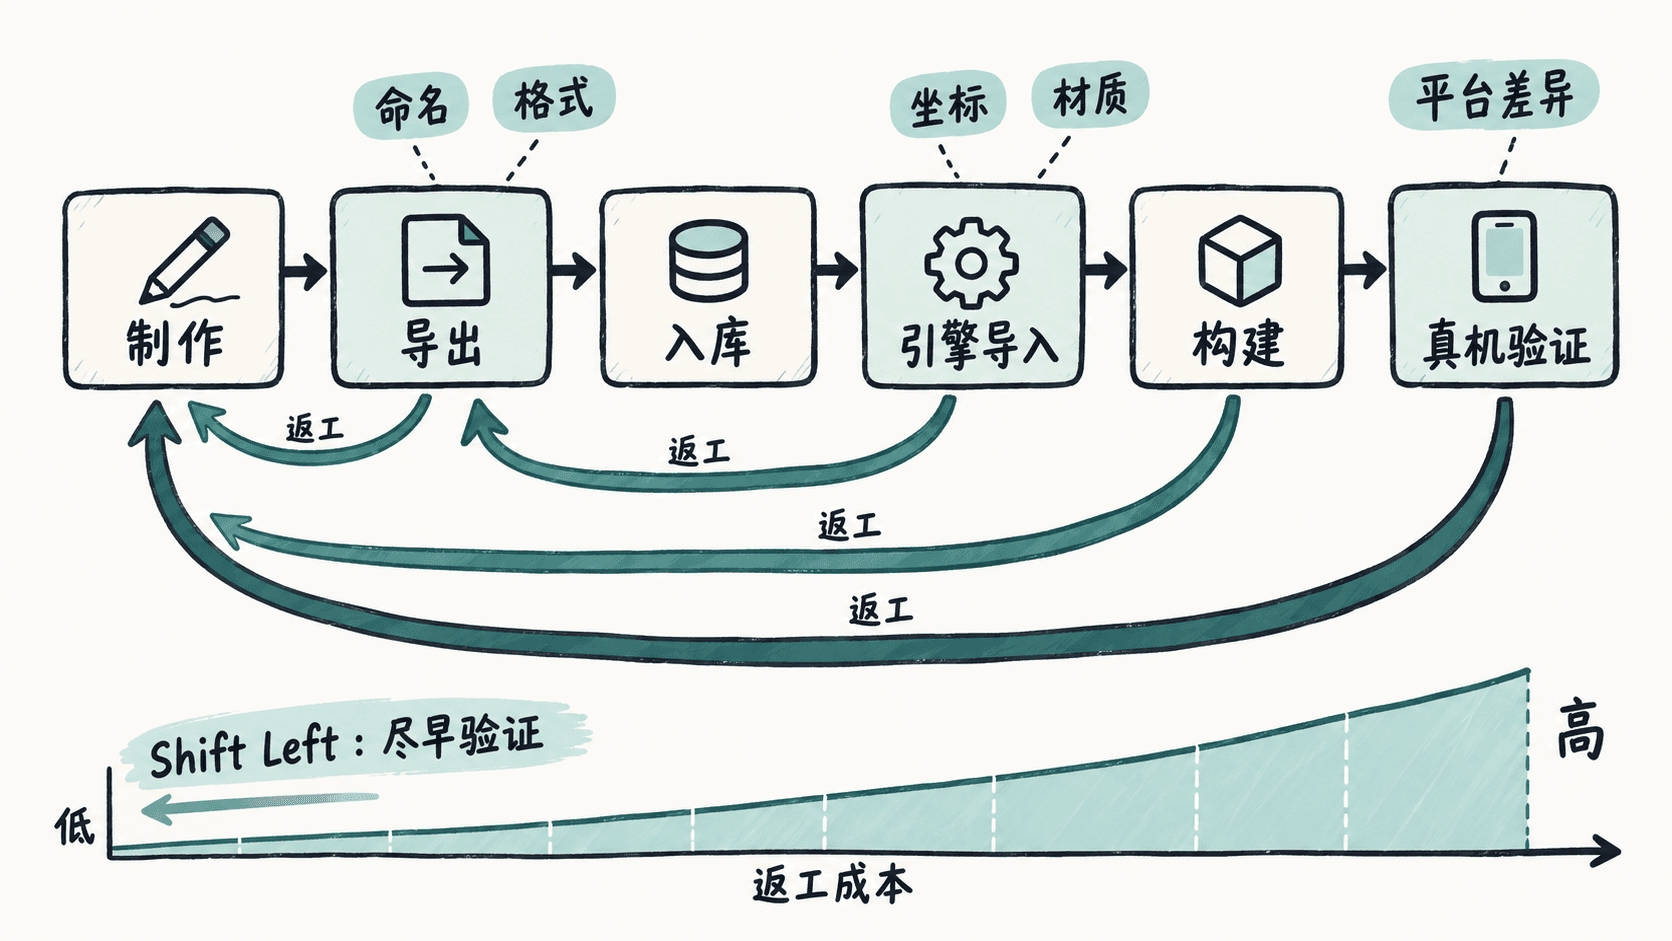
因此流水线优化的核心目标之一是 Shift Left:能够在资源刚提交或刚导出时确认的问题,不要留到构建服务器,更不要留到真机验收阶段。
五类规则最容易产生连锁返工
| 返工点 | 常见现象 | 更适合检查的位置 |
|---|---|---|
| 命名 | 大小写混杂、重名、路径不稳定 | 导出或提交前 |
| 格式 | 使用不支持的扩展名、位深或压缩格式 | 导入前 |
| 坐标 | 轴向、单位、原点或缩放不一致 | DCC 导出时 |
| 材质 | 丢失贴图引用、使用不受支持的着色配置 | 引擎导入后 |
| 平台 | 桌面正常但移动端超规格或格式不兼容 | 平台构建前 |
这些问题的共同特点是:规则本身通常早就存在,但执行规则依赖人的记忆。当团队成员、外包来源或资源数量增加后,口头约定很快就会失效。
例如“文件名全部小写”看起来非常简单,但如果没有自动检查,大量资源积累之后再统一修改名称,会同时影响引用路径、版本历史以及依赖这些资源的其他对象。
把口头规范变成机器能够拒绝的条件
不是所有规范都需要一开始就做复杂工具。最小可行方案可以先从名称和文件格式入手,在资源进入主仓库前执行确定性的检查。
下面的 Python 示例模拟一个最简单的资源门禁:名称必须使用小写且不能包含空格,文件扩展名只允许项目规定的三种类型。示例可以直接运行,用来理解“发现违规就立即阻断”的基本方式。
from pathlib import PurePosixPath

ALLOWED_EXTENSIONS = {'.fbx', '.png', '.wav'}
assets = [
    'character/hero_body.fbx',
    'character/Hero Body.fbx',
    'ui/icon.png',
    'music/theme.mp3',
]

def validate(asset: str) -> list[str]:
    path = PurePosixPath(asset)
    problems = []

    if path.name != path.name.lower() or ' ' in path.name:
        problems.append('invalid name')
    if path.suffix.lower() not in ALLOWED_EXTENSIONS:
        problems.append('unsupported extension')

    return problems

for asset in assets:
    for problem in validate(asset):
        print(f'{asset}: {problem}')
预期输出:
character/Hero Body.fbx: invalid name
music/theme.mp3: unsupported extension
真实项目不应机械照搬这三种扩展名,而应把允许格式和命名规则定义为项目自己的规范。坐标、纹理尺寸、材质依赖等规则也可以逐步加入,但前提是检查结果必须稳定、可解释,不能让同一资源在不同机器得到互相矛盾的结论。
规则应该放在哪一层
规则越靠近问题产生的位置,修复通常越便宜。DCC 可以检查单位、轴向和导出集合;提交前检查适合处理名称、目录和文件格式;引擎导入阶段适合检查材质引用、纹理规格和资源类型;构建阶段则更适合检查平台预算与最终产物。
并不是所有问题都应该在构建时一次性扫描。把所有验证集中在最后一道关卡,虽然能够阻止错误上线,却无法阻止团队在前面几小时甚至几天里继续基于错误资源工作。
判断一条人工约定是否值得自动化
可以用三个条件判断:它是否会频繁重复检查,判断结果是否足够客观,以及违规后是否会产生明显返工。如果三项都满足,就很适合作为流水线规则。
例如“模型名称必须符合约定”容易自动化,而“角色造型是否好看”属于主观判断,不应该硬塞进自动门禁。材质数量、纹理最大尺寸、文件扩展名这类具有明确边界的数据,则更适合机器检查。
稳定的 Asset Pipeline 并不是完全消除修改,而是让错误尽量在离产生位置最近的地方被发现。把高频、客观、代价明确的规则前移之后,团队仍然可以迭代资源,但不必因为同一种基础错误反复走完整条生产链。