
游戏客户端架构 / 系统课时
怎样追踪一次构建用了哪些资源
怎样追踪一次构建用了哪些资源
当线上包出现贴图错版、模型缺失或资源回退异常时,只知道构建号通常不够。要把问题追到具体资源版本,必须同时记录源文件、依赖关系、导入规则和构建环境,并让这些信息与最终发布物一一绑定。
学习目标
- 设计能回答“这个包到底用了什么”的构建清单
- 记录资源哈希、依赖快照和处理规则版本
- 从线上构建号反查到具体资源与流水线配置
为什么只记构建号不够
构建号只能标识“哪一次构建”,却不能解释“这次构建为什么得到这个结果”。同一个 Git 提交在导入器版本、压缩参数、平台目标或外部资源缓存不同的情况下,仍可能产出不同内容。
真正可追溯的最小链路应至少包含:源码修订号、资源内容哈希、资源依赖、导入规则版本、引擎或工具链版本、目标平台,以及最终产物标识。资源路径只能帮助定位,不能代替内容哈希,因为文件内容变化后路径可能完全不变。
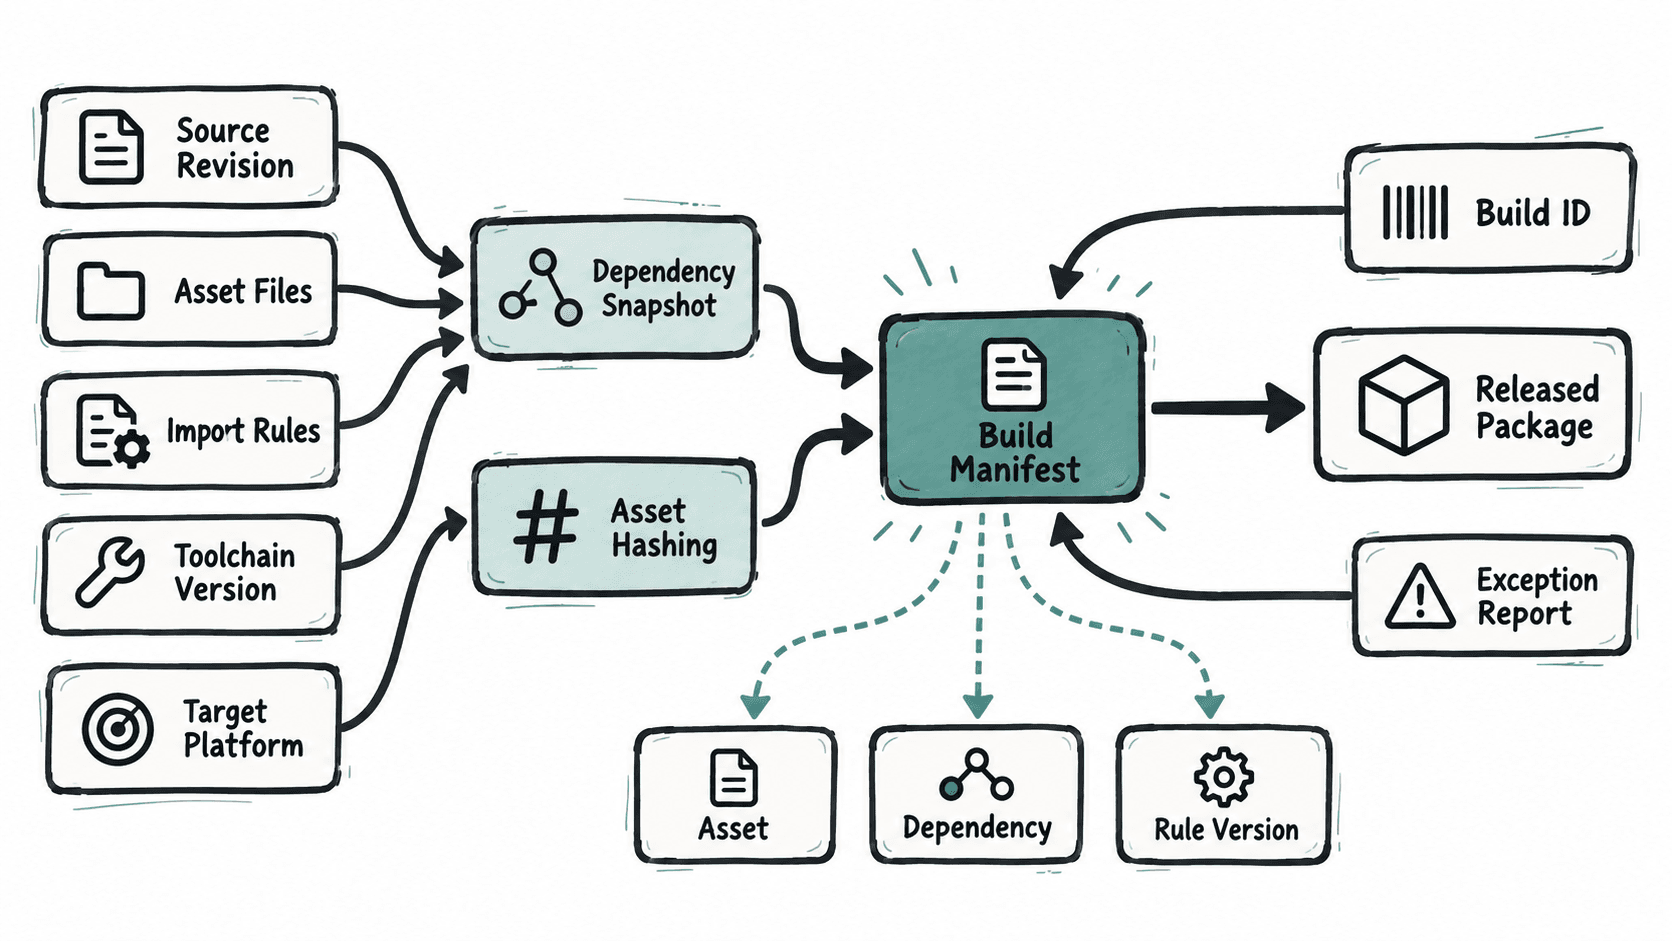
构建清单应该记录什么
建议把清单视为发布物的一部分,而不是临时日志。每个资源至少记录相对路径、内容哈希和直接依赖;构建级别再记录源码版本、工具链版本、规则版本和平台。
依赖关系不要靠文件夹猜测。材质依赖哪些贴图、Prefab 依赖哪些模型、场景依赖哪些子资源,应从实际使用的引擎或构建工具导出依赖快照。不同引擎的依赖 API 不同,因此通用脚本只负责存储,不应伪造统一接口。
一个精简清单可以长这样:
{
  "buildId": "<BUILD_ID>",
  "sourceRevision": "<REVISION>",
  "engineVersion": "<ENGINE_VERSION>",
  "ruleVersion": "<RULE_VERSION>",
  "platform": "<PLATFORM>",
  "assets": [
    {
      "path": "Characters/Hero.fbx",
      "sha256": "<SHA256>",
      "dependencies": [
        "Characters/Hero_Albedo.png",
        "Characters/Hero_Normal.png"
      ]
    }
  ]
}
这里的 dependencies 应来自引擎实际导出的依赖结果;sha256 对应源资源内容。若流水线还会生成中间产物,可以额外记录中间产物哈希,但不要用它替代源资源哈希。
生成可复核的资源清单
下面的脚本使用 Python 标准库计算资源 SHA-256,并把一个已经由引擎导出的依赖文件合并到构建清单中。它不负责猜依赖,因此适合接在各类引擎的依赖导出步骤之后。
from __future__ import annotations

import argparse
import hashlib
import json
from pathlib import Path

def sha256_file(path: Path) -> str:
    digest = hashlib.sha256()
    with path.open("rb") as file:
        for chunk in iter(lambda: file.read(1024 * 1024), b""):
            digest.update(chunk)
    return digest.hexdigest()

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("asset_root")
    parser.add_argument("dependencies_json")
    parser.add_argument("output")
    parser.add_argument("--build-id", required=True)
    parser.add_argument("--source-revision", required=True)
    parser.add_argument("--engine-version", required=True)
    parser.add_argument("--rule-version", required=True)
    parser.add_argument("--platform", required=True)
    args = parser.parse_args()

    root = Path(args.asset_root).resolve()
    dependencies = json.loads(Path(args.dependencies_json).read_text(encoding="utf-8"))

    assets = []
    for path in sorted(p for p in root.rglob("*") if p.is_file()):
        relative = path.relative_to(root).as_posix()
        assets.append(
            {
                "path": relative,
                "sha256": sha256_file(path),
                "dependencies": dependencies.get(relative, []),
            }
        )

    manifest = {
        "buildId": args.build_id,
        "sourceRevision": args.source_revision,
        "engineVersion": args.engine_version,
        "ruleVersion": args.rule_version,
        "platform": args.platform,
        "assets": assets,
    }

    Path(args.output).write_text(
        json.dumps(manifest, ensure_ascii=False, indent=2),
        encoding="utf-8",
    )
    print(f"manifest written: {args.output}, files={len(assets)}")

if __name__ == "__main__":
    main()
假设 dependencies.json 已由引擎流水线生成,可以这样执行:
python build_manifest.py Assets dependencies.json manifest.json --build-id "<BUILD_ID>" --source-revision "<REVISION>" --engine-version "<ENGINE_VERSION>" --rule-version "<RULE_VERSION>" --platform "<PLATFORM>"预期输出:
manifest written: manifest.json, files=<N>其中 <N> 是实际扫描到的资源文件数量。生成后应把 manifest.json 与安装包、补丁包或制品仓库中的同一构建记录绑定保存。
从线上异常反查到资源
排查时先用线上版本号或构建 ID 找到对应清单,再按异常对象定位资源路径和哈希。若线上包中的资源哈希与清单不一致,优先检查打包、缓存或发布步骤;若哈希一致但表现错误,再检查依赖快照、导入规则版本和工具链版本。
例如模型材质突然变旧,不要先假设“美术提交错了”。清单若显示模型本体哈希未变,但某张依赖贴图哈希变化,就应直接检查那张贴图及其导入规则。这样可以把排查范围从整个资源库缩到一个具体依赖节点。
让清单真正可复现
清单必须在构建过程中自动生成,并在构建完成后保持只读。手工补录容易遗漏,也无法证明记录与产物来自同一次执行。最好在发布前增加一致性校验:关键字段为空、依赖文件缺失或资源哈希计算失败时,直接阻止发布。
同时避免把绝对路径、开发机用户名或临时目录写进清单,否则不同机器生成的记录会产生无意义差异。只保存稳定的相对路径和明确版本号,才能让同一输入在不同构建节点上得到可比较的结果。
一份可信的构建清单,本质上是在发布物旁边保存它的“资源证据链”。只要构建号能唯一找到这份证据链,线上资源问题就能从猜测变成可验证的追溯过程。