
游戏客户端架构 / 系统课时
为什么代码版本一样构建结果却不同
为什么代码版本一样构建结果却不同
当两台机器检出同一个提交却得到不同包体、不同资源内容甚至不同运行效果时,问题通常不在代码本身,而在代码之外的构建输入。要让构建可复现,必须把工具版本、导入规则、平台设置、资源状态和缓存都纳入同一份可追踪基线。
学习目标
- 识别“同一提交、不同构建”最常见的非代码输入
- 建立可记录、可比对的构建环境清单
- 按固定顺序定位缓存、版本、配置和未提交资源问题
构建输入远不止代码提交
一次游戏构建至少会经过“源资源 → 导入器 → 中间产物 → 平台处理 → 最终包”这条链路。只要链路中的任一输入没有被版本化,两台机器即使代码提交完全一致,也可能生成不同结果。
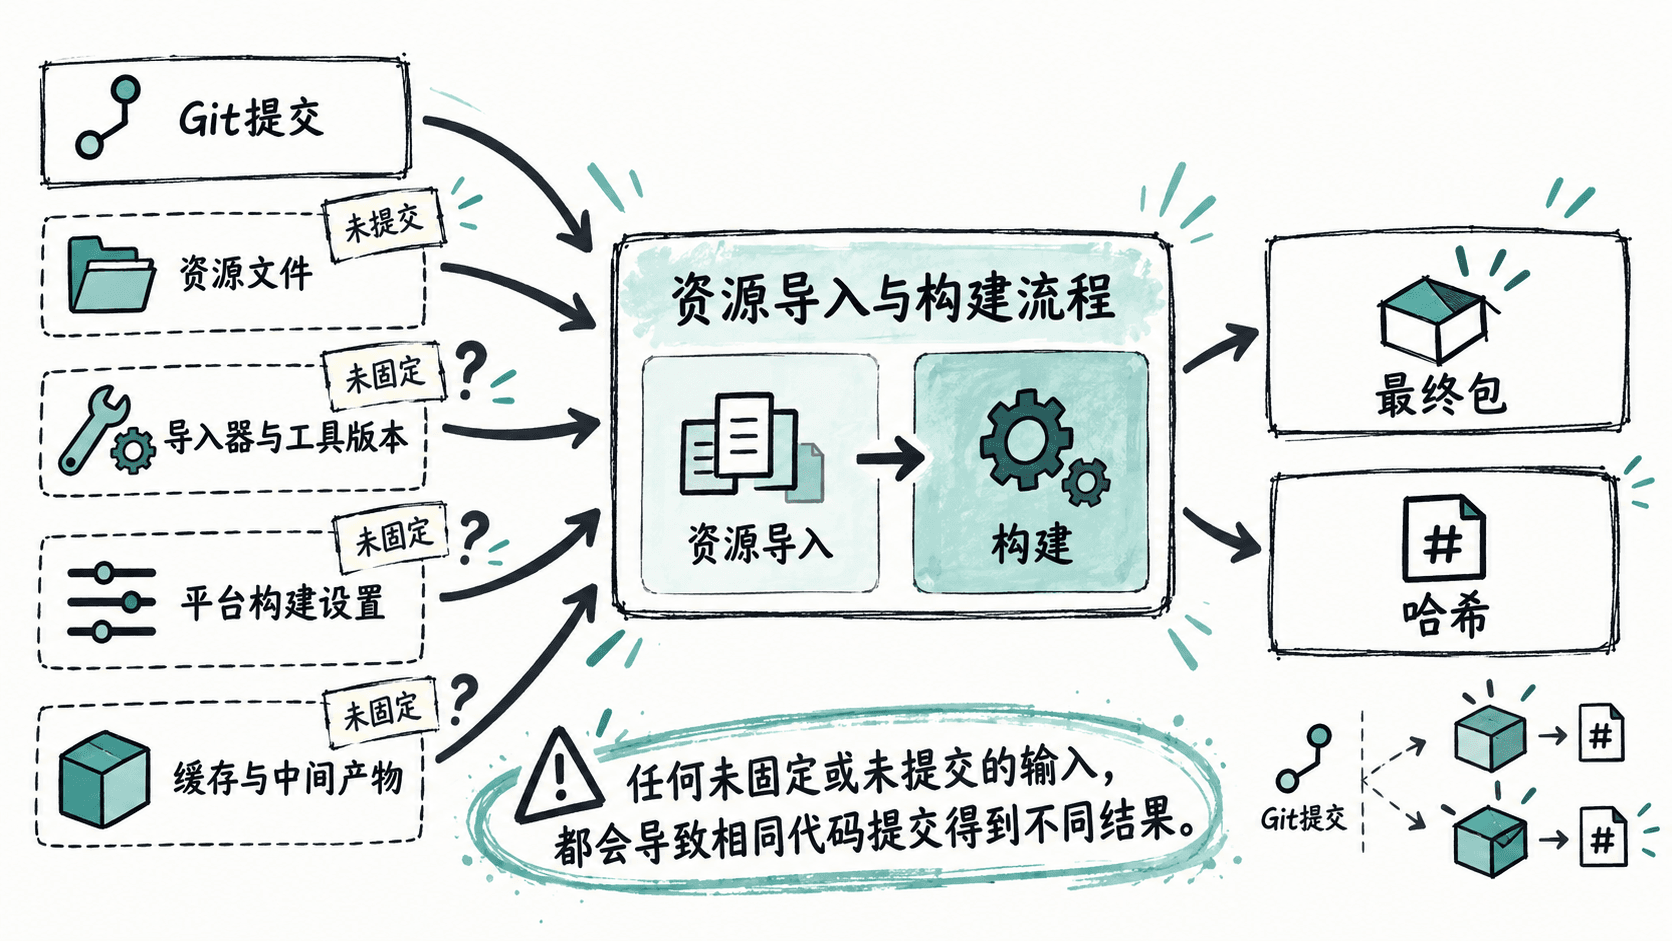
最常见的来源可以归为四类。第一类是导入缓存差异:旧缓存由不同版本的导入器生成,或者缓存部分损坏。第二类是工具版本差异:引擎、DCC 工具、压缩器、SDK 或插件版本不同。第三类是平台设置差异:纹理压缩、目标架构、脚本后端、质量等级等只存在本机而没有进入版本控制。第四类是工作区不干净:有人修改了资源、元数据或配置,但没有提交。
先把构建环境变成可比较的数据
排查时不要先猜“是不是缓存坏了”,而应先记录构建发生时的关键输入。下面的 Python 脚本可以在任何安装了 Python 和 Git 的仓库中运行,它会记录当前提交、工作区是否干净、Python 版本和平台信息,作为最小构建清单的示例。
import json
import platform
import subprocess
import sys

def run_git(*args: str) -> str:
    result = subprocess.run(
        ["git", *args],
        check=True,
        capture_output=True,
        text=True,
    )
    return result.stdout.strip()

manifest = {
    "commit": run_git("rev-parse", "HEAD"),
    "workingTreeDirty": bool(run_git("status", "--porcelain")),
    "python": sys.version.split()[0],
    "platform": platform.platform(),
}

print(json.dumps(manifest, ensure_ascii=False, indent=2))
预期输出结构如下。提交哈希、Python 版本和平台字符串属于动态值,实际内容会不同。
{
  "commit": "<COMMIT>",
  "workingTreeDirty": false,
  "python": "<PYTHON_VERSION>",
  "platform": "<PLATFORM>"
}
在真实项目里,应把脚本扩展为项目自己的构建清单,例如记录引擎版本、关键插件版本、目标平台、构建配置名和资源清单哈希。重点不是“记录得多”,而是让每个可能改变构建结果的输入都能被比对。
缓存问题要用对照实验确认
导入缓存本来是为了加速,不应该成为“构建逻辑的一部分”。如果怀疑缓存导致差异,最有效的方法不是直接把所有缓存删掉,而是做对照:保留当前工作区和工具版本不变,只改变缓存状态,再比较构建结果。
如果“复用缓存”与“全量重新导入”产生不同内容,说明缓存或导入器存在不一致;如果结果完全相同,就应继续检查工具版本和平台设置。这样一次只改变一个变量,能够避免“清缓存、升级工具、改设置一起做”之后仍然不知道真正根因。
工作区和未提交资源最容易被忽略
构建前先确认仓库干净,是成本最低的检查。代码相同并不代表资源相同:本地可能多出未跟踪文件,也可能有已经修改但未提交的元数据。对于会参与构建的目录,未提交状态应直接让正式构建失败,而不是继续生成一个无法追溯的包。
git status --short
git rev-parse HEAD
预期结果中,第一条命令在干净工作区不输出内容;第二条命令输出当前提交哈希。
<COMMIT>如果第一条命令出现路径,就先判断这些文件是否会参与构建。不要用“反正只有我本机有”作为理由忽略,因为这恰恰意味着别人无法重建你的结果。
用哈希验证结果,而不是凭感觉比较
完成构建后,应对最终包或关键产物计算哈希,并把哈希与构建清单一起保存。若两次构建的输入清单一致而产物哈希不同,再继续追查时间戳、随机数、文件遍历顺序、压缩器非确定性等更深层因素。
定位顺序可以固定为:先确认提交与工作区;再确认引擎、插件和 SDK 版本;然后比对平台设置;最后用干净缓存重建并比较产物哈希。这样能把“同一代码为什么不一样”从经验猜测,变成一组可重复验证的对照实验。