
游戏客户端架构 / 系统课时
怎样批量导出而不覆盖错误文件
怎样批量导出而不覆盖错误文件
批量导出真正危险的不是速度慢,而是几十个资产在无人确认时写进了错误目录,或者两个不同源资产计算出了同一个目标文件名。本节建立一套安全导出流程:先计算目标路径并预检冲突,再执行写入,最后核对实际结果,让“覆盖文件”从默认行为变成显式决定。
学习目标
- 为批量导出设计稳定且可追踪的目录和文件名规则
- 在真正写文件前发现重名、越界路径和已有文件冲突
- 使用预览、拒绝覆盖和导出后确认降低批处理风险
先固定输出身份
批量任务首先要回答两个问题:一个源资产最终写到哪里,以及它为什么会得到这个文件名。目标路径必须由稳定字段计算,而不是依赖操作者当前打开的目录或上一次导出位置。
例如,项目可以规定角色网格都输出到 game-assets/characters/<asset-id>/model.fbx。其中 <asset-id> 来自资产登记信息,而不是临时使用场景中的显示名称。这样即使美术把对象从 Hero_Final 改名为 Hero_Final_02,正式输出身份也不会意外变化。
文件名规则还需要保证大小写、空格和特殊字符的处理方式一致。特别是在 Windows 与 Linux 混合环境里,两个只在大小写上不同的文件名可能导致本机正常、CI 或版本库异常,因此碰撞检测最好统一按项目规定的规范化结果比较。
导出前先做预检
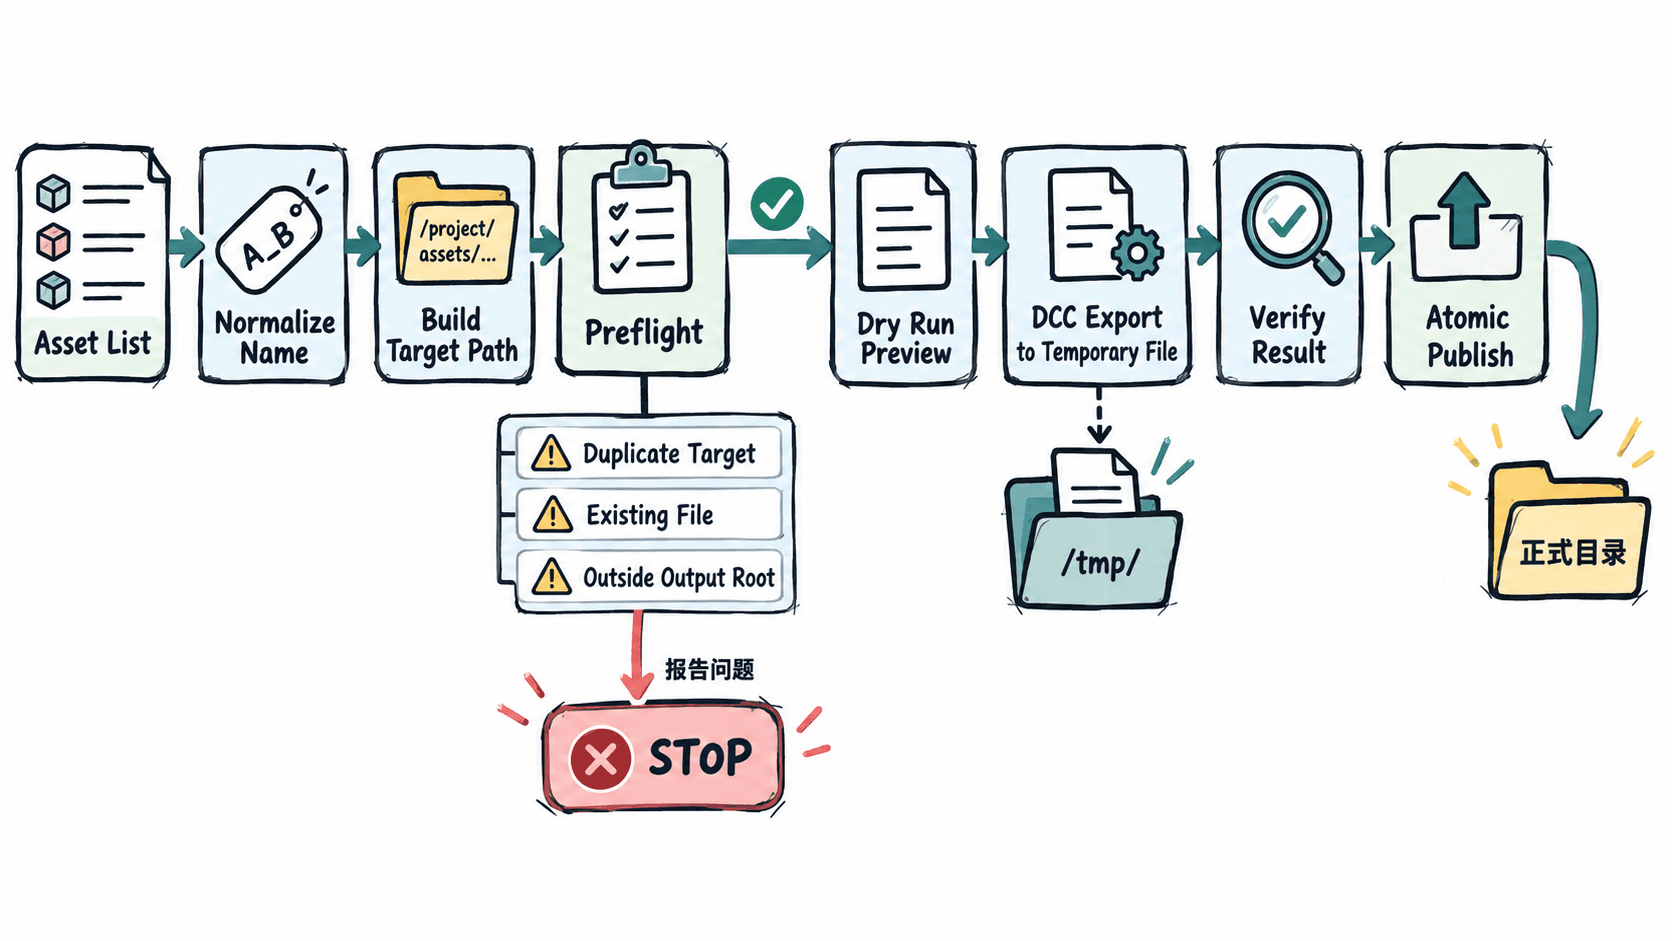
批量导出的第一阶段不应该写任何文件,而是先生成完整计划:源资产、目标路径、目标是否已存在、是否与同批其他任务冲突。只有计划通过后才进入真正的 DCC 导出。
下面的 Python 示例演示一个可独立运行的预检器。它不会调用 Blender、Maya 等具体 DCC API,而是负责批处理外层最容易出错的路径规划和碰撞检查。
from pathlib import Path

OUTPUT_ROOT = Path("game-assets")

tasks = [
    {"asset_id": "hero", "category": "characters"},
    {"asset_id": "goblin", "category": "characters"},
]


def build_target(task: dict[str, str]) -> Path:
    asset_id = task["asset_id"].strip().lower()
    category = task["category"].strip().lower()
    if not asset_id.replace("-", "").isalnum():
        raise ValueError(f"invalid asset_id: {asset_id}")
    return OUTPUT_ROOT / category / asset_id / "model.fbx"


def preflight(items: list[dict[str, str]]) -> list[Path]:
    targets: list[Path] = []
    normalized: set[str] = set()

    for item in items:
        target = build_target(item)
        key = target.as_posix().lower()
        if key in normalized:
            raise RuntimeError(f"duplicate target: {target.as_posix()}")
        normalized.add(key)
        targets.append(target)

    return targets


for path in preflight(tasks):
    print(f"PLAN {path.as_posix()}")
预期输出:
PLAN game-assets/characters/hero/model.fbx
PLAN game-assets/characters/goblin/model.fbx
真实流水线还应在预检阶段查询目标文件是否已经存在,并把结果显示在导出计划中。只有预检通过后,才把这些路径交给具体 DCC 的导出适配器。
把覆盖变成显式策略
最安全的默认策略是“目标已存在就失败”,而不是“存在就覆盖”。需要覆盖时,应由调用方显式传入覆盖意图,并在日志中留下源资产、目标文件和覆盖原因。这样批量任务不会因为一个默认勾选项静默替换大量正式资源。
比直接写正式文件更稳的做法,是先导出到同一目标目录下的临时文件,例如 model.fbx.tmp。确认导出调用成功、文件存在且基础校验通过后,再把临时文件发布为正式文件。这样可以避免 DCC 导出中途失败时留下一个名称正确但内容不完整的文件。
导出后确认实际结果
“导出命令没有报错”不等于产物正确。每个任务完成后至少确认目标文件真实存在、文件大小不是异常的 0 字节,并记录本次实际写入的路径。对关键资源还可以继续执行引擎侧导入验证,但那属于下一层校验。
批量任务结束时,应把成功、跳过和失败分别统计,而不是只打印一句 Export complete。如果 50 个任务中有 2 个因为目标已存在而被拒绝,操作者需要直接看到是哪两个,而不是到引擎里才发现资源没有更新。
真正可靠的批量导出顺序是:先计算、再检查、再预览、再写入、最后验证。只要目标路径和覆盖行为都必须经过这一条链路,批量导出就不会因为任务数量增加而把一次小失误放大成大面积错误覆盖。