
游戏客户端架构 / 系统课时
引擎导入到底保存了哪些状态
引擎导入到底保存了哪些状态
同一个 FBX、PNG 或 WAV 放进不同项目后,结果并不一定相同,因为引擎真正使用的不是“源文件本身”,而是源文件、导入设置、元数据和派生产物共同决定的结果。本节把这些状态拆开,并给出可复现导入的检查方法。
学习目标
- 区分源文件、导入设置、元数据与派生产物各自保存什么
- 理解一次导入从输入到可运行资源的状态链路
- 能定位“文件相同但导入结果不同”究竟差在哪一层
四类状态不是一回事
源文件是 DCC 工具或外部流程产出的原始输入,例如 character.fbx、albedo.png。它保存模型顶点、图片像素或音频采样等内容,但通常不包含“这个项目要不要生成 Mipmap”“动画按 Humanoid 还是 Generic 导入”这类引擎策略。
导入设置告诉引擎如何解释源文件,例如纹理类型、压缩方式、模型缩放、动画裁剪规则。它们可能保存在资源旁边的元数据文件、项目数据库或引擎专用描述中,具体位置取决于引擎。
元数据用来稳定识别资源及记录导入相关信息,例如资源 GUID、依赖关系、导入器版本或缓存键。元数据一旦丢失,路径没变也可能被当成“另一份资源”。
派生产物是导入器根据前面几类输入生成的引擎可消费数据,例如压缩纹理、平台专用网格、序列化动画数据。它们通常可以重新生成,因此不应和源文件混为一谈。
一次导入如何形成最终资源
导入过程可以理解为:源文件与导入设置先进入导入器,导入器再结合引擎版本、目标平台等环境信息生成派生产物,同时把资源标识和依赖关系写入元数据。运行时真正加载的,往往是这些处理后的结果。
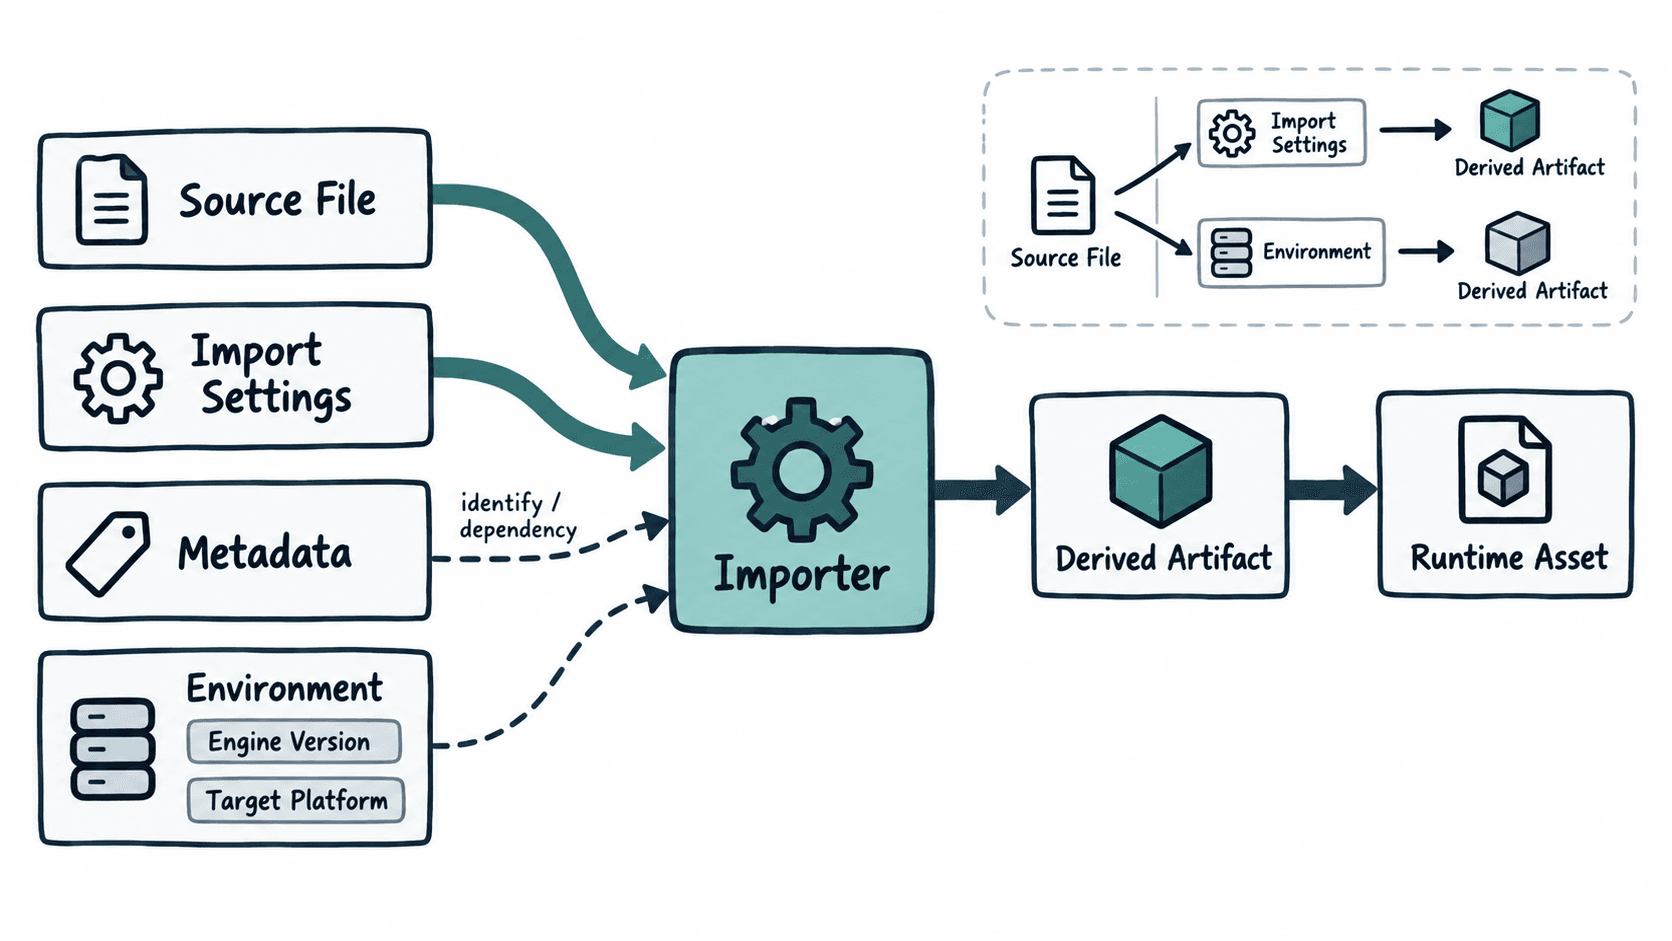
这也是为什么“把原文件复制过去”不等于“把资源完整迁移过去”。只复制源文件,可能遗漏 GUID、导入选项或项目级平台规则;只复制缓存则更脆弱,因为缓存通常与具体版本和环境绑定。
为什么相同源文件结果会不同
判断差异时,不要只比较文件哈希。更可靠的思路是同时比较“导入输入集合”。下面是一个片段示例,只是用于描述应记录哪些状态的抽象清单,不是 Unity、Unreal 或 Godot 的真实配置格式。
{
  "sourceHash": "sha256:<HASH>",
  "importer": "texture",
  "importSettings": {
    "mipmap": true,
    "compression": "project-default"
  },
  "environment": {
    "engineVersion": "<VERSION>",
    "targetPlatform": "<PLATFORM>"
  },
  "metadataId": "<ID>"
}
这份清单的生效含义是:只要其中任一影响导入的字段变化,就应该把最终派生产物视为“可能需要重新生成”。验证时可以固定源文件,逐项切换设置或目标平台,再观察导入后的尺寸、压缩格式、网格数据或资源依赖是否变化。
常见差异来源包括导入设置没有纳入版本管理、不同机器使用了不同引擎版本、平台覆盖规则不同,以及元数据文件被删除后重新生成。真正要追的是“哪些输入影响了导入器”,而不是简单归因于缓存。
如何让导入结果可复现
团队项目应优先把可声明的导入规则放进版本控制,并固定会影响资源处理的引擎版本、插件版本和平台配置。派生产物是否提交仓库,则取决于引擎和构建策略,但必须保证它们能够由受控输入重新生成。
排查时可以按“源文件是否一致 → 导入设置是否一致 → 元数据是否完整 → 引擎与平台环境是否一致 → 派生产物是否已重新生成”的顺序检查。这样即使最终现象只是材质变糊、骨骼错位或动画片段不同,也能快速定位到真正发生变化的状态层。