
游戏客户端架构 / 系统课时
如何用脚本批量修正资源属性
如何用脚本批量修正资源属性
一次批量修改最危险的不是“改错一项”,而是无法知道改了哪些文件、按什么规则改、失败后如何继续。本节用一个可重复执行的 Python 工具,把输入范围、修正规则、预览、日志与失败重试串成一条可审计的批处理链路。
学习目标
- 把批处理拆成明确的输入、规则、执行和日志边界
- 用 dry-run、幂等规则和原子写入降低批量污染风险
- 为失败项保留可重试信息,而不是整批从头再跑
先把批处理设计成可回放的任务
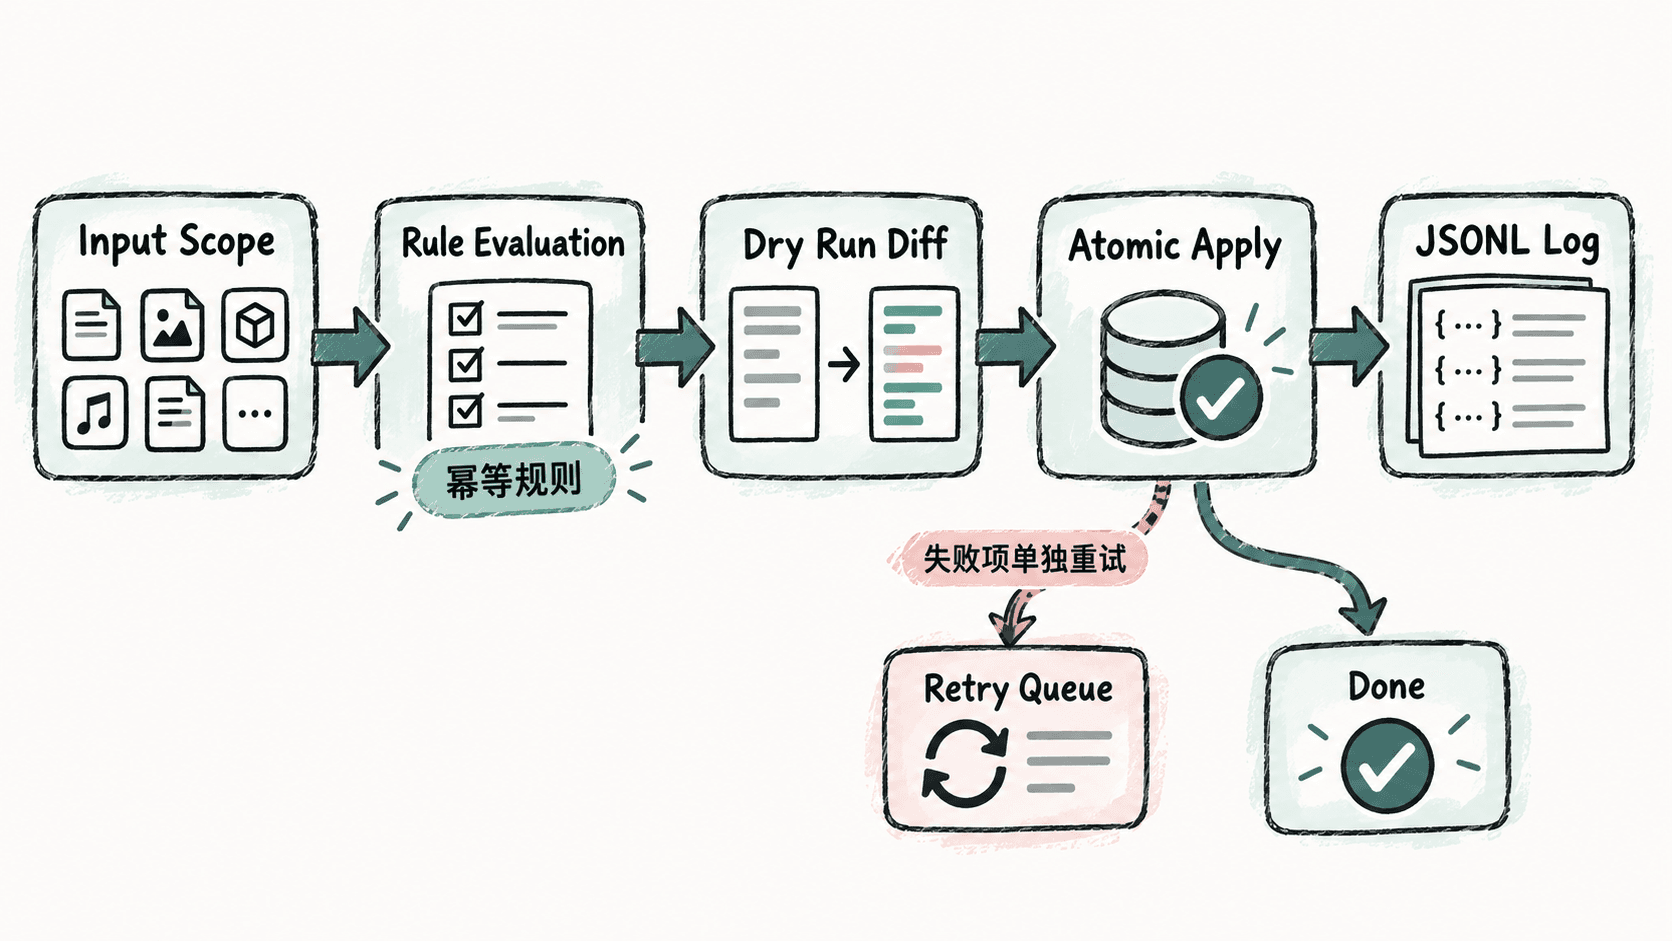
安全的批处理不应该“扫描到什么就改什么”。更稳妥的做法是固定输入范围,例如指定一个资源目录或清单;规则也必须有明确版本,并且只修改自己负责的字段。这样同一批输入可以先预览,再正式执行,还能在事后重放。
一个实用流程通常包含四个环节:读取候选资源、计算差异、写入修改、记录结果。失败项只进入重试队列,成功项不再次污染。
用幂等规则描述“应该是什么”
下面假设每个资源有一个同名的 .asset.json 元数据文件。规则只处理 kind 为 texture 且位于 ui 目录下的资源:关闭 mipmap,并把最大尺寸限制为 2048。规则描述的是目标状态,所以脚本重复运行时不会继续产生新变化。
示例资源元数据:
{
  "kind": "texture",
  "mipmaps": true,
  "maxSize": 4096
}
主脚本会先算出变更,再根据参数决定是否落盘;正式写入时先写临时文件,再用 os.replace 原子替换。每个文件的结果都会追加到 JSONL 日志,便于追踪和重试。将程序保存为 batch_fix.py,在包含 assets/ui/button.asset.json 的测试目录执行 python batch_fix.py assets;初次不要加 --apply。
from __future__ import annotations

import argparse
import json
import os
import time
from pathlib import Path

def desired_state(path: Path, data: dict) -> dict:
    result = dict(data)
    if data.get("kind") == "texture" and "ui" in path.parts:
        result["mipmaps"] = False
        result["maxSize"] = min(int(data.get("maxSize", 2048)), 2048)
    return result

def atomic_write(path: Path, data: dict, retries: int = 3) -> None:
    temp = path.with_suffix(path.suffix + ".tmp")
    payload = json.dumps(data, ensure_ascii=False, indent=2) + chr(10)

    for attempt in range(1, retries + 1):
        try:
            temp.write_text(payload, encoding="utf-8")
            os.replace(temp, path)
            return
        except OSError:
            if temp.exists():
                temp.unlink()
            if attempt == retries:
                raise
            time.sleep(0.2 * attempt)

def main() -> int:
    parser = argparse.ArgumentParser()
    parser.add_argument("root", type=Path)
    parser.add_argument("--apply", action="store_true")
    parser.add_argument("--log", type=Path, default=Path("batch-log.jsonl"))
    args = parser.parse_args()

    changed = 0
    failed = 0

    with args.log.open("a", encoding="utf-8") as log_file:
        for path in sorted(args.root.rglob("*.asset.json")):
            try:
                before = json.loads(path.read_text(encoding="utf-8"))
                after = desired_state(path, before)
                if before == after:
                    continue

                changed += 1
                if args.apply:
                    atomic_write(path, after)

                record = {
                    "path": str(path),
                    "status": "applied" if args.apply else "preview",
                    "before": before,
                    "after": after
                }
                log_file.write(json.dumps(record, ensure_ascii=False) + chr(10))
                print(f"[CHANGED] {path}")
            except Exception as exc:
                failed += 1
                record = {"path": str(path), "status": "failed", "error": str(exc)}
                log_file.write(json.dumps(record, ensure_ascii=False) + chr(10))
                print(f"[FAILED] {path}: {exc}")

    print(f"summary: changed={changed}, failed={failed}, apply={args.apply}")
    return 1 if failed else 0

if __name__ == "__main__":
    raise SystemExit(main())
预期输出:
[CHANGED] assets/ui/button.asset.json
summary: changed=1, failed=0, apply=False
确认日志中的 before 和 after 正确后,再使用 --apply 正式写入。实际项目中应先在独立分支或可回滚工作区执行,避免直接污染主干资源。
日志和失败重试要分开设计
日志至少要记录资源路径、执行状态、修改前值、修改后值和错误信息。这样失败后可以从 status=failed 的记录生成新的输入清单,只重跑失败资源,而不是重新扫描整批资产。
不要把“重试”理解成无条件重复写入。真正可重试的前提是规则幂等、输入可定位、成功状态可识别。满足这三点后,批处理脚本才从一次性工具变成可重复执行的资产流水线能力。