
游戏客户端架构 / 系统课时
大资源文件为什么不能只靠 Git 默认方案
大资源文件为什么不能只靠 Git 默认方案
代码仓库里放少量图片通常没有问题,但当 PSD、FBX、音频、视频等二进制资产持续迭代后,Git 默认对象模型会放大仓库体积、拉取成本和协作冲突。解决思路不是简单“换工具”,而是先判断哪些文件仍适合 Git,哪些应交给 Git LFS 或专门的大资产版本系统。
学习目标
- 理解大二进制文件为什么会让 Git 仓库快速膨胀
- 能判断 Git LFS 能解决什么,以及它不能解决什么
- 能按资源类型和团队协作方式选择合适的版本控制方案
Git 默认方案在二进制资产上吃亏在哪里
Git 会把提交内容组织成对象并保留历史版本。文本文件通常能通过差异和压缩获得较好效果,但 PSD、压缩纹理、音频、视频和很多模型文件本身已经是二进制格式,修改一点内容也可能让新版本产生大量字节变化。
结果有三个直接成本:仓库历史不断增长;新成员克隆仓库时需要获取大量旧版本对象;发生冲突时,Git 很难像处理源代码那样把两个二进制版本进行有意义的行级合并。
更重要的是,删除工作区里的大文件并不会自动删除它曾经写入的历史对象。只要旧提交仍然可达,那部分体积依然属于仓库历史。
Git LFS 改变的是“大文件放在哪里”
Git LFS 的核心做法是:Git 仓库里保存一个很小的指针文件,真正的大对象存到 LFS 对象存储。工作区检出时,Git LFS 再把对应的大对象还原为开发者实际看到的文件。
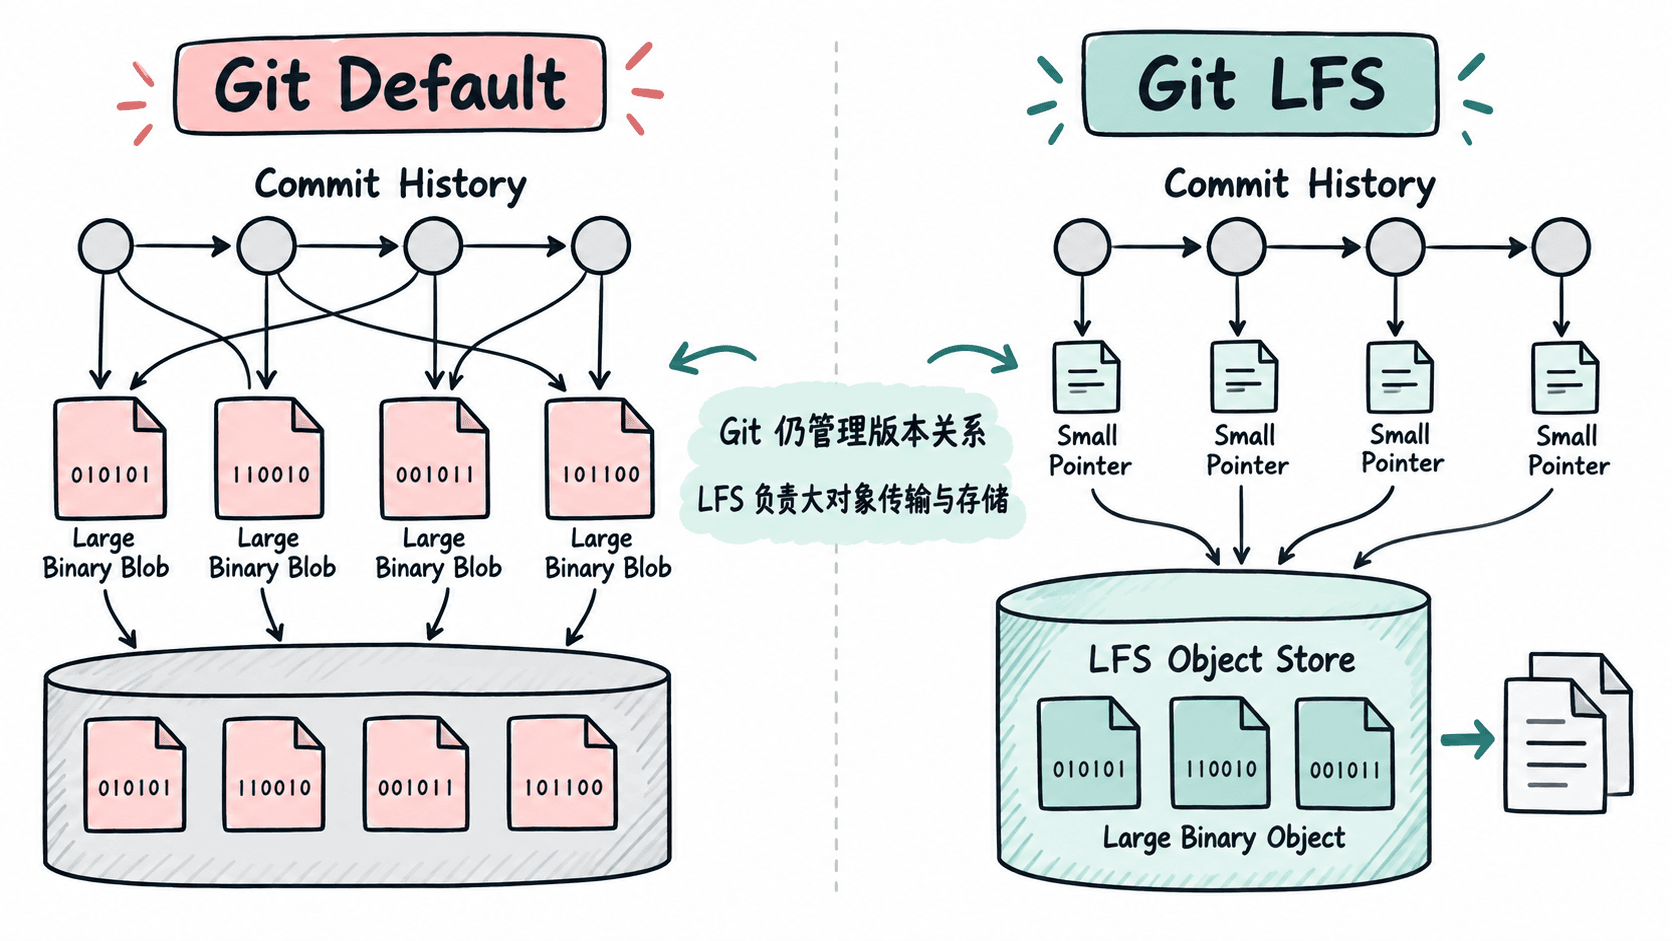
因此,Git LFS主要缓解的是 Git 对象库和普通克隆路径承载大文件的问题,但它没有把二进制文件变成“可合并文本”。两个美术同时修改同一个 PSD,语义冲突依旧存在;如果需要独占编辑,还要依赖团队流程或托管端支持的文件锁能力。
最小追踪规则
Git LFS 通过 .gitattributes 判断哪些路径由 LFS 过滤器处理。下面是一个典型配置,适合把大型源美术、模型和未压缩音频交给 LFS:
*.psd filter=lfs diff=lfs merge=lfs -text
*.fbx filter=lfs diff=lfs merge=lfs -text
*.wav filter=lfs diff=lfs merge=lfs -text
这段配置的生效行为是:匹配到的文件提交时由 LFS 过滤器转换为指针,检出时再还原真实内容。验证时应先确认本机已安装 Git LFS、远端仓库支持 LFS,然后检查目标文件的 filter 属性是否为 lfs,并确认提交后的仓库对象没有再次直接写入完整大文件。
不同方案各自适合什么场景
| 方案 | 更适合 | 主要边界 |
|---|---|---|
| Git 默认存储 | 小文件、文本资产、少量不频繁变化的二进制 | 历史体积和二进制冲突会随版本增长 |
| Git LFS | 团队仍以 Git 为主,同时存在较多大型二进制源资产 | 需要额外对象存储;不能自动解决二进制合并 |
| 面向大资产的集中式版本系统 | 超大资源库、美术人员多、强依赖锁定和按需工作区 | 运维和流程成本通常高于纯 Git |
| 对象存储或制品仓库 | 构建产物、缓存、可再生成文件 | 不适合作为需要逐版本编辑的源资产仓库 |
一个常见误区是把所有“大文件”都塞进 LFS。真正应该进入版本控制的是源资产和必须可追溯的输入;自动生成的纹理缓存、烘焙中间产物、构建包和可重复下载的第三方制品,更适合进入缓存、对象存储或制品仓库,而不是继续扩大源码仓库历史。
用协作方式而不是文件大小单独做决定
文件大小只是一个信号。一个 20 MB、半年不改一次的参考资源,可能继续放 Git 也没有明显问题;一个不断修改、每次产生完整新版本的 200 MB PSD,即使团队只有几个人,也很快会让仓库历史和网络传输变得昂贵。
判断时同时看四件事:文件是否为不可读二进制、是否频繁修改、是否需要多人同时编辑、是否必须保存每个历史版本。Git LFS 最适合“仍想保留 Git 工作流,但大对象不应直接进入 Git 对象库”的团队;如果核心矛盾已经变成海量资产、独占锁定和按需同步,专门的大资产版本系统通常更合适。
版本方案一旦确定,最好在项目早期就固定追踪规则。越晚迁移,越容易遇到历史重写、远端存储费用、CI 拉取策略和成员重新同步等额外成本。