
原生移动开发 / 系统课时
给性能数据设置基线阈值
给性能数据设置基线阈值
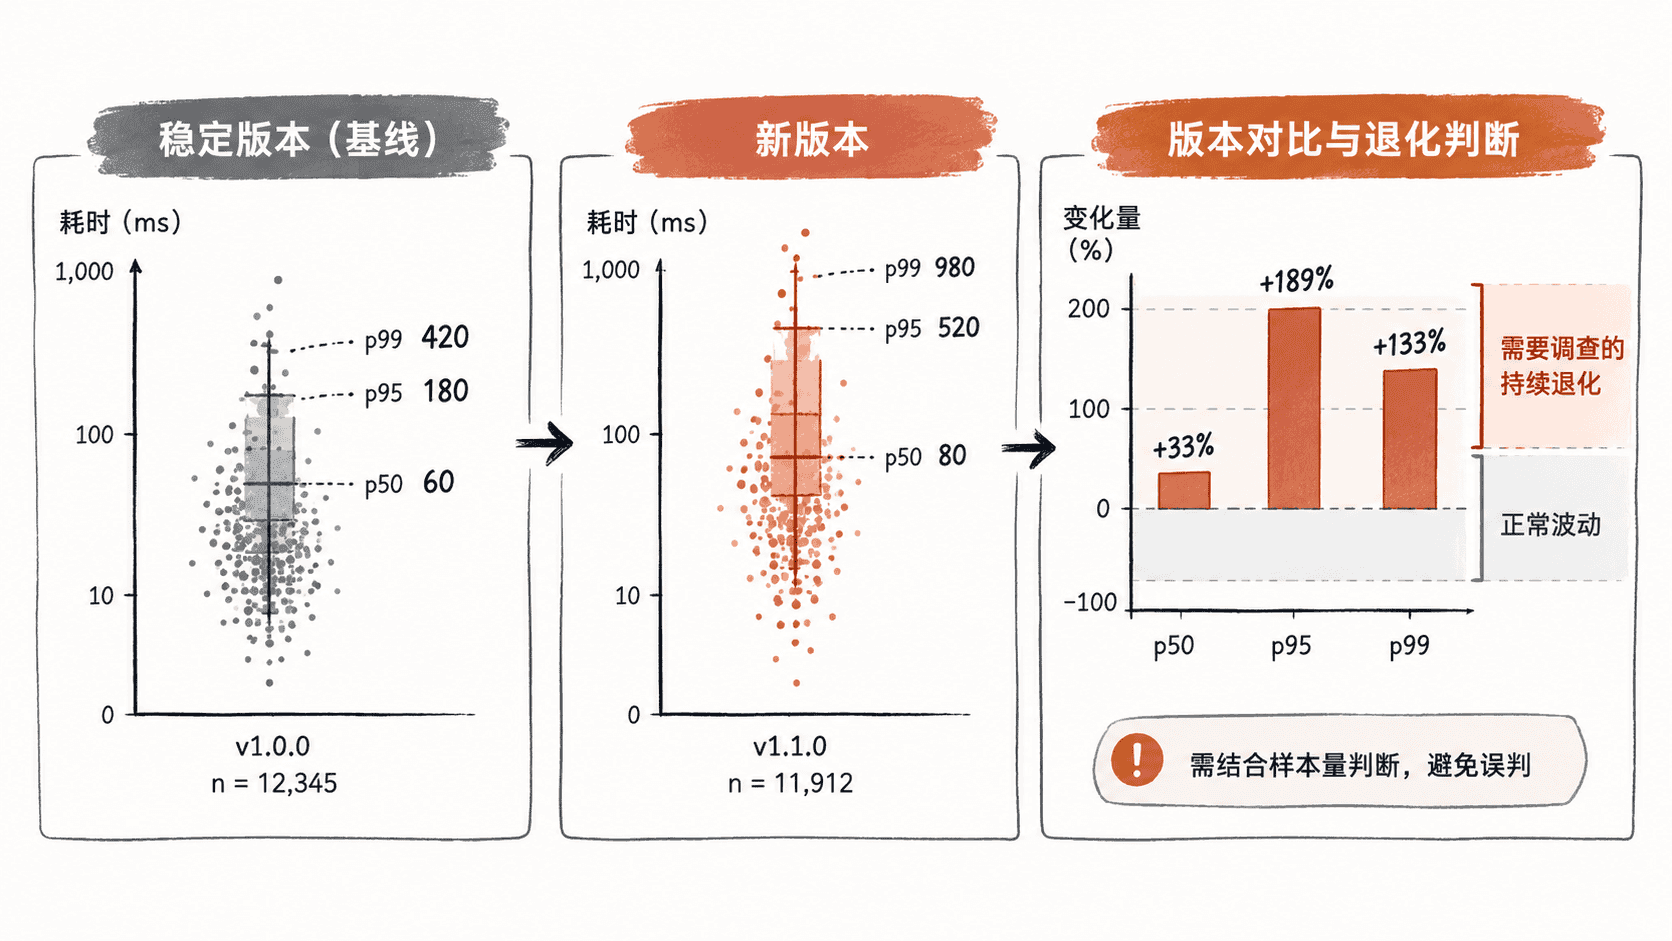
性能阈值不能靠“感觉上这个数字应该正常”来设定。更可靠的方法是先收集稳定版本的数据,建立基线分布,再用 p50、p95、p99 等分位数与新版本对比,区分正常波动和明显退化。
学习目标
- 理解性能基线与单点阈值的区别
- 使用分位数描述长尾性能指标
- 按版本和关键维度判断性能是否发生退化
先建立可比较的基线
基线回答的是“正常情况下,这个指标通常处于什么范围”。例如一个稳定版本积累了足够样本后,可以得到启动耗时的 p50、p95 和 p99。新版本上线后,用相同口径重新计算,再比较相对变化。
不要直接拿不同场景的数据混合比较。冷启动和热启动、不同页面、不同 Android 版本的分布可能天然不同。基线最好与业务场景和关键设备维度绑定,并保持采样和过滤规则一致。
用分位数描述长尾
假设一组性能样本按从小到大排序,p95 表示约 95% 的样本不超过该位置,剩余少量样本构成长尾。相比平均值,p95 和 p99 更适合观察“最慢的一批用户体验”。
下面的 Python 示例使用最常见的线性插值方式计算分位数,适合演示基线计算流程。真实监控系统可能采用不同的近似算法,因此对线上平台数据应以平台定义为准。
from typing import Sequence


def percentile(values: Sequence[float], p: float) -> float:
    if not values:
        raise ValueError("values must not be empty")
    if not 0 <= p <= 100:
        raise ValueError("p must be between 0 and 100")

    data = sorted(values)
    position = (len(data) - 1) * p / 100
    lower = int(position)
    upper = min(lower + 1, len(data) - 1)
    weight = position - lower
    return data[lower] + (data[upper] - data[lower]) * weight


def main() -> None:
    samples = [820, 860, 900, 940, 980, 1020, 1100, 1280, 1500, 1800]
    print(f"p50={percentile(samples, 50):.0f} ms")
    print(f"p95={percentile(samples, 95):.0f} ms")
    print(f"p99={percentile(samples, 99):.0f} ms")


if __name__ == "__main__":
    main()
预期输出:
p50=1000 ms
p95=1665 ms
p99=1773 ms
这里的基线并不是“超过某个固定毫秒数就失败”,而是一组描述正常分布的统计量。上线比较时,应保证新旧版本使用同样的指标口径、场景和筛选条件。
用相对变化识别退化
仅比较绝对差值有时不够。例如 p95 从 1000 ms 变成 1100 ms,与从 4000 ms 变成 4100 ms 都增加了 100 ms,但用户体验含义并不相同。可以同时查看绝对变化和相对变化:
实际告警规则还应考虑样本量、自然波动和业务影响。一个常见思路是先把“观察阈值”和“阻断阈值”分开:轻微变化进入观察,大幅且稳定的退化才触发发布门禁或人工处理。
版本对比时先检查样本质量
当新版本的 p95 明显升高时,先确认它不是统计假象。至少检查三个条件:指标口径是否改变、样本量是否足够、版本和设备构成是否发生明显变化。
例如旧版本有大量中端设备样本,新版本却只有旗舰设备,直接比较整体 p95 就可能得到误导结论。此时应按关键设备族或 Android 版本分别比较,再观察整体指标。
还要避免把一次极端异常直接设成新基线。基线应该来自一段相对稳定的数据窗口,并在采集规则或业务行为发生变化后重新评估,而不是看到单日波动就立即调整阈值。
把阈值变成可执行规则
性能回归最终要落到行动上。建议为每个关键指标记录“基线值、允许波动、观察条件、处理条件”,并明确对应版本和维度。例如某指标的 p95 在多个连续采样窗口中持续高于基线一定比例,才升级为发布回归事件。
这种规则比“一次超过固定值立即报警”更稳定,因为它同时考虑了分布、版本和持续性。真正有效的基线不是一个漂亮的数字,而是一套可以重复计算、可以解释异常、能够指导下一步排查的比较标准。