
原生移动开发 / 系统课时
定位频繁分配与 GC 抖动
定位频繁分配与 GC 抖动
当应用没有明显泄漏,却频繁出现卡顿、短时间内内存暴涨又回落,常见原因不是某个对象永远不释放,而是业务在短时间内制造了大量临时对象,导致 GC 频繁介入。排查的关键是把“分配发生在哪里”和“GC 为什么变密集”对应起来。
学习目标
- 能从内存与 GC 现象区分持续泄漏和短时高分配。
- 能识别循环创建对象、临时集合和字符串拼接造成的分配热点。
- 能用分配分析结果定位代码位置,并在修改后重新验证。
先看现象是否符合分配抖动
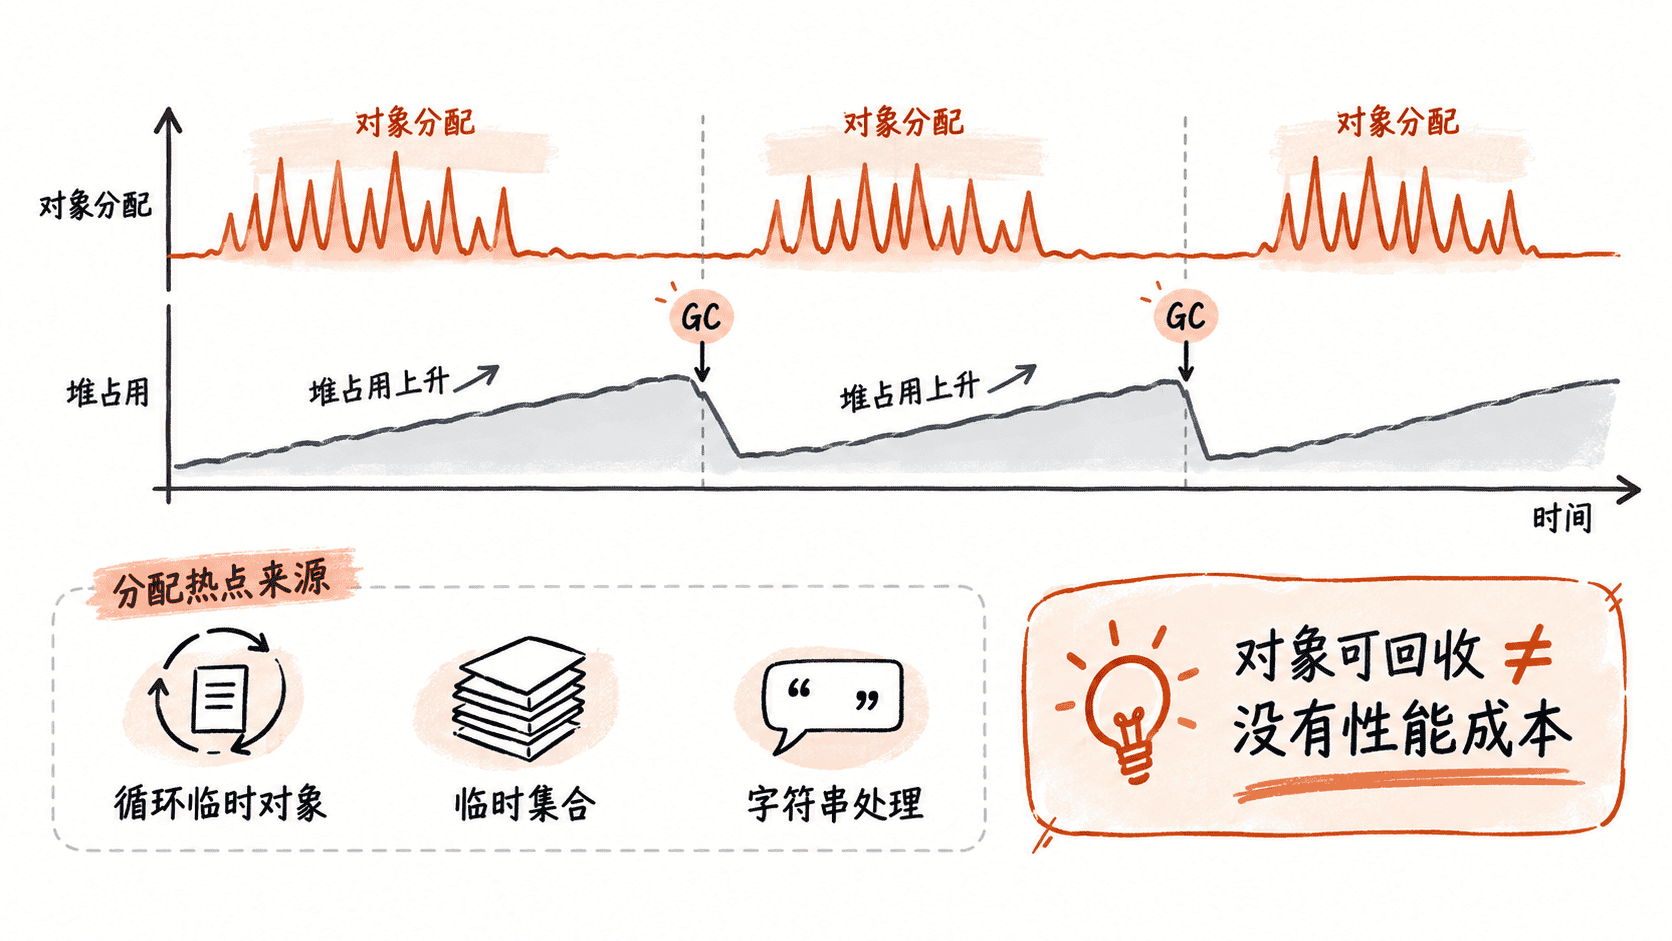
典型表现是堆使用量快速上升,随后在 GC 后明显下降,然后很快再次上升;这个过程反复出现时,说明应用可能在不断创建短命对象。若 GC 频率升高同时伴随主线程耗时增加,卡顿就可能来自 GC 与对象管理成本叠加。
与泄漏相比,短时高分配更强调“创建速度”。一个对象最终能够被回收,并不意味着创建它没有成本;当每帧、每次列表绑定或每次循环都制造大量临时对象时,GC 压力仍会很高。
用内存数据确认压力模式
可以先用 dumpsys meminfo 获取进程当前的内存概况。它不能直接告诉你哪一行代码在分配对象,但适合在复现过程中确认进程是否持续产生内存压力,再配合 Android Studio Memory Profiler 的 Allocations 记录定位具体类型与调用位置。
adb shell dumpsys meminfo com.example.app预期输出
Applications Memory Usage (in Kilobytes):
Uptime: <TIME>

** MEMINFO in pid <PID> [com.example.app] **
                   Pss  Private  Private  SwapPss
                 Total    Dirty    Clean
Dalvik Heap     <VALUE>   <VALUE>       0       0
Native Heap <VALUE> <VALUE> 0 0<PID>、<TIME> 和各内存数值会随设备状态与运行负载变化。重点不是记住某个固定数字,而是结合重复操作观察趋势,并进一步用分配记录确定热点对象。
从分配热点回到代码
重点检查三个模式。第一是循环中不断执行 new 或创建临时 Kotlin 对象,例如每次迭代都实例化数据包装器。第二是循环中反复创建集合并立即丢弃。第三是高频字符串拼接、格式化和转换,特别是在 UI 刷新、滚动或高频回调路径中。
例如下面这种写法可以作为排查线索:每次调用 renderItems() 都新建一个列表,并为每个元素创建临时字符串对象。如果该方法每帧或高频执行,短命对象数量会快速累积。
class ItemRenderer {
    fun renderItems(items: List<Int>): List<String> {
        val result = ArrayList<String>(items.size)
        for (item in items) {
            result.add("item=$item")
        }
        return result
    }
}
预期结果
调用 renderItems() 后会生成新的 ArrayList,并为结果中的字符串创建新的对象;高频调用时会增加短命对象分配量。这个片段用于说明“分配来源”,不能单独证明一定存在性能问题。实际定位时,应把 Allocation 记录中的高频类型、调用栈和复现时间对应到具体方法,再判断这些对象是否真的可以复用、延迟创建或减少转换。
修复思路要围绕分配热点
不要看到 GC 频繁就简单地“减少 GC”。GC 是结果,不是根因。更直接的办法是降低分配速率:把循环外可以复用的对象移出循环,避免无意义的临时集合,在高频路径减少字符串格式化,并检查 UI 刷新是否重复计算相同数据。
优化后必须用同样的操作步骤再次记录分配情况。若目标对象的分配次数、GC 频率和对应操作耗时同时下降,才能说明修改真的降低了抖动;只看到一次较低的堆占用,并不能证明问题已经解决。