
原生移动开发 / 系统课时
读取 Native 崩溃 Tombstone
读取 Native 崩溃 Tombstone
当 Android 原生层发生崩溃时,Logcat 往往只能告诉你进程因某个信号退出;Tombstone 则把崩溃线程、寄存器、调用栈和内存映射集中记录下来。读懂这些字段,才能把问题从“Native 崩了”进一步定位到具体模块和调用路径。
学习目标
- 能识别 Tombstone 中信号、线程、寄存器和调用栈的作用
- 能从崩溃线程的栈帧判断问题主要位于 App、JNI 还是原生库
- 能用 adb 获取并保留可分析的 Tombstone 现场
Tombstone 在回答什么问题
Tombstone 是 Native crash 的现场快照。排查时不要一上来通读全文,而要先回答四个问题:什么信号导致退出、哪个线程触发、崩溃地址附近执行了什么、最后落在哪个模块。
典型现场可以抽象成“信号 → 崩溃线程 → 寄存器 → 调用栈 → 模块”。这些信息彼此有关:信号说明失败类型,线程告诉你执行主体,寄存器提供 CPU 当时的关键状态,调用栈负责还原路径,模块则帮助判断责任边界。
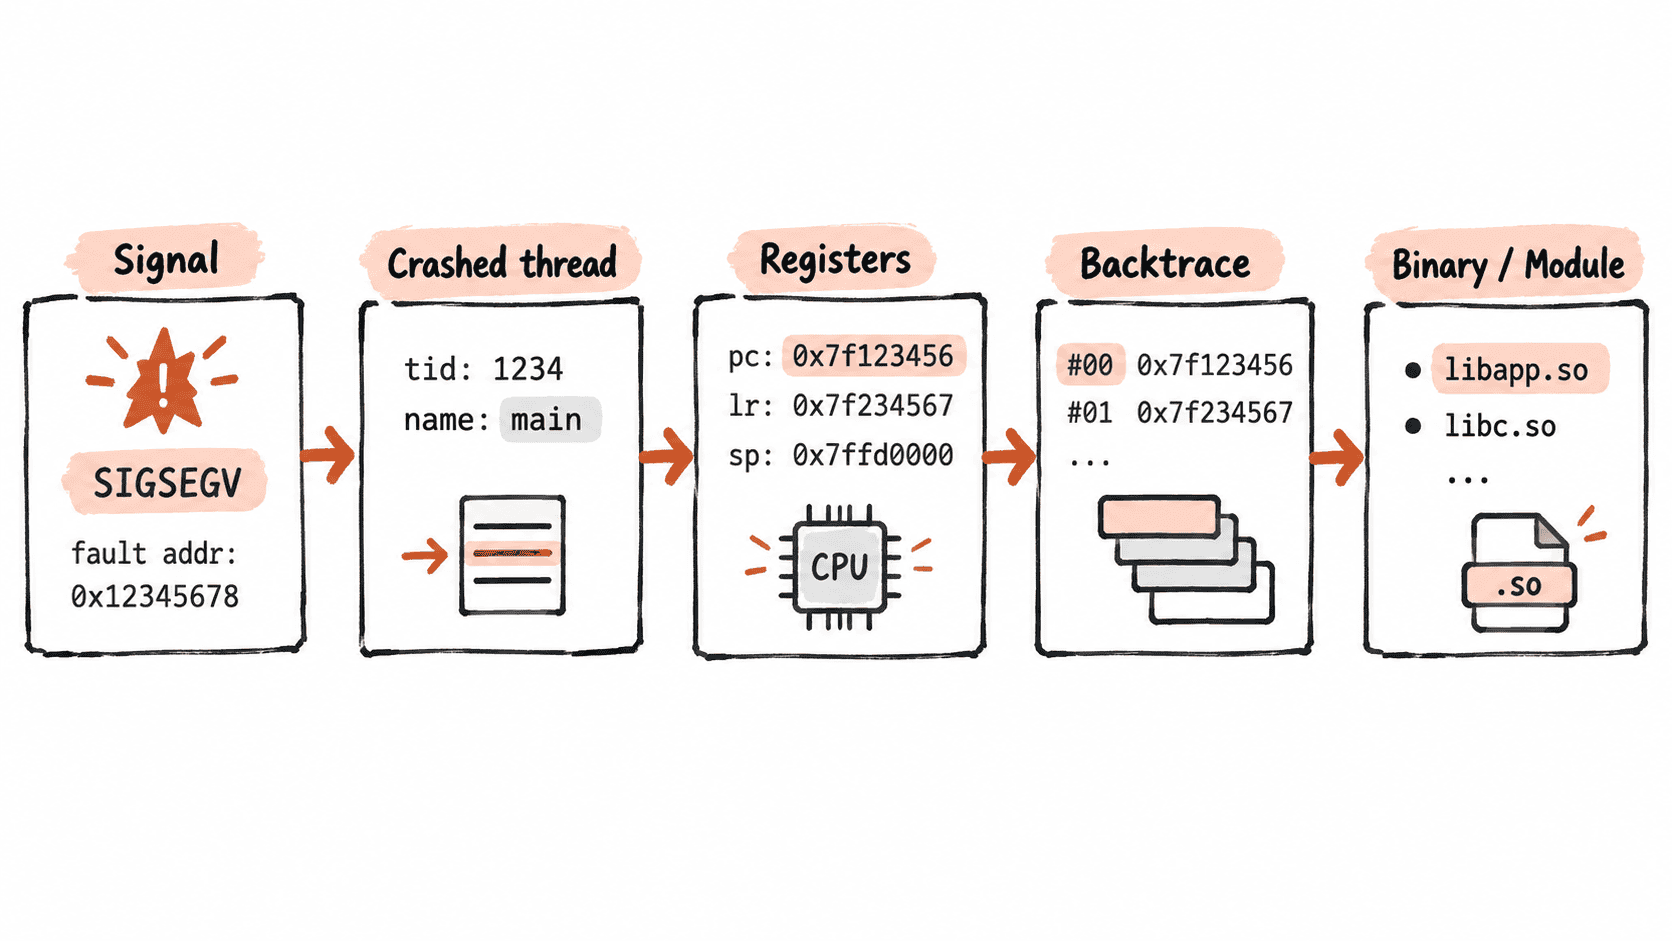
先看信号与崩溃线程
优先寻找类似 signal 11 (SIGSEGV)、signal 6 (SIGABRT) 的信息。SIGSEGV 常与非法内存访问有关;SIGABRT 则经常意味着进程主动触发 abort,不能仅凭信号判断具体根因。
接着定位 backtrace 前标出的崩溃线程。Native 程序可能同时有多个线程,真正发生故障的线程通常会被明确标识。分析时必须围绕这个线程的调用栈展开,而不是拿任意线程的最后几行调用当作根因。
读取寄存器与调用栈
寄存器最重要的是 pc、lr、sp 等值。pc 表示崩溃时正在执行的位置,lr 在常见架构中保存返回地址线索,sp 用于理解当前栈位置。实际定位通常需要结合符号化后的函数名和源码行号。
调用栈从 #00 开始向下阅读。越靠前通常越接近实际故障点,但 #00 不一定就是业务根因。例如 libc.so 中的崩溃可能只是最后触发检查的位置,真正传入非法指针的代码可能位于更上游的 libapp.so 或其他 JNI 模块。
用 adb 保存现场
在可读取 Tombstone 的设备或调试环境中,可以先按时间排序查看现场文件,再拉取目标文件进行离线分析。实际设备上的文件名和数量可能不同。
adb shell ls -lt /data/tombstones/
adb pull /data/tombstones/tombstone_00 <PATH>/tombstone_00
预期输出
total 24
-rw------- 1 root root 18432 <TIME> tombstone_00
-rw------- 1 root root 17690 <TIME> tombstone_01
...
adb pull 能否成功取决于设备权限和构建类型;普通量产设备可能拒绝直接读取 /data/tombstones/。这种情况下应保留系统生成的 bugreport 或由具备权限的测试环境导出现场,而不是修改设备权限后继续复现生产问题。
从调用栈判断责任模块
看到一段栈后,可以先按模块分组。若 #00 到 #03 都位于同一个自研 lib*.so,且函数名或源码行可符号化,通常可以优先检查该模块的数据生命周期、指针有效性和线程同步。若栈主要落在 JNI 边界,则继续检查 Java/Kotlin 与 Native 参数转换、对象生命周期以及线程附着关系。
一个实用的判断顺序是:先确认 #00 是否可信,再找最近的业务模块帧,然后回到该帧的入参和所有权关系。遇到只有地址没有函数名的情况,应先解决符号信息问题;否则继续猜测具体代码位置没有意义。
例如同一条栈同时出现 libapp.so、libc.so 和 libart.so 时,不要按模块出现次数判断责任。真正有价值的是调用方向:业务代码把什么数据传给下层、哪个边界首次出现异常状态、哪个栈帧拥有可验证的源码证据。
处理没有完整符号的现场
没有函数名时,优先保存原始 Tombstone、对应 APK/AAB、Native .so 文件以及与发布版本匹配的符号文件。符号必须与崩溃版本一致,否则即使能解析出函数名,也可能映射到错误源码。
最终定位通常需要把“信号类型 + fault addr + 崩溃线程 + #00~#N 调用栈 + 模块版本”放在一起看。Tombstone 的价值不是给出一句现成结论,而是把一次 Native 崩溃还原成可以验证的执行现场。