
原生移动开发 / 系统课时
从 OOM 现场反推内存来源
从 OOM 现场反推内存来源
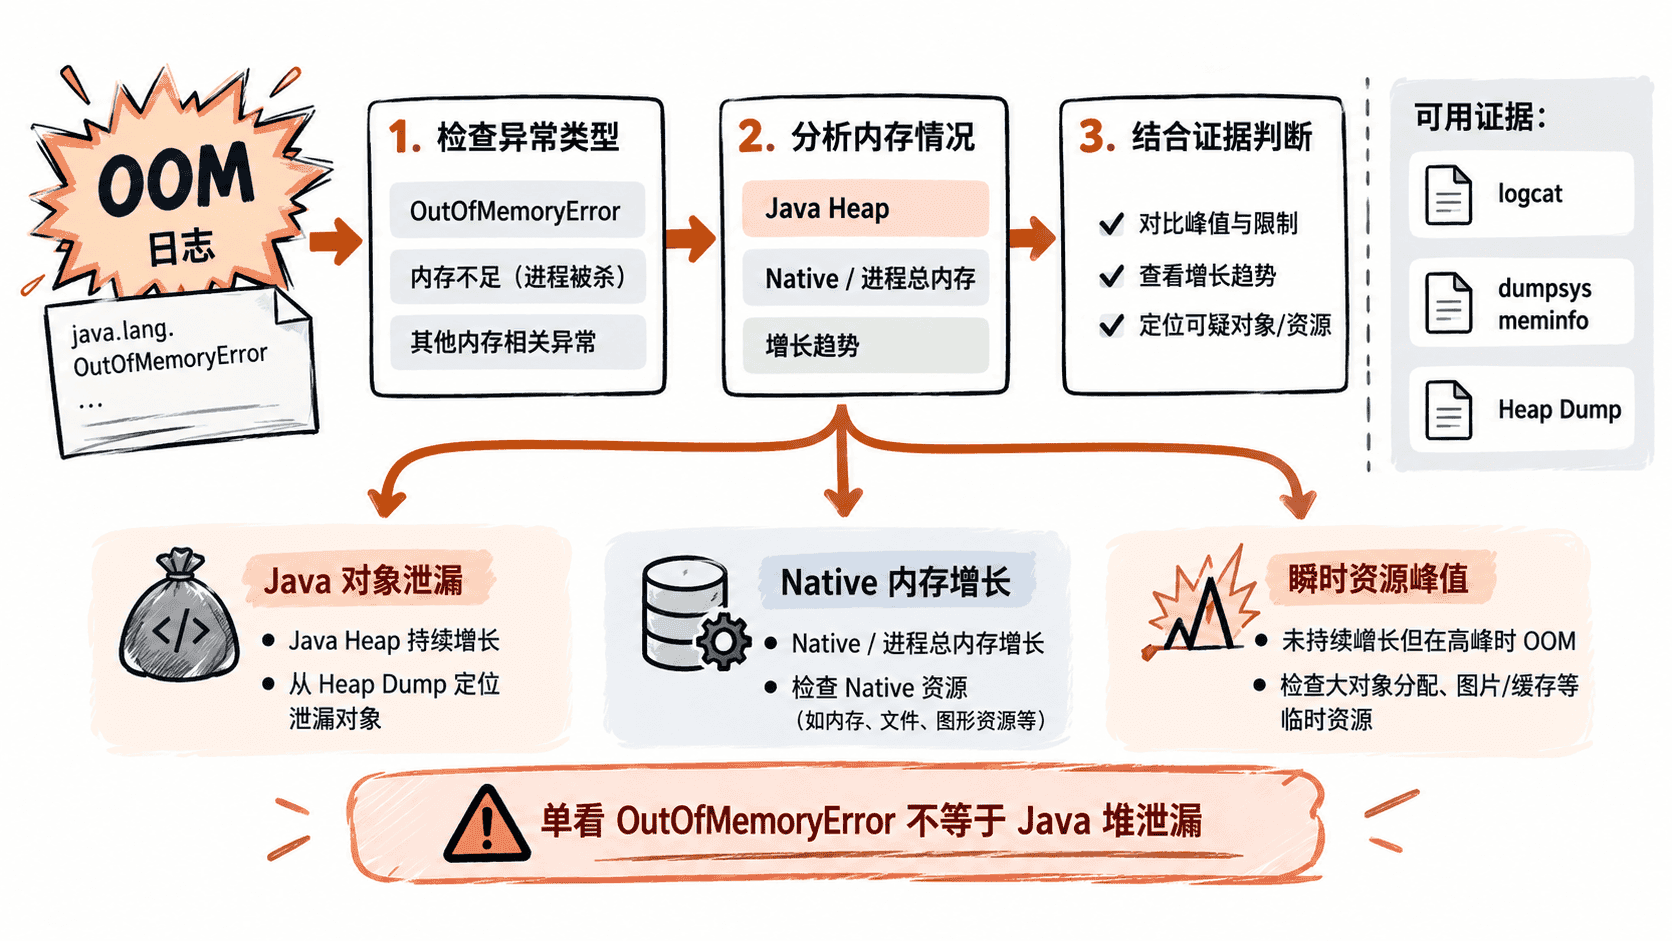
遇到 OOM 时,最容易犯的错误是看到 OutOfMemoryError 就直接认定 Java 堆满了。真正排查应把日志、进程内存状态和堆快照放在一起判断,区分 Java/Kotlin 对象、Native 分配以及短时间资源峰值,再决定修复方向。
学习目标
- 能从 OOM 日志判断异常发生在什么内存语境
- 能用进程内存信息和堆快照交叉验证主要内存来源
- 能区分长期泄漏、Native 增长和瞬时峰值三类问题
先判断 OOM 描述了什么
Java 堆相关 OOM 通常会直接出现 java.lang.OutOfMemoryError,但这并不意味着所有进程内存都来自 Java 对象。Bitmap、JNI、图形缓冲区、文件映射和其他 Native 分配,都可能让进程内存明显上升。
因此排查时先问三个问题:异常发生时 Java Heap 是否接近上限、进程总内存是否同步升高、崩溃前增长是持续还是突然发生。 这三个答案通常比单看异常字符串更有价值。
先用进程状态建立基线
在崩溃复现前后采集同一个进程的内存信息,可以先判断增长集中在哪一层。dumpsys meminfo 适合做现场快照,尤其适合比较多次采样结果,而不是只看一次数字。
adb shell dumpsys meminfo com.example.app预期输出
Applications Memory Usage (in Kilobytes):
Uptime: <TIME> Realtime: <TIME>

** MEMINFO in pid <ID> [com.example.app] **
                   Pss  Private  Private  SwapPss      Heap      Heap      Heap
                 Total    Dirty    Clean    Dirty      Size     Alloc     Free
Native Heap      32768    32000      512      256     65536     49152     16384
Dalvik Heap      24576    22000      128      512     32768     24576      8192
TOTAL PSS        98304    87000     2048     1024
实际输出字段会随 Android 版本和设备实现变化,重点不是背字段,而是比较 Native Heap、Dalvik Heap、总 PSS 以及多次采样之间的变化。
用增长趋势区分三类来源
如果 Java Heap、对象数量和总 PSS 一起持续上涨,并且触发 GC 后下降很少,应优先检查长生命周期引用链,例如静态集合、单例持有 Activity、未注销监听器或后台任务长期持有对象。这类现象更像 Java/Kotlin 对象保留。
如果 Java Heap 相对稳定,但 Native Heap 或总 PSS 持续增长,则应把检查范围扩大到 JNI、Bitmap、媒体、压缩解码、图形和其他 Native 分配。此时只分析 Java Heap 很容易得到错误结论。
如果内存平时正常,只在大图解码、批量 JSON 处理、视频帧处理或一次性缓存时突然冲高,再迅速回落,通常更接近瞬时峰值。这类问题重点是降低峰值或拆分工作,而不是寻找长期泄漏链。
| 现场特征 | 更值得先检查 | 常见处理方向 |
|---|---|---|
| Java Heap 持续增长,GC 后仍高 | Java/Kotlin 对象引用链 | Heap Dump、引用链、生命周期 |
| Native/总 PSS 持续增长,Java 相对稳定 | JNI、Bitmap、媒体、Native 库 | Native 分配来源、资源释放 |
| 只有特定操作瞬时暴涨 | 单次大对象或批量任务 | 分块处理、限流、降低缓存峰值 |
用堆快照验证“谁在占内存”
当日志和 dumpsys meminfo 指向 Java Heap 后,再抓取 Heap Dump 检查对象数量、浅大小和保留大小。真正值得关注的是 Retained Size 和引用链:一个小对象本身可能不大,但如果它间接保留了一整棵 Activity、View 或缓存对象树,实际影响会非常大。
排查时不要只搜索数量最多的类。应优先观察快速增长的实例、生命周期本应结束却仍存活的组件,以及明显的根引用,例如静态字段、线程、消息队列和长生命周期管理器。
从 OOM 时间点反推触发动作
最后把内存曲线与业务操作对齐:是打开图片详情后快速上涨,还是进入后台几分钟后持续增长?是滚动列表时逐步积累,还是一次导入大量数据时瞬间冲高?
能够把“异常时间点”与“具体动作”对应起来,才能把修复从猜测变成验证。修复后重复相同操作,再比较 Java Heap、Native Heap 和总 PSS 是否恢复到接近基线;只有复现与修复前后证据都一致,OOM 的来源判断才算闭环。