
原生移动开发 / 系统课时
控制并发请求与接口瀑布
控制并发请求与接口瀑布
一个页面加载慢,不一定是单个接口慢。更常见的情况是请求被错误地串成瀑布,或者一次页面展示触发了大量重复请求。排查时应先画清请求依赖关系,再决定哪些请求可以并发、哪些必须等待前置结果。
学习目标
- 区分真正的业务依赖与人为造成的串行等待
- 识别重复请求、过量并发和接口瀑布三类问题
- 能用协程并发改造独立请求,并保留必要的依赖顺序
先区分依赖和等待
假设页面需要用户资料、首页公告和推荐列表。如果三个接口互不依赖,却写成“用户资料返回后请求公告,公告返回后请求推荐”,总耗时会接近三个接口耗时之和,这就是典型的请求瀑布。
但如果推荐接口必须携带用户身份或实验分组结果,那么推荐请求确实依赖用户接口。此时不应该为了追求并发而强行同时请求,而应保留业务上的先后关系。
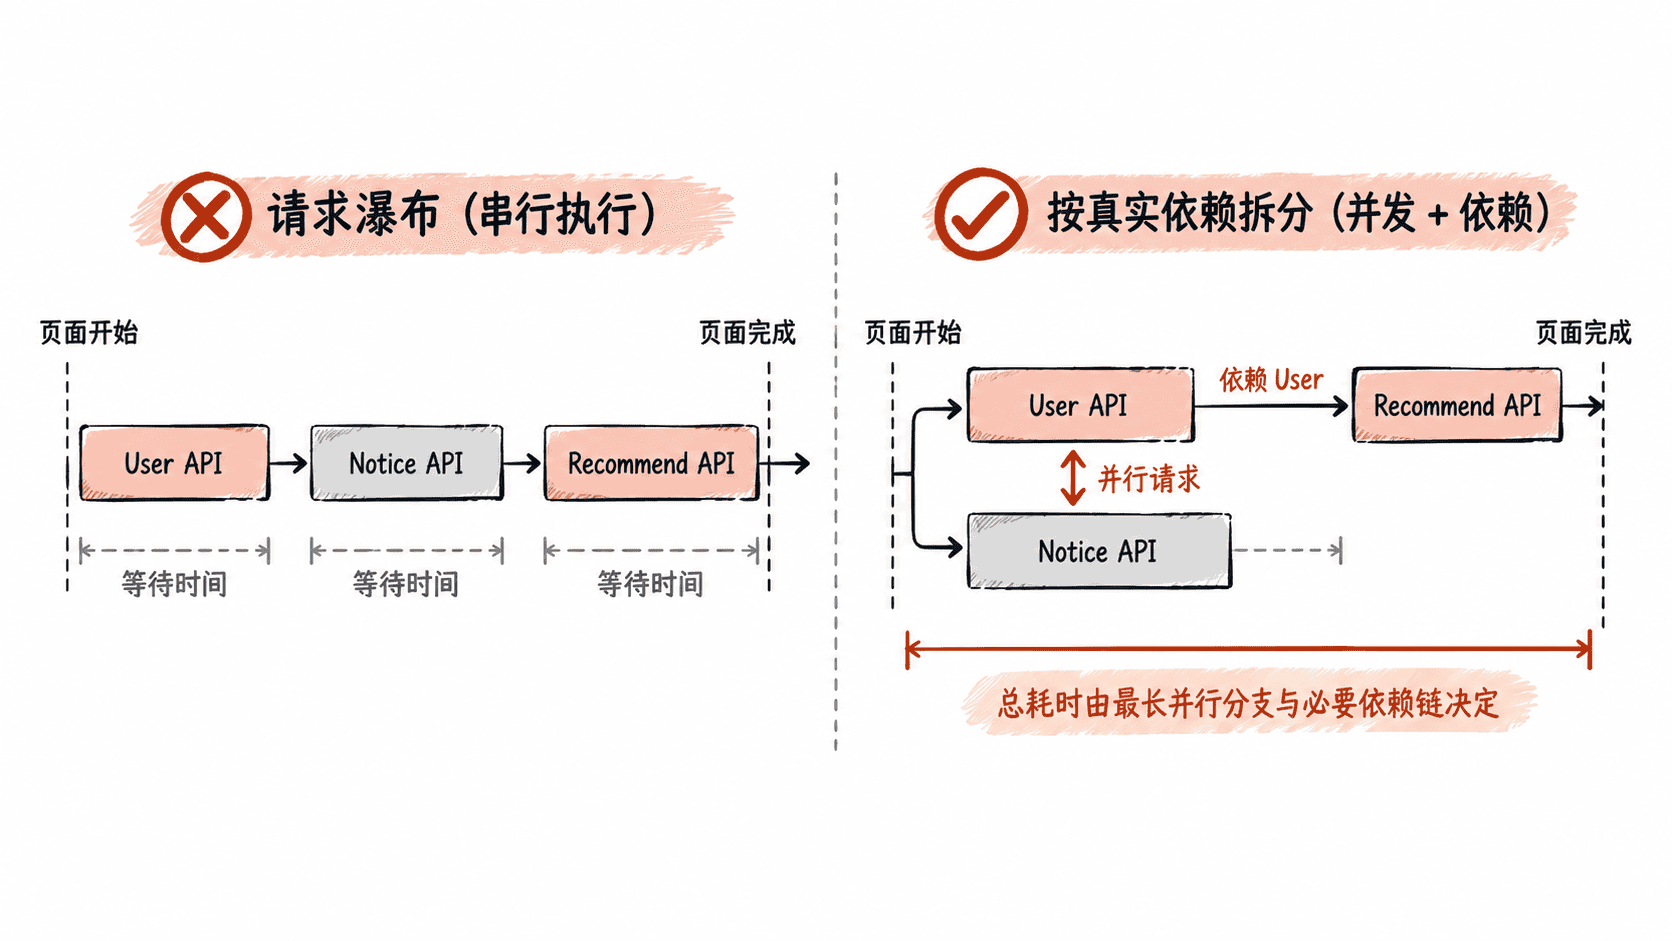
用并发缩短独立请求等待
在 Kotlin 协程中,可以使用 async 表达需要并发执行的独立任务,再统一 await 结果。下面是片段示例,前提是调用方已经在合适的协程作用域中运行,并且三个挂起函数分别执行网络请求。
import kotlinx.coroutines.async
import kotlinx.coroutines.coroutineScope

data class HomeData(
    val user: User,
    val notice: Notice,
    val recommendations: List<Recommendation>
)

suspend fun loadHome(): HomeData = coroutineScope {
    // 互不依赖的请求同时启动,避免人为形成瀑布。
    val userDeferred = async { loadUser() }
    val noticeDeferred = async { loadNotice() }
    val recommendationsDeferred = async { loadRecommendations() }

    HomeData(
        user = userDeferred.await(),
        notice = noticeDeferred.await(),
        recommendations = recommendationsDeferred.await()
    )
}
预期结果:三个独立请求在同一个协程作用域中并发启动,页面等待时间不再简单等于三个接口耗时直接相加;实际耗时仍受网络、服务端处理和客户端并发限制影响。
识别重复请求和请求风暴
并发并不是越多越好。首先看同一个 URL、相同参数和相同业务场景是否在短时间内被重复调用。例如页面重组、生命周期重复进入或多个 ViewModel 同时初始化,都可能让同一资源被请求多次。
可以把网络日志按“接口、参数、触发来源、时间”聚合。若同一页面出现大量完全相同的请求,先消除重复触发,再讨论并发数量;若请求本身都不同,但瞬时并发过高,则需要检查服务端限流、连接资源和客户端调度策略。
| 现象 | 更可能的原因 | 排查重点 |
|---|---|---|
| 请求一个接一个完成 | 人为串行或存在真实依赖 | 检查调用链和 await 位置 |
| 同一接口短时间大量出现 | 重复触发、缓存缺失或状态失控 | 检查生命周期与数据源 |
| 并发后整体反而变慢 | 并发过高、服务端限流或连接资源竞争 | 检查服务端限制与客户端调度 |
| 某一步必须等前一步 | 存在业务数据依赖 | 明确前置输入是否真的需要 |
用时间线验证优化是否有效
不要只比较代码改动前后的平均耗时。至少记录页面开始时间、每个请求开始与结束时间,以及请求是否命中前置依赖。原本是 A → B → C 的请求链,改造后若变成 A ∥ B,再由 A → C,时间线应能直接体现并行部分。
控制请求数量比盲目提速更重要
当问题来自重复请求时,常见修复包括提升数据状态的单一来源、复用已经加载的数据、避免生命周期回调重复触发网络调用。这样不仅能缩短首屏时间,也能减少电量、流量和服务端压力。
最终验收应同时看三件事:独立请求是否真的并发、必要依赖是否保持正确顺序、同一业务资源是否还在被重复请求。只有这三项同时满足,才算真正消除了接口瀑布或请求风暴。