
服务注册与分布式协调 / 系统课时
采集成员延迟磁盘关键指标
采集成员延迟磁盘关键指标
本课建立一套能用于扩缩容前后对比的 ZooKeeper 健康采集面。重点不是堆满监控项,而是同时观察请求延迟、排队、连接、成员同步、磁盘空间和持久化延迟,并根据指标组合快速判断问题更像网络、磁盘还是成员同步异常。
学习目标
- 启用可采集的 ZooKeeper 指标入口,并用命令验证数据真实可读
- 建立延迟、未完成请求、连接、同步成员、磁盘与持久化延迟六类核心面板
- 根据多指标联动区分网络抖动、磁盘变慢和成员同步问题
建立可重复采集的指标入口
生产监控建议优先使用 ZooKeeper 的 Metrics Provider 暴露 Prometheus 指标,同时保留 mntr 作为故障现场的快速核对手段。若使用四字命令,需要显式允许 mntr,并限制管理端口的网络访问范围。
zoo.cfg 可以采用下面的配置:
4lw.commands.whitelist=ruok,mntr
metricsProvider.className=org.apache.zookeeper.metrics.prometheus.PrometheusMetricsProvider
metricsProvider.httpPort=7000
metricsProvider.exportJvmInfo=true这是配置片段,需滚动重启后生效。7000 只是示例端口,实际端口应按环境规划,并通过防火墙或安全组限制只允许监控系统访问。
重启单个成员后先验证 Metrics Provider:
curl -fsS http://127.0.0.1:7000/metrics | head预期输出为 Prometheus 文本格式,具体指标名会随 ZooKeeper 版本变化:
# HELP <METRIC_NAME> <DESCRIPTION>
# TYPE <METRIC_NAME> <TYPE>
<METRIC_NAME> <VALUE>
再用 mntr 做一次独立核对:
printf 'mntr' | nc -w 2 127.0.0.1 2181 | grep -E 'zk_(avg_latency|max_latency|outstanding_requests|num_alive_connections|server_state|synced_followers|pending_syncs)'预期结果至少能看到当前节点状态和请求类指标;Leader 通常还会出现同步 Follower 相关字段:
zk_avg_latency <VALUE>
zk_max_latency <VALUE>
zk_num_alive_connections <VALUE>
zk_outstanding_requests <VALUE>
zk_server_state <leader|follower|observer>
如果 mntr 返回“未在白名单”或直接断开,不要把它误判成 ZooKeeper 不健康,应先检查 4lw.commands.whitelist 和网络访问策略。
用六组指标构成最小健康面板
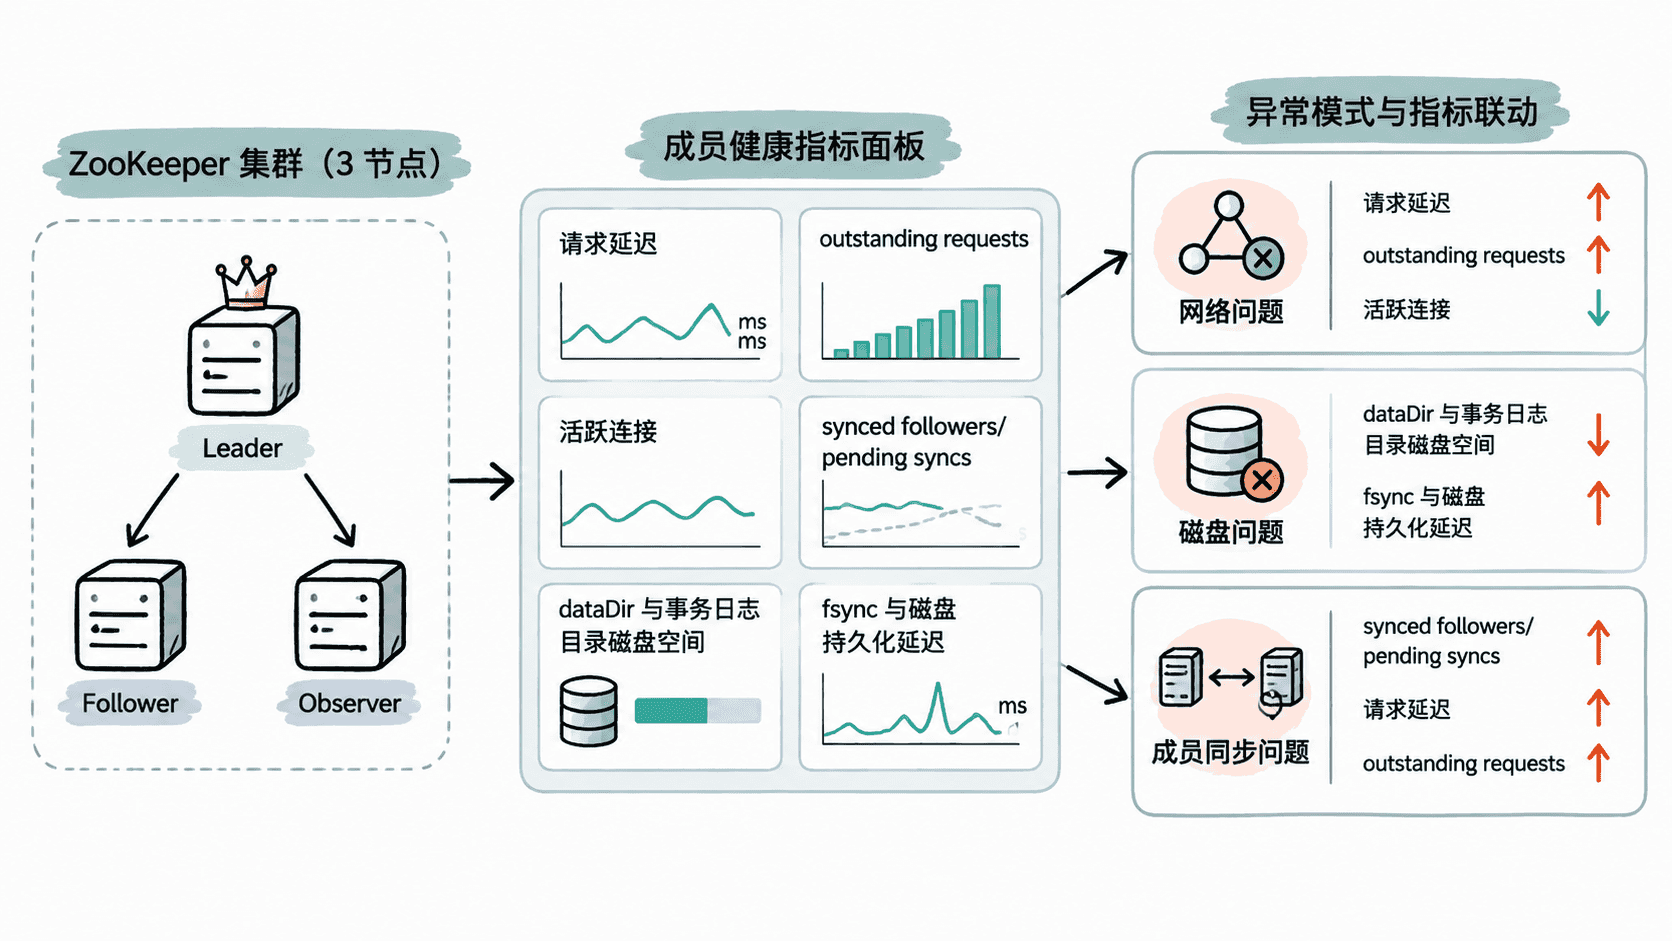
单个指标很容易误导。请求延迟升高既可能是磁盘,也可能是 Leader 到 Follower 的网络抖动;连接数下降既可能是业务流量减少,也可能是节点端口不可达。因此面板应按“请求、排队、连接、同步、容量、持久化”六组组织。
| 观察面 | 建议关注 | 主要用途 |
|---|---|---|
| 请求延迟 | 平均、最大以及监控后端可计算的 P95/P99 | 判断客户端体感是否恶化 |
| 排队压力 | outstanding requests | 判断请求是否在服务端积压 |
| 连接 | alive connections | 发现连接骤降、连接风暴或节点隔离 |
| 成员同步 | synced followers、pending syncs 等 Leader 侧指标 | 判断多数派成员是否跟得上 |
| 磁盘容量 | dataDir 与事务日志目录所在文件系统可用空间 |
防止快照或事务日志把磁盘写满 |
| 持久化延迟 | ZooKeeper 暴露的 fsync/持久化相关指标,辅以主机磁盘延迟 | 识别存储抖动对提交路径的影响 |
不同版本暴露的持久化指标名称并不完全相同,因此不要把某个名字硬编码成跨版本标准。升级后先查询 /metrics,再按 fsync、snapshot、commit、latency 等关键词核对实际指标并更新采集规则。
把磁盘容量和延迟绑定到实际目录
ZooKeeper 的 dataDir 与事务日志目录可能不在同一个文件系统。只监控根分区剩余空间并不可靠,应该直接检查这两个目录所在挂载点。
DATA_DIR='<PATH>'
LOG_DIR='<PATH>'
df -P "$DATA_DIR" "$LOG_DIR"
预期输出会包含两个目录对应文件系统的容量与可用空间,路径和数值因环境而异:
Filesystem 1024-blocks Used Available Capacity Mounted on
<DEVICE> <VALUE> <VALUE> <VALUE> <VALUE>% <MOUNT_POINT>
实际目录替换 <PATH>。如果两个目录位于同一挂载点,仍建议在监控配置中明确记录二者关系,避免迁移目录后监控对象悄悄失效。
持久化延迟不能只看“磁盘还有空间”。空间充足但 fsync 延迟突然升高,同样会把写请求拖慢并推高 outstanding requests。主机层还应补充磁盘 await、util 或等价存储延迟指标,用来判断是 ZooKeeper 自身负载上升还是底层存储变慢。
用指标组合定位问题方向
网络问题常见的组合是请求延迟和 outstanding requests 上升,同时 Leader 侧同步成员数量波动,而磁盘空间和主机存储延迟基本稳定。此时优先检查成员之间的丢包、RTT、连接重置和跨可用区链路。
磁盘问题更常表现为 fsync 或主机磁盘延迟上升,随后请求延迟与 outstanding requests 同步增加,但活跃连接数并不一定明显下降。若只有一个节点异常,重点检查该成员的数据盘、事务日志盘和宿主机 I/O 竞争。
成员同步问题则要重点看 Leader 侧 synced followers 与 pending syncs,并结合该成员的网络和磁盘指标判断原因。只看到“少了一个同步成员”还不能直接得出网络故障结论,因为慢盘同样会让 Follower 追不上 Leader。
为扩缩容保存前后基线
每次成员变更前保存一份 10~30 分钟的基线,变更后用相同窗口再采一份。至少比较请求延迟、outstanding requests、连接数、同步成员、磁盘可用空间和持久化延迟,且要按 Leader/Follower 角色分组。
TS=$(date +%Y%m%d-%H%M%S)
printf 'mntr' | nc -w 2 127.0.0.1 2181 > "mntr-$TS.txt"
df -P '<PATH>' > "disk-$TS.txt"
ls -1 "mntr-$TS.txt" "disk-$TS.txt"
预期输出:
disk-<TIME>.txt
mntr-<TIME>.txt
文件名中的时间会按实际执行时刻变化。把这类现场快照与监控平台的时间窗、变更单 ID 一起保存,就能在扩缩容后快速判断“指标变化来自正常角色切换,还是网络、磁盘或成员同步真的退化”。