
服务注册与分布式协调 / 系统课时
设计奇数投票成员与故障域
设计奇数投票成员与故障域
ZooKeeper 高可用不能只看“有几台机器”,还要看这些投票成员是否真正分散在独立故障域。本节从多数派门槛出发,把主机、机架和可用区故障逐层代入,最终得到一套可以在扩缩容前直接检查的拓扑设计方法。
学习目标
- 根据投票成员数量计算多数派门槛和可容忍故障数
- 判断单机、单机架或单可用区失效后是否仍保有多数派
- 识别“节点很多但故障域集中”的伪高可用拓扑
先从多数派门槛判断容量
ZooKeeper 的 Leader 选举和事务提交依赖投票成员形成多数派。若当前有 3 个投票成员,至少需要 2 票;5 个成员至少需要 3 票。失去多数派后,即使仍有服务器进程存活,集群也不能继续正常完成需要仲裁的工作。
因此生产集群通常优先选择 3、5、7 这类奇数投票成员。原因不是奇数具有特殊协议能力,而是偶数成员往往不能换来额外的故障容忍度:3 台和 4 台都只能容忍 1 个投票成员失效,5 台和 6 台都只能容忍 2 个。
| 投票成员数 | 多数派门槛 | 最多可同时失去的成员 |
|---|---|---|
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
把票数映射到真实故障域
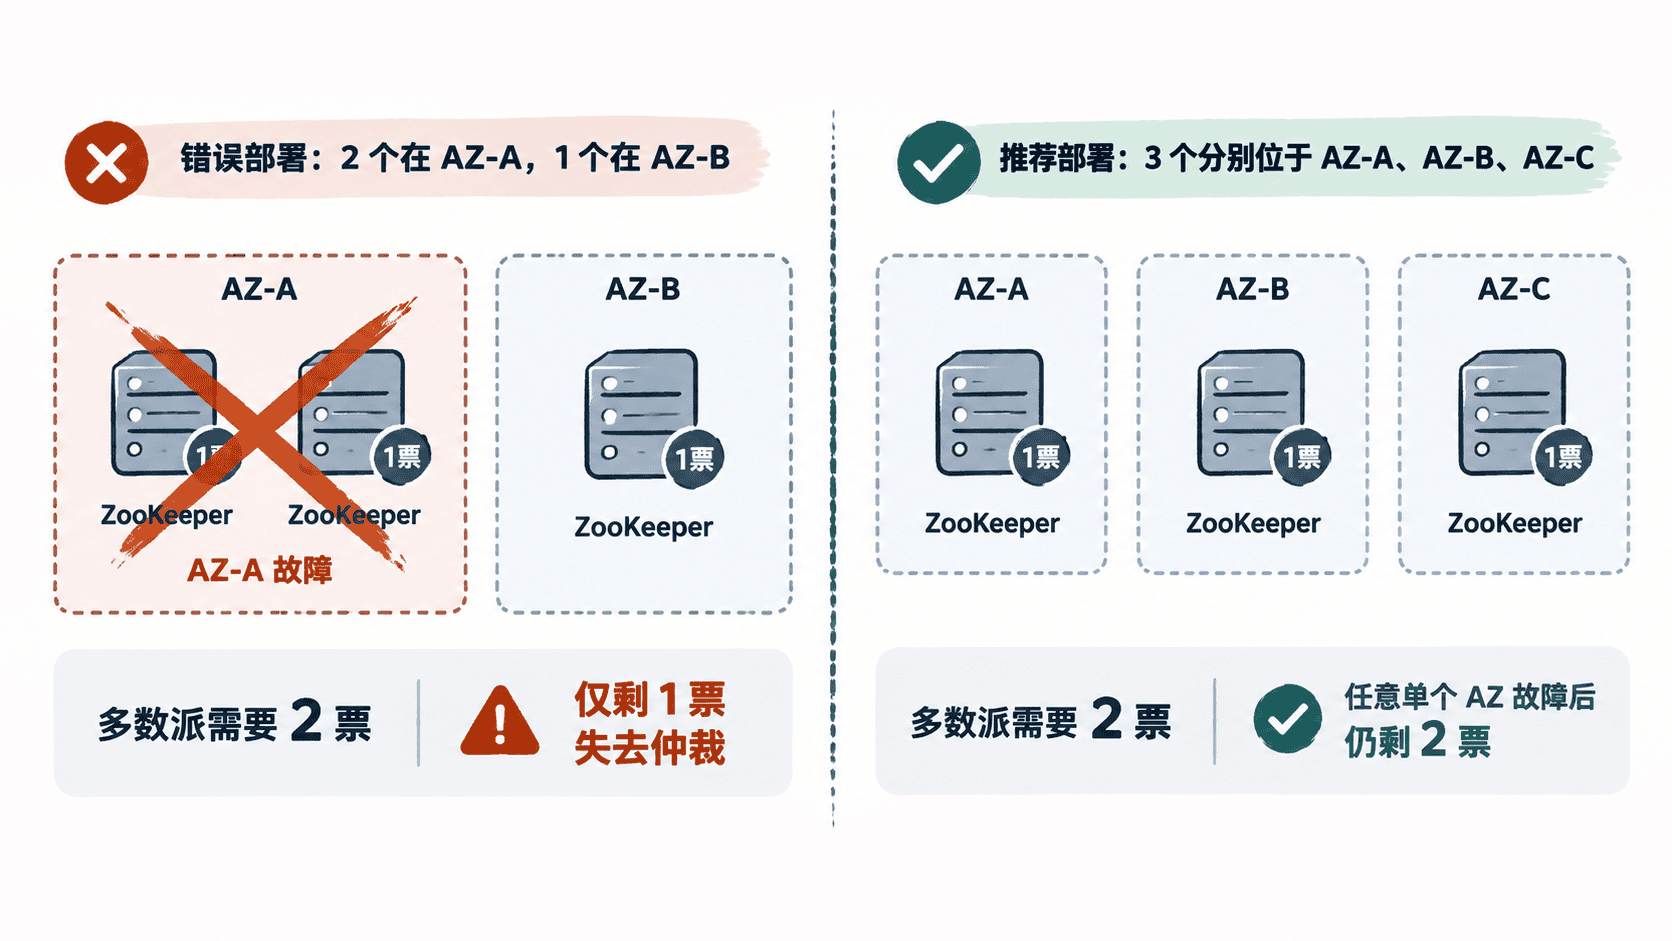
只计算节点数还不够。假设 3 个投票成员中有 2 个位于同一个可用区,另 1 个位于另一个可用区,那么“有 3 台 ZooKeeper”看似满足常见部署规模,但前一个可用区整体故障会一次丢掉 2 票,只剩 1 票,集群立即失去多数派。
更稳妥的 3 节点方案是把三个投票成员分别放入三个独立可用区;如果只能使用一个可用区,也至少应尽量跨物理机、机架、电源域和网络设备放置。设计时必须以实际能同时失效的基础设施单元作为故障域,而不是只看云主机数量。
对于 5 个投票成员,如果分布为 2、2、1 跨三个可用区,那么任意一个可用区失效后至少还剩 3 票,仍能达到多数派门槛。此时增加成员确实换来了更强的故障容忍能力,而不是单纯增加服务器数量。
用脚本检查故障后剩余票数
扩缩容方案评审时,可以把每个投票成员所属故障域写进一个小脚本,自动枚举“整个故障域失效”后的剩余票数。下面的示例同时检查 3 节点跨三区和 5 节点按 2、2、1 分布的情况。
from collections import Counter


def check_layout(voters: dict[str, str]) -> None:
    total = len(voters)
    quorum = total // 2 + 1
    domain_counts = Counter(voters.values())

    print(f"voters={total}, quorum={quorum}")
    for domain, failed_votes in sorted(domain_counts.items()):
        remaining = total - failed_votes
        status = "AVAILABLE" if remaining >= quorum else "UNAVAILABLE"
        print(f"fail {domain}: remaining={remaining}, {status}")


layouts = {
    "three-az": {
        "zk-1": "az-a",
        "zk-2": "az-b",
        "zk-3": "az-c",
    },
    "five-voters": {
        "zk-1": "az-a",
        "zk-2": "az-a",
        "zk-3": "az-b",
        "zk-4": "az-b",
        "zk-5": "az-c",
    },
}

for name, voters in layouts.items():
    print(f"[{name}]")
    check_layout(voters)
预期输出:
[three-az]
voters=3, quorum=2
fail az-a: remaining=2, AVAILABLE
fail az-b: remaining=2, AVAILABLE
fail az-c: remaining=2, AVAILABLE
[five-voters]
voters=5, quorum=3
fail az-a: remaining=3, AVAILABLE
fail az-b: remaining=3, AVAILABLE
fail az-c: remaining=4, AVAILABLE
实际评审时可以把 az-a 替换成机架、电源域或其他真实故障域名称,再分别运行一次。关键不是脚本本身,而是把“一个故障事件会同时拿走多少票”量化出来。
扩缩容前检查最坏情况
设计投票拓扑时,应先确定需要承受的最大单点故障,再倒推节点分布。若目标是承受任意一个可用区整体失效,就必须保证任何可用区被移除后,剩余投票成员仍达到当前多数派门槛。
特别要警惕把新增节点继续堆到已有故障域。比如从 3 节点扩到 5 节点,如果新增的两台都落到同一个已有可用区,节点数虽然增加了,但某些可用区故障仍可能一次带走多数票。扩容真正完成的标志,应是故障后的剩余票数变得更安全,而不是服务器列表变长。
最终可以把每次集群变更都归结为一个问题:删掉任意一个计划内故障域后,还剩多少投票成员?只要答案仍达到多数派,并且这个检查覆盖了主机、机架和可用区三个层次,ZooKeeper 的仲裁高可用才算从拓扑上成立。