
服务注册与分布式协调 / 系统课时
按故障域重新分布投票成员
按故障域重新分布投票成员
ZooKeeper 有 3 台或 5 台投票服务器,并不自动等于高可用。如果多数 participant 落在同一主机、机架或可用区,一次故障域中断就可能直接夺走 quorum。本节把成员映射到故障域,再通过逐节点迁移修正这种“节点很多、仲裁却很集中”的拓扑。
学习目标
- 把 participant 映射到主机、机架和可用区,识别多数派集中风险
- 设计逐节点迁移顺序,使每一步都保留可用 quorum
- 在成员变更前后验证跨故障域网络质量、投票成员数和仲裁余量
先找出伪高可用拓扑
判断 ZooKeeper 拓扑时,首先只统计 participant。Observer 可以提升读扩展能力,但不能帮助集群形成多数派。以 5 个 participant 为例,如果其中 3 台都在 AZ-A,另外两台分别位于 AZ-B、AZ-C,那么 AZ-A 整体故障会让集群只剩 2 票,无法达到 3 票多数派。
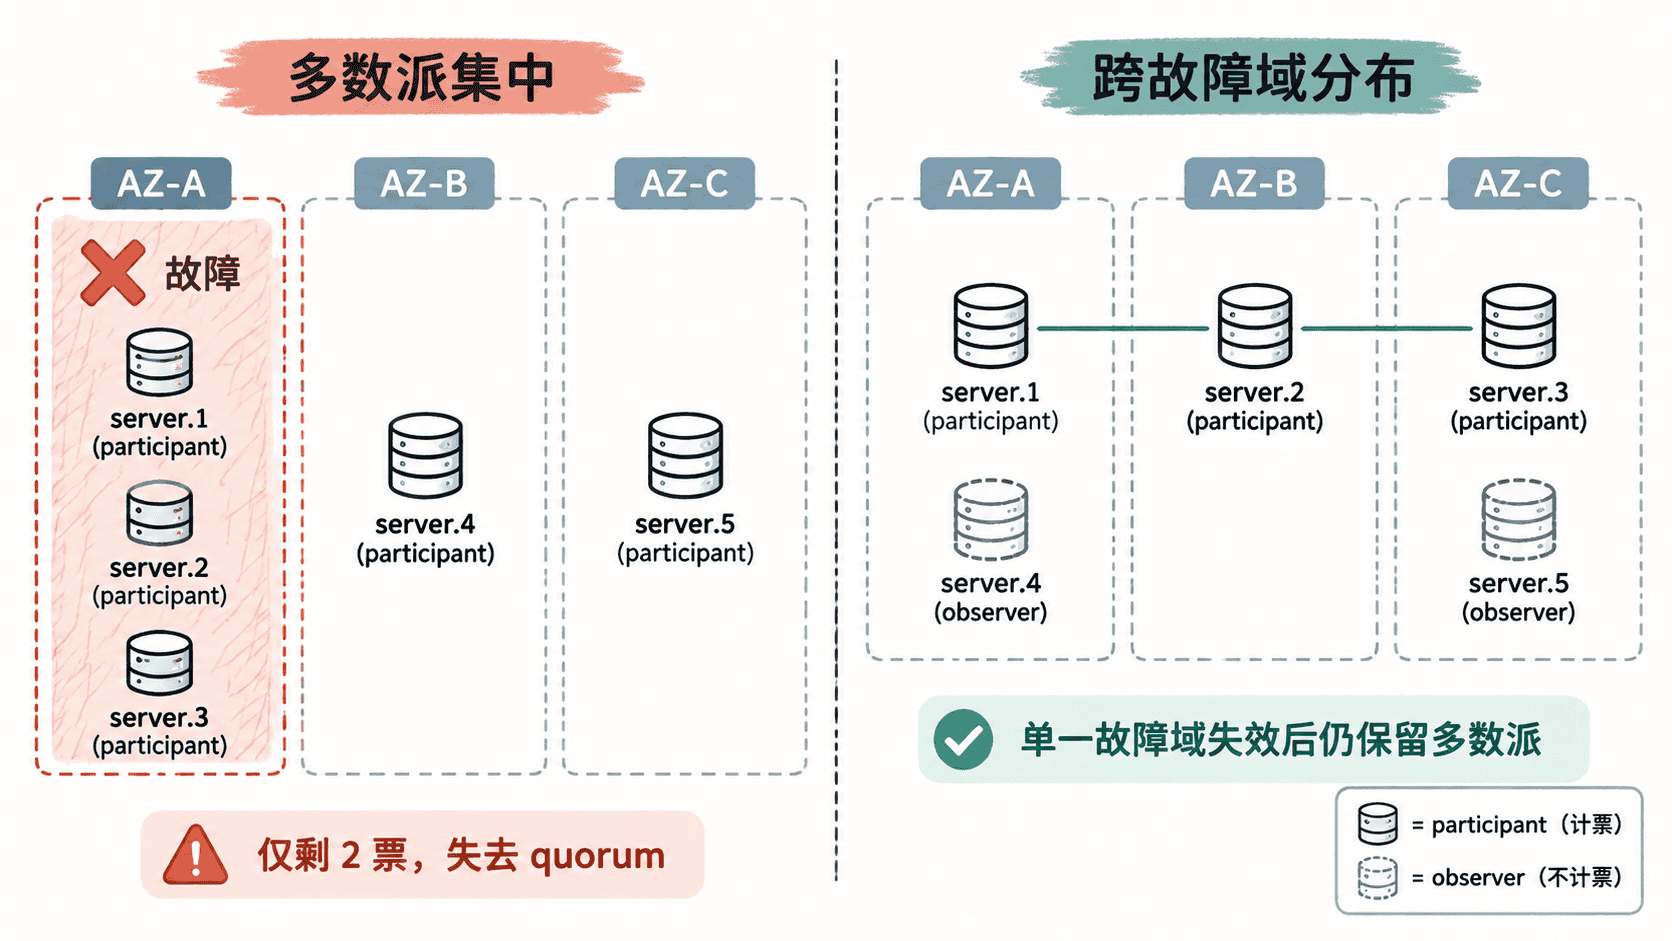
故障域要按真实基础设施定义,而不是只看 IP 是否不同。两台虚拟机可能运行在同一物理宿主机,两台不同宿主机也可能共享同一机架电源;跨机架部署如果全部位于同一可用区,仍然无法抵御可用区级故障。
可以先建立一份简单清单,把 ZooKeeper 成员与基础设施信息对应起来:
server_id,role,host,rack,az
1,participant,zk1,rack-a1,az-a
2,participant,zk2,rack-a2,az-a
3,participant,zk3,rack-a3,az-a
4,participant,zk4,rack-b1,az-b
5,participant,zk5,rack-c1,az-c
这份数据结构不直接提交给 ZooKeeper;它用于变更评审。上例中 AZ-A 拥有 3 张票,已经达到整个 5 节点集群的多数派,因此属于需要修正的集中风险。
用仲裁条件决定迁移顺序
迁移不能一次停掉多台旧节点。安全原则是:任何一步开始前,都先确认当前 participant 集合健康;新位置节点完成同步并进入预期角色后,才处理下一台。对于 5 个投票成员,多数派为 3,因此变更过程中至少要始终保留 3 个能够互相通信并正常投票的 participant。
一种常见方案是先在目标故障域准备新实例,例如把位于 AZ-A 的 server.3 迁移到 AZ-C。若采用新 server ID,可以先把新节点加入为 participant,确认其完成同步,再删除旧节点;若组织要求复用原 server ID,则应按照 ZooKeeper 动态重配置和本地 myid 管理规则规划停机窗口,避免两个实例同时以相同 ID 出现在集群中。
变更前先验证跨域通信质量
把投票成员分散到更多可用区会提高故障隔离能力,但 ZooKeeper 的事务提交需要投票成员之间持续通信。迁移前至少检查新节点到现有投票成员的对等通信路径和延迟,不能只验证客户端端口 2181。
下面示例检查新节点到两个现有成员的 quorum 通信端口;端口以实际动态配置为准。
for target in zk1.example.com:2888 zk4.example.com:2888; do
  host=${target%:*}
  port=${target#*:}
  echo "checking ${host}:${port}"
  nc -zvw 3 "$host" "$port"
done
预期结果是在两个目标端口都建立 TCP 连接,实际地址和耗时可能不同。
checking zk1.example.com:2888
Connection to zk1.example.com 2888 port [tcp/*] succeeded!
checking zk4.example.com:2888
Connection to zk4.example.com 2888 port [tcp/*] succeeded!
仅仅“端口能通”还不够。跨可用区 RTT 明显升高时,应同时观察 ZooKeeper 请求延迟、事务提交延迟、同步状态和网络抖动;如果网络质量不足,盲目追求地域分散反而可能把稳定性问题带入仲裁路径。
每次只提交一个可验证的拓扑变化
假设已经准备好位于 AZ-C 的 zk6,目标是用它替代集中在 AZ-A 的一个投票成员。先读取当前 config 和配置版本,再提交只包含这一步变化的目标成员集合。以下命令为 CLI 片段示例,依赖已经连接到健康 ZooKeeper 集群。
reconfig -members "server.1=zk1.example.com:2888:3888:participant;2181,server.2=zk2.example.com:2888:3888:participant;2181,server.4=zk4.example.com:2888:3888:participant;2181,server.5=zk5.example.com:2888:3888:participant;2181,server.6=zk6.example.com:2888:3888:participant;2181" -v <ID>预期结果是新的动态配置仅包含目标 5 个投票成员,并返回新的配置版本;实际版本值不同。
server.1=zk1.example.com:2888:3888:participant;2181
server.2=zk2.example.com:2888:3888:participant;2181
server.4=zk4.example.com:2888:3888:participant;2181
server.5=zk5.example.com:2888:3888:participant;2181
server.6=zk6.example.com:2888:3888:participant;2181
version=<ID>
生产变更不要连续提交多个迁移后再统一检查。每移动一个 participant,都重新读取 config,确认新成员角色和版本正确,再检查集群是否仍有唯一 Leader、其余投票成员是否处于正常 follower 状态,最后观察一段业务请求和事务提交指标后再进行下一步。
用故障域而不是节点数验收结果
迁移完成后,应重新制作成员到故障域的映射,并主动问一个问题:任意一个计划防护的故障域整体消失后,剩余 participant 是否还能形成多数派? 这比“集群现在有 5 台机器”更有意义。
对于 5 个 participant,多数派固定为 3。如果某个单一故障域仍承载 3 个或更多投票成员,那么该故障域依旧拥有一次性摧毁 quorum 的能力;继续分散成员,或者重新评估希望抵御的故障模型。对于只有 3 个 participant 的集群,理想情况通常是三者处于三个相互独立的故障域,因为任何一个故障域失效后仍能留下 2 票多数派。
最终验收应同时满足拓扑和运行状态两个条件:投票多数派不再集中于单一目标故障域,并且新的跨域链路没有把延迟、丢包或同步异常提高到不可接受的水平。只有这两项同时成立,重新分布才真正提升了 ZooKeeper 的高可用能力。