
服务注册与分布式协调 / 系统课时
演练Leader切换与单节点失联
演练Leader切换与单节点失联
本节用一次可控故障演练验证三节点 ZooKeeper 在 Leader 宕机和普通 Follower 失联时的真实行为,重点记录选举窗口、客户端重连、会话是否过期,以及恢复节点何时重新追上集群,而不是只看进程是否重新启动。
学习目标
- 区分 Leader 故障与 Follower 故障对仲裁和客户端的影响
- 用可重复步骤记录选举、重连和会话状态
- 用故障期间写入的标记验证恢复节点已经追平
建立演练基线
演练前先确认三台成员都在线,并记下当前 Leader。三节点集群允许失去一个投票成员,但如果同时再失去一个成员,就会失去多数派,因此整场演练必须一次只处理一个节点。
export ZK_HOME=/opt/zookeeper
for host in zk1 zk2 zk3; do
  printf '%s: ' "$host"
  ssh "$host" "$ZK_HOME/bin/zkServer.sh status" | grep 'Mode:'
done
预期结果
三台均能返回状态;其中 1 台为 Mode: leader,另外 2 台为 Mode: follower。
具体哪台是 Leader 以现场结果为准。
同时打开一个长连接客户端,连接串必须包含多个成员。故障发生时重点观察 Disconnected、重新 SyncConnected 和 Expired:短暂断连后恢复连接不等于会话已经失效,只有出现会话过期才需要按新会话处理临时节点和 Watch。
"$ZK_HOME/bin/zkCli.sh" -server zk1:2181,zk2:2181,zk3:2181预期结果
客户端进入 CONNECTED 状态;故障切换期间可能短暂断开,随后在会话超时前重新连接到存活成员。
实际连接日志和目标成员会随环境变化。
主动停止Leader
先按基线结果把 LEADER_HOST 改成当前 Leader,再停止该节点。记录从客户端首次感知断连到重新可读写的时间,并在新 Leader 产生后写入一个唯一标记,供旧 Leader 恢复后验证追平。
LEADER_HOST=zk1
ssh "$LEADER_HOST" "$ZK_HOME/bin/zkServer.sh stop"

for host in zk2 zk3; do
  ssh "$host" "$ZK_HOME/bin/zkServer.sh status" | grep 'Mode:'
done

"$ZK_HOME/bin/zkCli.sh" -server zk2:2181,zk3:2181 <<'EOF'
create /ha-drill-marker-001 leader-failover-ok
get /ha-drill-marker-001
EOF
预期结果
两个存活成员重新形成多数派,其中一个成为 Leader,另一个保持 Follower。
创建标记成功,并能读到 leader-failover-ok。
实际被选为 Leader 的节点不固定。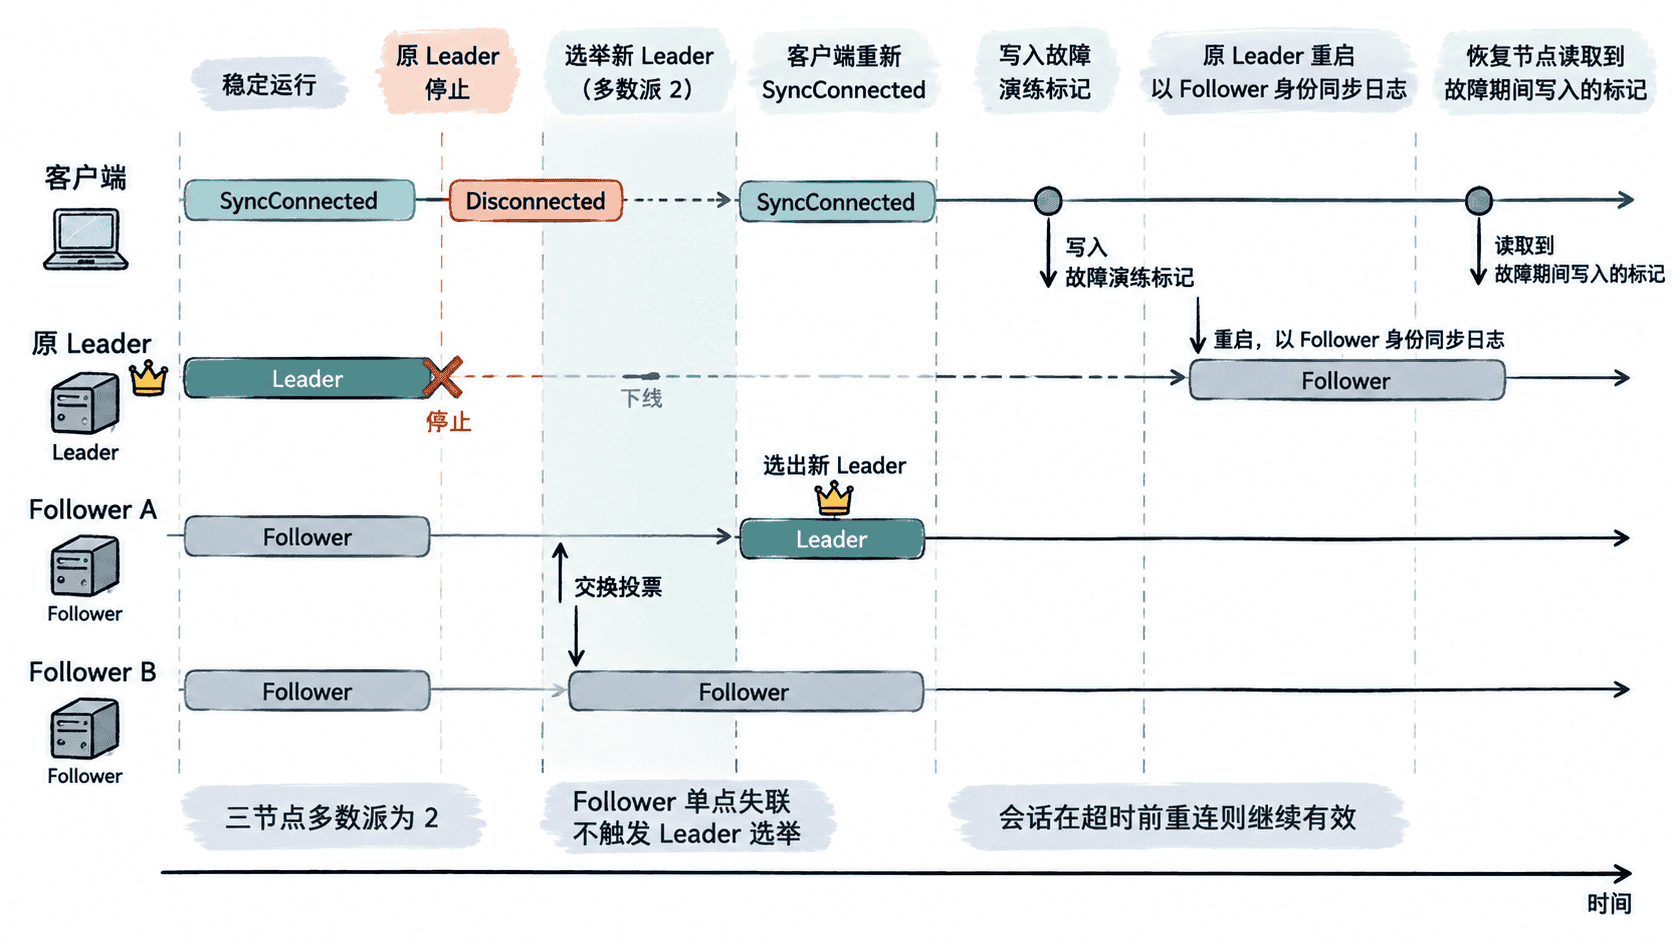
Leader 故障的关键指标不是“服务有没有报错”,而是不可写窗口和客户端恢复时间是否落在预先定义的 SLO 内。若重连时间接近业务使用的会话超时,应优先排查网络、选举通信和磁盘停顿,而不是简单调大超时掩盖问题。
演练普通Follower失联
先恢复原 Leader,等它重新进入稳定角色后,再挑选当前任意一个 Follower 停止。只要另外两名投票成员仍在线,集群仍有多数派,不应发生 Leader 切换;只有连接在该 Follower 上的客户端需要迁移连接。
LEADER_HOST=zk1
ssh "$LEADER_HOST" "$ZK_HOME/bin/zkServer.sh start"
sleep 5

FOLLOWER_HOST=zk3
ssh "$FOLLOWER_HOST" "$ZK_HOME/bin/zkServer.sh stop"

for host in zk1 zk2; do
  ssh "$host" "$ZK_HOME/bin/zkServer.sh status" | grep 'Mode:'
done
预期结果
存活的两台节点仍保持 1 个 Leader 和 1 个 Follower。
Leader 不应因为普通 Follower 单点失联而重新选举。
连接到失联节点的客户端会改连其他成员。
如果此时业务仍出现全局不可用,通常说明客户端只配置了单地址、连接串失效,或故障同时波及了第二个投票成员。演练应把这些问题与 ZooKeeper 自身的仲裁能力分开记录。
恢复成员并验证追平
重新启动故障节点后,不要把“进程已启动”当成恢复完成。恢复成员应先完成与当前 Leader 的状态同步,再稳定成为 Follower;最直接的验收方式,是让它单独读取故障期间产生的标记。
FOLLOWER_HOST=zk3
ssh "$FOLLOWER_HOST" "$ZK_HOME/bin/zkServer.sh start"
sleep 5

"$ZK_HOME/bin/zkCli.sh" -server "${FOLLOWER_HOST}:2181" <<'EOF'
get /ha-drill-marker-001
delete /ha-drill-marker-001
EOF
预期结果
从恢复节点直接读取到 leader-failover-ok。
这证明该节点至少已经同步到故障期间写入该标记的事务位置;随后清理演练标记。
最终验收应同时满足:三台成员角色稳定、任意单节点失联仍保留多数派、客户端能在会话超时前重连、Leader 故障窗口符合 SLO,并且恢复节点能够读取故障期间产生的数据。只有这些条件都通过,故障演练才算验证了集群的高可用闭环。