
音频开发 / 系统课时
定位解码失败与采样率问题
定位解码失败与采样率问题
当 decodeAudioData() 报错,或解码后出现时长、频率异常时,关键是先分清下载、文件、编解码兼容性和采样率问题。本节建立一条固定排查链,并用 AudioBuffer 的实际属性验证修复结果。
学习目标
- 按固定顺序区分下载失败、数据损坏、格式不支持和解码异常
- 理解
decodeAudioData()与AudioContext.sampleRate的关系 - 用最小诊断代码记录可比较的字节数、采样率、声道数和时长
先判断失败发生在哪一层
解码问题最容易被误判,是因为同一个“播不出来”可能来自完全不同的层。建议按“取数 → 完整文件 → 解码 → 采样率与后续处理”顺序检查,避免一上来就换编码器或改 DSP 代码。
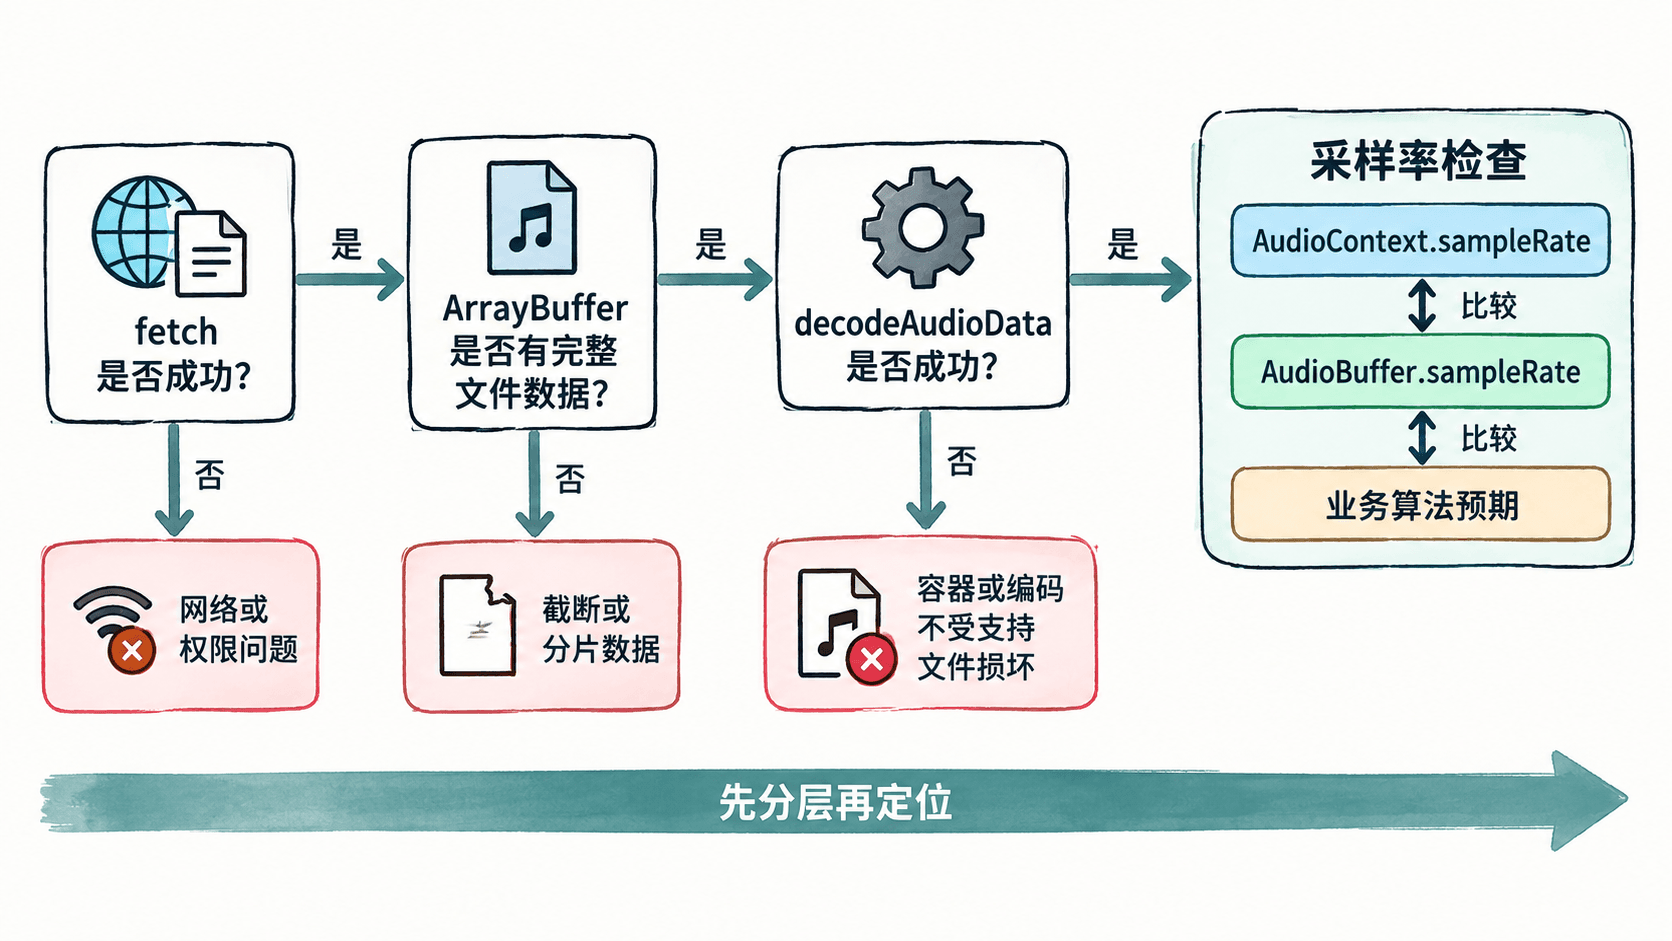
decodeAudioData() 需要完整的音频文件数据。把流媒体的一小段分片、只包含部分容器头的数据或被截断的响应直接交给它,即使 MIME 看起来正确,也可能失败。反过来,HTTP 请求成功也只能证明拿到了响应,不能证明响应内容就是可解码音频。
用最小诊断代码确认事实
下面示例可直接放进支持 Web Audio API 的浏览器控制台执行。把 <PATH> 替换为同源或已正确配置 CORS 的完整音频文件 URL;实际字节数、声道数和采样率会因文件和设备而不同。
const context = new AudioContext();

async function inspectAudio(url) {
  const response = await fetch(url);
  // 先排除 HTTP 层问题,避免把错误响应误判为音频解码失败。
  if (!response.ok) {
    throw new Error(`HTTP ${response.status}`);
  }

  const bytes = await response.arrayBuffer();
  console.log("byteLength:", bytes.byteLength);
  console.log("contextSampleRate:", context.sampleRate);

  try {
    // 解码结果会按当前 AudioContext 的采样率表示。
    const buffer = await context.decodeAudioData(bytes);
    console.log("decodedSampleRate:", buffer.sampleRate);
    console.log("channels:", buffer.numberOfChannels);
    console.log("frames:", buffer.length);
    console.log("duration:", buffer.duration.toFixed(3));
  } catch (error) {
    console.error("decode failed:", error.name, error.message);
  }
}

await inspectAudio("<PATH>");
预期输出(成功路径,实际值可能不同)
byteLength: <BYTES>
contextSampleRate: <SAMPLE_RATE>
decodedSampleRate: <SAMPLE_RATE>
channels: <CHANNELS>
frames: <FRAMES>
duration: <TIME>
如果只看到 decode failed: <ERROR_NAME> <MESSAGE>,先记录错误名称和文件来源,不要依赖错误文本做业务分支;不同浏览器的错误消息并不适合作为稳定协议。
处理格式不支持与损坏数据
如果请求成功但解码失败,优先确认“文件本身是否完整且浏览器能解码”,而不是继续修改 Web Audio 图。可按下面顺序缩小范围:
- 用浏览器直接打开同一 URL,确认返回的不是登录页、错误页或代理生成的文本。
- 比较服务端声明的文件大小与
byteLength,排除截断、空响应和错误缓存。 - 确认传入的是完整文件,而不是 MSE、HLS、DASH 或自定义分片中的单个媒体片段。
- 用已知可播放的文件替换输入做对照。如果对照文件能解码,问题更可能在原文件的容器、编码参数或数据完整性。
- 同一文件在不同浏览器表现不一致时,再检查目标浏览器对该容器与编解码组合的支持范围。
采样率不一致为什么不一定是错误
AudioContext.sampleRate 定义了这个音频上下文的处理采样率,同一上下文中的节点按这一采样率工作。decodeAudioData() 解码后会把数据转换到该上下文的采样率,因此 AudioBuffer.sampleRate 通常会与 context.sampleRate 一致;它不应被当作“原始文件采样率探测器”。
这会带来两个常见误区。第一,算法如果把“每 480 帧就是 10 ms”写死,却运行在 44.1 kHz 上,窗口时长就会偏离。第二,解码后的 buffer.length 是目标采样率下的帧数,不能直接与源文件编码帧数比较。
需要固定时间窗口时,应由采样率换算帧数,例如 20 ms 窗口可按 Math.round(context.sampleRate * 0.02) 计算,而不是写死常量。若业务必须知道源文件的原始采样率,应在进入 Web Audio 前读取媒体元数据,不能只依赖解码后的 AudioBuffer。
修复后怎么验证
修复完成后至少验证三件事:同一文件能稳定完成解码;buffer.duration 与可感知时长一致;所有依赖帧数的算法都基于实际 sampleRate 计算。若问题只在某个输入文件复现,就继续追文件完整性和编码兼容性;若所有文件都能解码但处理结果仍异常,排查重点应转向后续 DSP 对采样率、声道数和帧长度的假设。