
音频开发 / 系统课时
获取音频文件并解码成 AudioBuffer
获取音频文件并解码成 AudioBuffer
本节解决“浏览器拿到音频文件后,怎样把压缩或封装后的二进制数据变成可处理的 PCM 缓冲区”这个问题。你会完成从 fetch 下载、读取 ArrayBuffer 到 decodeAudioData() 解码的完整链路,并能读取采样率、声道数、帧数与时长。
学习目标
- 使用
fetch()和arrayBuffer()获取可供解码的音频二进制数据。 - 使用
AudioContext.decodeAudioData()得到AudioBuffer,并读取关键属性。 - 理解
AudioBuffer中“声道、采样帧、采样率、时长”之间的关系。
从文件字节到 AudioBuffer
网络返回的音频文件首先是编码后的字节。response.arrayBuffer() 只负责把响应体读进内存,并没有把 MP3、AAC、WAV 等内容转换成可直接处理的采样数据。真正的解码由 AudioContext.decodeAudioData() 完成,它会根据浏览器支持的音频格式生成一个 AudioBuffer。
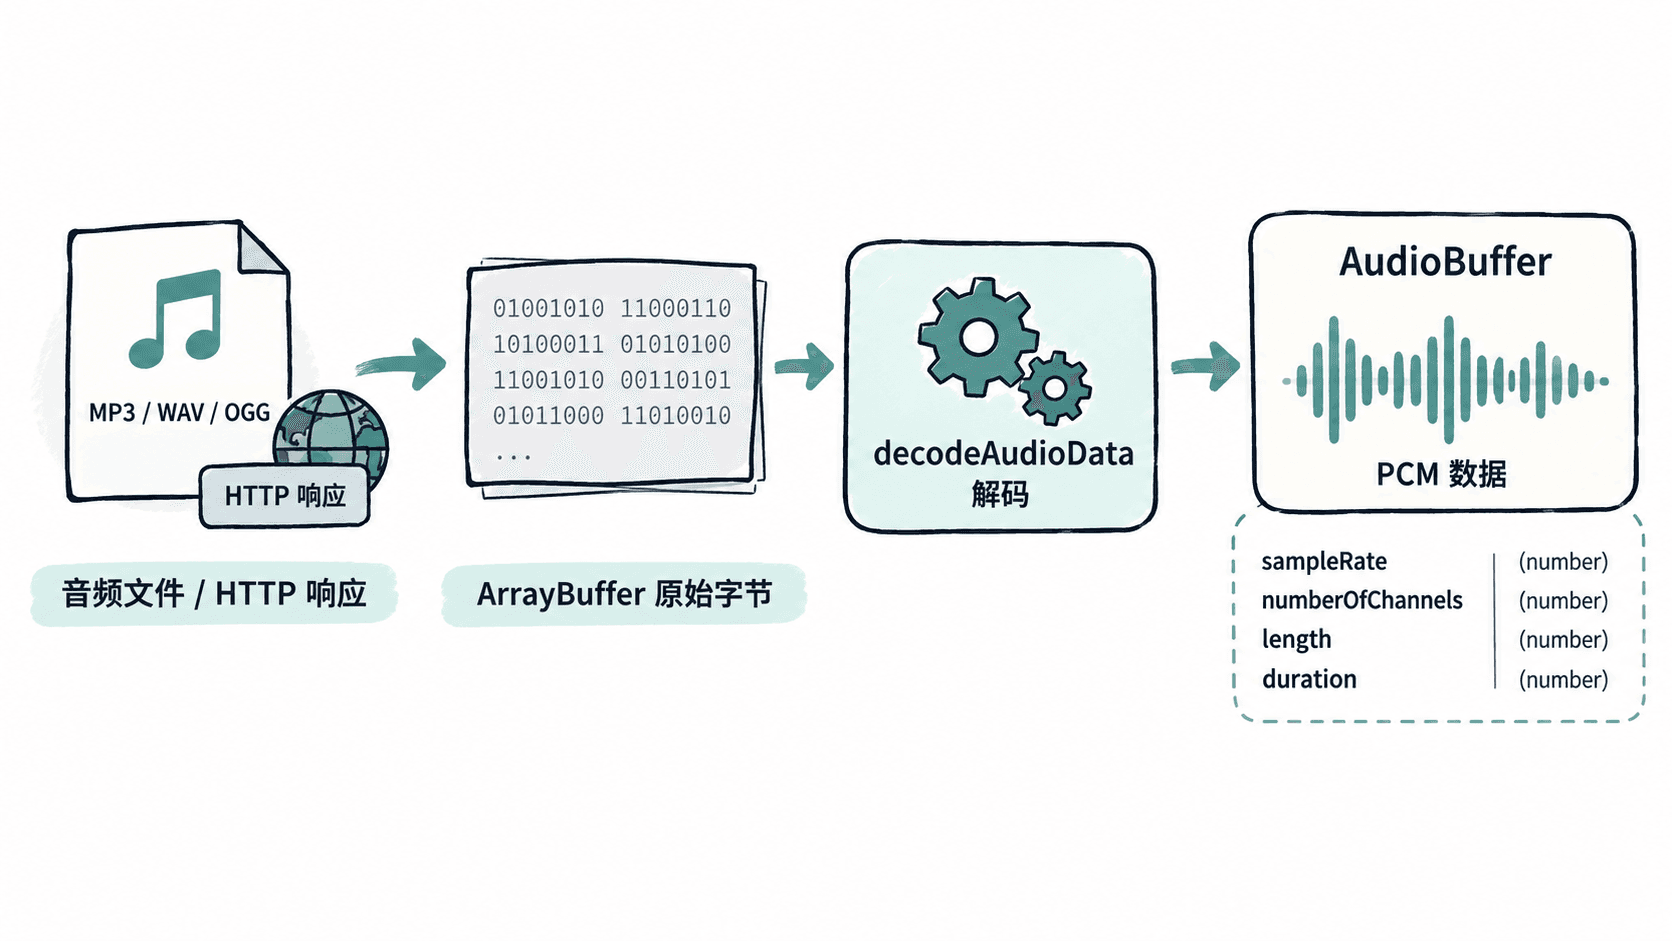
decodeAudioData() 返回 Promise,因此最直接的写法是配合 await。解码可能因为格式不受支持、文件损坏、网络返回的并非音频内容等原因失败,所以下载状态和解码异常都应分别处理。
完成一次下载与解码
下面的页面会加载同目录下的 demo.wav,解码成功后打印 AudioBuffer 的核心信息。把一个可访问的音频文件放在页面同目录,并通过本地 HTTP 服务器打开页面,而不是直接双击本地文件。
<!doctype html>
<html lang="zh-CN">
<head>
  <meta charset="utf-8">
  <title>Decode AudioBuffer</title>
</head>
<body>
  <button id="load">加载并解码</button>
  <script>
    const audioContext = new AudioContext();

    async function loadAudioBuffer(url) {
      const response = await fetch(url);
      if (!response.ok) {
        throw new Error(`HTTP ${response.status}`);
      }

      // arrayBuffer() 得到的仍是文件字节,decodeAudioData() 才会生成 PCM 缓冲区。
      const fileBytes = await response.arrayBuffer();
      return await audioContext.decodeAudioData(fileBytes);
    }

    document.querySelector("#load").addEventListener("click", async () => {
      try {
        const buffer = await loadAudioBuffer("./demo.wav");
        console.log("AudioBuffer ready");
        console.log(`sampleRate=${buffer.sampleRate}`);
        console.log(`channels=${buffer.numberOfChannels}`);
        console.log(`frames=${buffer.length}`);
        console.log(`duration=${buffer.duration.toFixed(3)}`);
      } catch (error) {
        console.error("decode failed:", error.message);
      }
    });
  </script>
</body>
</html>
预期输出
AudioBuffer ready
sampleRate=<RATE>
channels=<COUNT>
frames=<FRAMES>
duration=<TIME><RATE>、<COUNT>、<FRAMES> 和 <TIME> 取决于实际音频文件。只要能看到 AudioBuffer ready 且这些值为有效数值,就说明下载与解码链路已经成功。
读懂 AudioBuffer 的采样信息
sampleRate 表示每个声道每秒包含多少个采样帧,例如 48000 表示每秒 48000 帧。length 是每个声道的采样帧数,而不是“所有声道采样点相加后的总数”。因此 duration 约等于 length 除以 sampleRate,浏览器也直接通过 duration 给出秒数。
numberOfChannels 表示声道数。使用 getChannelData(channelIndex) 可以取得某个声道的 Float32Array,索引从 0 开始。数组里的值是浮点 PCM 采样,常见音频通常落在约 -1 到 1 之间,但业务代码不应依赖它一定被严格钳制在这个区间。
常见失败从哪里查
如果 fetch() 失败,先检查 URL、HTTP 状态码和跨域策略;如果下载成功但 decodeAudioData() 失败,再检查文件本身是否完整,以及当前浏览器是否支持该文件的容器与编码组合。不要把“能下载”误认为“能解码”,这两步解决的是不同问题。
开发时还可以检查响应的 Content-Type,但它只能作为线索,不能替代真实解码验证。最终判断标准是 decodeAudioData() 是否成功返回 AudioBuffer,以及它的采样率、声道数、帧数和时长是否与源文件预期一致。