
Web 图形与 3D / 系统课时
排查构建后 404 与 CORS 错误
排查构建后 404 与 CORS 错误
模型在开发环境可以加载,部署后却出现 404、Failed to fetch 或 CORS 报错。先用浏览器确认失败的实际请求地址、HTTP 响应与资源内容,再分别修正发布路径或跨域响应头,最后通过线上构建产物和模型显示结果验收。
学习目标
- 利用 Network 和 Console 区分资源 404、错误的 HTML 回退与 CORS 拦截。
- 修复 Vite 子路径部署及 glTF 外部依赖的资源定位。
- 检查跨域授权并验证模型在正式环境中加载成功。
从失败请求判断根因
- 打开已部署页面,按
F12进入开发者工具,在 Network 勾选 Disable cache,刷新页面;在筛选栏查找.glb、.gltf、.bin、纹理文件或解码器文件。 - 点击失败请求,记录 Request URL、Status Code、Response Headers 和 Response;同时查看 Console 是否提示
Access-Control-Allow-Origin。 - 检查请求是否发往预期域名及部署前缀,不要只看控制台里最后一个
GLTFLoader异常。
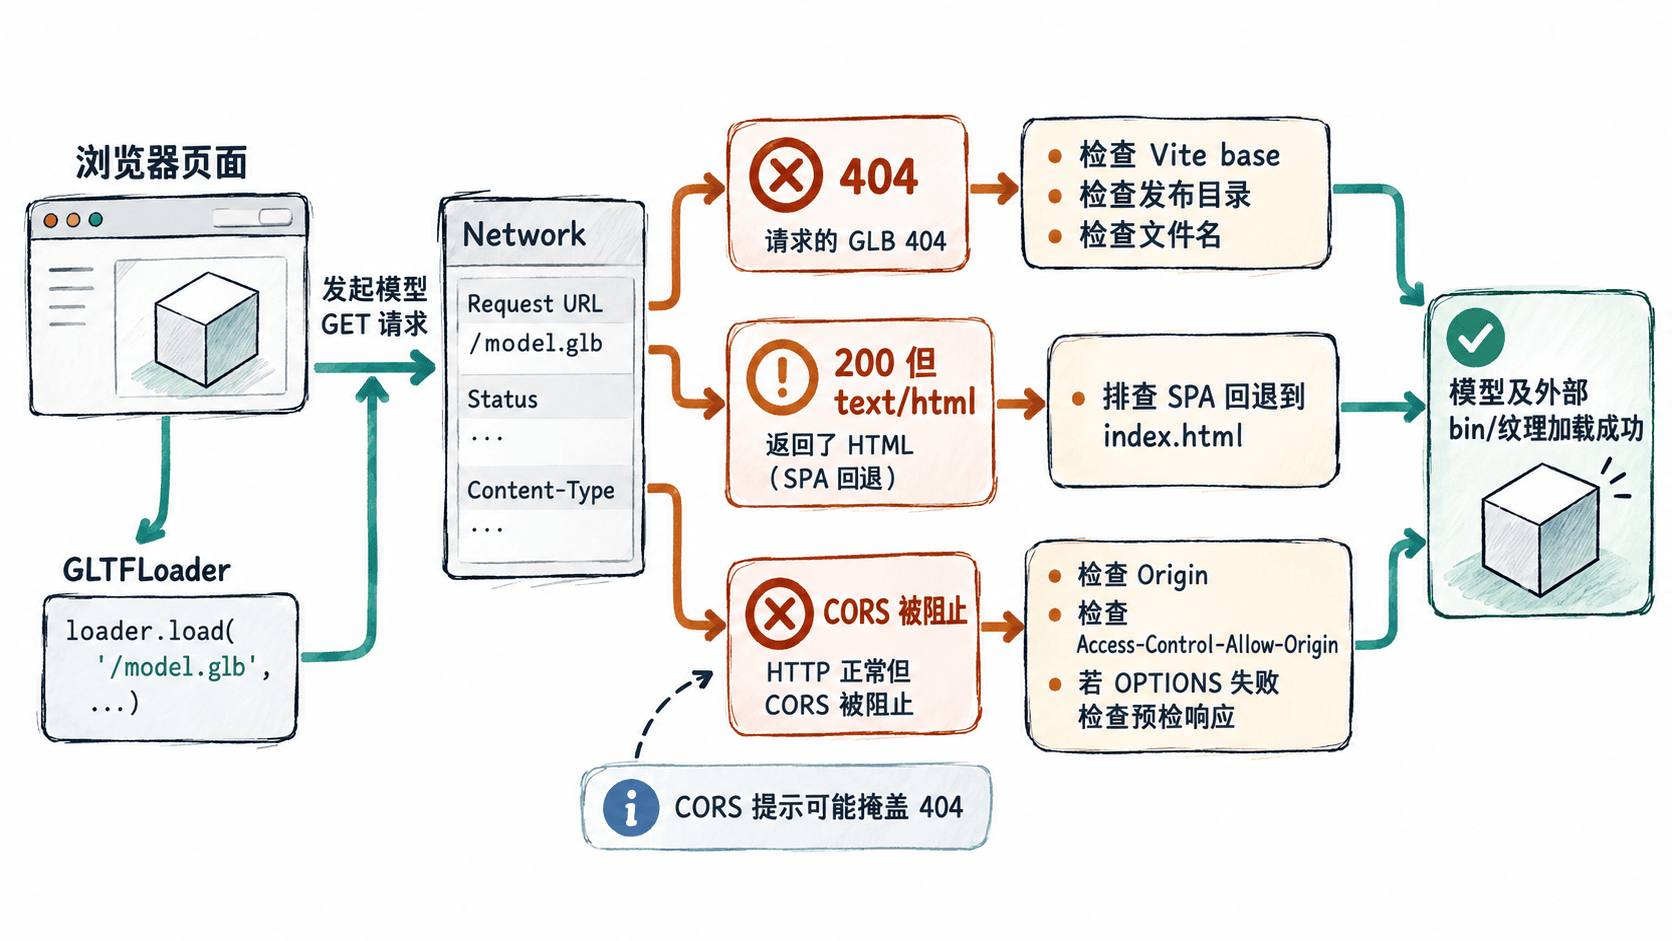
| 现象 | 优先检查 |
|---|---|
404 Not Found |
文件是否实际部署、URL 前缀和大小写是否匹配 |
200 OK,响应为 text/html |
静态资源请求是否误入 SPA 的 index.html 回退 |
| 请求显示成功但 Console 报 CORS | 请求的 Origin 是否被资源服务器的响应头允许 |
OPTIONS 失败 |
是否使用了非简单请求头,以及服务器是否正确处理预检 |
同一次故障可能同时出现 404 和 CORS:例如资源返回 404,错误页又未附带跨域头。应先查清原始 URL 和服务器响应,再修正授权。
在 Console 复现实际请求
在浏览器 Console 直接运行下面的完整脚本,把 Network 中模型请求的 Request URL 粘贴到弹窗。它不依赖 Three.js,可先判断浏览器能否读取原始资源。
(async () => {
  const url = window.prompt('粘贴模型的 Request URL');
  if (!url) return;

  try {
    // 保留浏览器的跨域检查,不用 no-cors 掩盖错误。
    const response = await fetch(url, { mode: 'cors' });
    console.log(`HTTP ${response.status}, ok=${response.ok}`);
    console.log(`Content-Type: ${response.headers.get('content-type')}`);
  } catch (error) {
    console.log(`请求失败:${error.name}`);
  }
})();
预期输出示例(URL 存在、可读取且服务器标注了 GLB 类型):
HTTP 200, ok=true
Content-Type: model/gltf-binary
实际 MIME 也可能是 application/octet-stream;若返回 text/html,应检查是否取到了网页而非模型。404 对应 ok=false;跨域、DNS 或 TLS 失败都可能进入 TypeError 分支,不能仅凭异常名判定 CORS,必须结合 Console 的具体提示。
修正 Vite 发布前缀与资源引用
假设 Vite 应用部署到网站的 /viewer/ 子路径,而模型放在项目的 public/models/robot.glb。Vite 构建后应生成 dist/models/robot.glb,线上访问路径则应是 /viewer/models/robot.glb,不能继续硬编码 /models/robot.glb。路径规则见 Vite 官方文档。
项目根目录的 vite.config.js 可设置为:
import { defineConfig } from 'vite';

export default defineConfig({
  base: '/viewer/'
});
配置生效后,Vite 会把构建资源的公共前缀设为 /viewer/。对代码中手工拼接的模型 URL,还需要使用 import.meta.env.BASE_URL。以下为片段示例,需置于安装了 three 的 Vite 应用模块中,并传入已创建的 scene:
import { GLTFLoader } from 'three/addons/loaders/GLTFLoader.js';

export async function loadRobot(scene) {
  // BASE_URL 在构建时替换为实际部署前缀。
  const url = `${import.meta.env.BASE_URL}models/robot.glb`;
  const gltf = await new GLTFLoader().loadAsync(url);
  scene.add(gltf.scene);
}
预期生效行为:调用 loadRobot(scene) 后,请求目标为 /viewer/models/robot.glb,解析成功后角色节点加入场景。若使用 .gltf 而非独立 .glb,还需核对其相对引用的 .bin、图片文件是否一同发布,文件名大小写是否严格一致;Draco、KTX2 解码依赖的独立资源也应检查。
在资源服务器修复 CORS
只有页面与模型文件的协议、主机名或端口不同才涉及跨源读取限制。以页面源 https://app.example.com、模型放在另一资源域名为例,模型服务器应在实际 GET 响应中返回 Access-Control-Allow-Origin: https://app.example.com,这属于响应头,不能靠前端增加同名请求头解决。
若静态文件由 Nginx 提供,可参考以下片段示例;放入资源站点的 server 配置中,按真实目录和页面源调整:
location /models/ {
    root /srv/static;
    add_header Access-Control-Allow-Origin "https://app.example.com" always;
}
该示例把 /models/robot.glb 映射到 /srv/static/models/robot.glb。应用配置后先执行 nginx -t 验证语法,再按部署流程重载服务。公开且不携带凭据的资源可以使用 *;若请求携带 Cookie 等凭据,则必须返回明确的允许源及 Access-Control-Allow-Credentials: true,不能使用 *。只有触发预检时,才需进一步检查 OPTIONS 响应允许的方法和请求头;具体规则可查阅 MDN CORS 文档。
重新构建并做线上验收
- 在项目根目录执行
npm run build,预期构建成功且dist/models/robot.glb存在;把dist中的内容部署到网站的/viewer/对应目录。若模型来自独立资源服务器,则确认其部署目录而非只检查前端dist。 - 用正式域名访问页面,在 Network 禁用缓存后刷新,确认 GLB 与引用的
.bin、纹理等都获得有效响应,Request URL 指向正确域名与路径,Response不是回退 HTML。 - 对跨域资源,确认 GET 响应的
Access-Control-Allow-Origin与页面源匹配,Console 不再出现 CORS 错误,Three.js 场景中能看到模型。 - 如更新后仍请求旧 URL,检查 CDN 缓存和已部署的 JS 包版本;不要把允许静态资源的 404 错误交给 SPA 回退页面来伪装成 200。
若 Network 全部正常而模型仍不可见,下一步应检查解析错误、解码器及场景相机位置,而不是继续修改 CORS 响应头。