
Web 图形与 3D / 系统课时
对比传输解码与渲染性能
对比传输解码与渲染性能
GLB 压缩后文件可能从 12 MB 缩至 4 MB,但几何解码、纹理处理或首次 GPU 上传反而让模型更晚出现。本课使用 Chrome DevTools 与 Three.js 的 renderer.info,分开记录请求读取、解析解码、首次渲染提交和稳定帧耗时,做出有证据的取舍。
学习目标
- 区分传输时间、解析解码时间、首次渲染提交时间与实际显示时间。
- 用可重复的测试记录帧间隔 P95、绘制调用、三角形数和资源计数。
- 根据优化前后数据定位“文件变小却更慢”的原因。
固定对照实验条件
准备内容相同、姿态和材质效果可比的 before.glb 与 after.glb,放在同一站点的 public/models/ 中;最好都是自包含 GLB。保持同一 Chrome 版本、设备、电源模式、相机、画布尺寸 800×450 和像素比 1,分别测量冷启动与缓存命中,不能混在一张表里。
- 在 Chrome DevTools 的 Network 勾选 Disable cache,设 Throttling → No throttling,打开请求详情的 Timing,记录 Content Download 和传输大小;具体字段可查 Network 参考说明。
- 在 Performance 使用录制页面加载的功能,观察 Main 线程任务、Frames 和截图时间线;为排查移动设备问题,再单独使用相同的 CPU 与网络限速配置。
- 每个版本新开页面至少测量 5 次,取中位数;排除浏览器后台标签页、首次编译依赖与不同缓存状态造成的偏差。
分段记录加载与首帧
为分清测量边界,将自包含 GLB 的请求读取和 GLTFLoader.parseAsync() 分开计时;首次调用 renderer.render() 后读取 renderer.info,随后采集 120 个稳定阶段的 requestAnimationFrame 间隔。此分段方法不会把浏览器网络等待误算成模型解码。
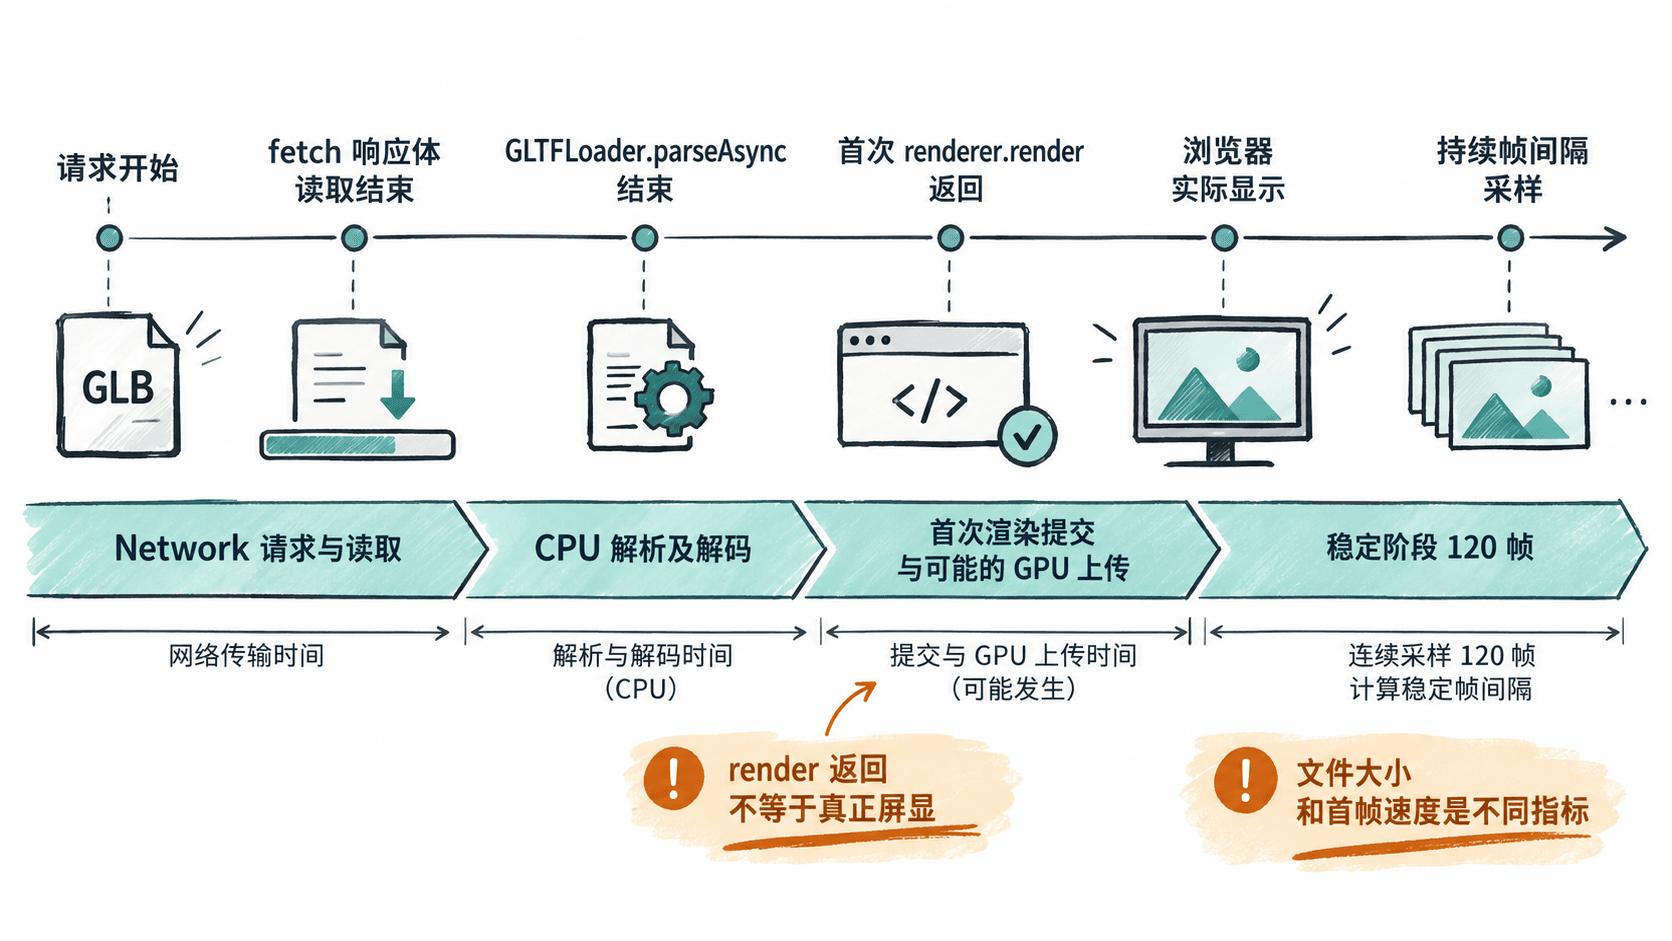
以下以 Vite 的 JavaScript 模板为例,要求 Node.js 20.19+ 或 22.12+,并准备自己的两份 GLB。先执行命令,再把文件分别放入 public/models/before.glb 和 public/models/after.glb:
npm create vite@latest glb-bench -- --template vanilla
cd glb-bench
npm install
npm install three
npm run dev
预期结果:Vite 启动本地开发服务器;实际版本、耗时及端口可能不同。
VITE v<VERSION> ready in <TIME> ms
Local: http://localhost:<PORT>/
用下面代码完整替换 src/main.js,访问 /?asset=before 与 /?asset=after,分别查看开发者工具 Console:
import * as THREE from 'three';
import { GLTFLoader } from 'three/addons/loaders/GLTFLoader.js';

const asset = new URLSearchParams(location.search).get('asset') === 'after' ? 'after' : 'before';
const url = `/models/${asset}.glb`;
const renderer = new THREE.WebGLRenderer({ antialias: false });
renderer.setPixelRatio(1);
renderer.setSize(800, 450);
document.querySelector('#app').replaceChildren(renderer.domElement);

const scene = new THREE.Scene();
scene.background = new THREE.Color(0xeeeeee);
scene.add(new THREE.HemisphereLight(0xffffff, 0x555555, 2));
const camera = new THREE.PerspectiveCamera(45, 800 / 450, 0.01, 1000);
const loader = new GLTFLoader();

// 仅对自包含 GLB 分段:fetch 负责网络请求及响应体读取。
const t0 = performance.now();
const response = await fetch(url, { cache: 'no-store' });
if (!response.ok) throw new Error(`${response.status}: ${url}`);
const buffer = await response.arrayBuffer();
const tFetch = performance.now();
const gltf = await loader.parseAsync(buffer, '/models/');
const tParse = performance.now();
scene.add(gltf.scene);

const sphere = new THREE.Box3().setFromObject(gltf.scene).getBoundingSphere(new THREE.Sphere());
const r = Math.max(sphere.radius, 0.1);
camera.position.copy(sphere.center).add(new THREE.Vector3(r, r, r * 3));
camera.near = Math.max(r / 100, 0.01);
camera.far = r * 100;
camera.lookAt(sphere.center);
camera.updateProjectionMatrix();

// 单帧计数显式清零;render 返回只代表提交调用完成。
renderer.info.autoReset = false;
renderer.info.reset();
renderer.render(scene, camera);
const tSubmit = performance.now();
const { calls, triangles } = renderer.info.render;
const { geometries, textures } = renderer.info.memory;

const mixer = gltf.animations.length ? new THREE.AnimationMixer(gltf.scene) : null;
if (mixer) mixer.clipAction(gltf.animations[0]).play();
const intervals = [];
let previous = null;
for (let i = 0; i < 151; i++) {
  const now = await new Promise(requestAnimationFrame);
  if (i >= 31) intervals.push(now - previous); // 跳过前 30 次热身
  mixer?.update(previous === null ? 0 : (now - previous) / 1000);
  previous = now;
  renderer.info.reset();
  renderer.render(scene, camera);
}
intervals.sort((a, b) => a - b);
const p95 = intervals[Math.ceil(intervals.length * 0.95) - 1].toFixed(1);

console.log(`资源=${asset} 请求及读取=${Math.round(tFetch - t0)}ms 解析解码=${Math.round(tParse - tFetch)}ms 首次提交=${Math.round(tSubmit - t0)}ms`);
console.log(`calls=${calls} triangles=${triangles} geometries=${geometries} textures=${textures}`);
console.log(`rAF P95=${p95}ms`);
预期输出:占位符表示依资产与机器变化的实际数值;切换 asset=after 后首行资源名称变为 after。
资源=before 请求及读取=<TIME>ms 解析解码=<TIME>ms 首次提交=<TIME>ms
calls=<N> triangles=<N> geometries=<N> textures=<N>
rAF P95=<TIME>ms
请求及读取 含连接等待与读取,并非纯下载时间;解析解码 含 GLB 解析、可用资源处理和异步等待,不等于纯 CPU 指令耗时。rAF P95 是帧回调间隔第 95 百分位,受显示器刷新率、调度和 GPU 阻塞影响,不能当成精确 GPU 时间。renderer.info 的 memory 字段记录几何和纹理对象数量,不是显存字节数。
对照 DevTools 追查瓶颈
- Network:点击
.glb请求,比较 Size、Time、Timing → Content Download。不要将12 MB → 4 MB直接解释为解码或显存也减少了三分之二。 - Performance:在两版本分别录制首次加载,查看 Main 的长任务、Bottom-up 耗时函数及可能的 Worker 线程,寻找 Draco 解码、纹理处理或主线程任务;再观察 Frames 中掉帧与最早显示模型的截图。渲染提交后如出现卡顿,进一步排查着色器编译或纹理上传。
- Three.js:比较相同相机视角的
calls、triangles、geometries、textures。calls不降意味着压缩通常没有减少绘制批次;三角形数不降意味着没有通过减面降低几何负担。
从数据决定是否采用压缩
下面是用于演练判断的假设数据,不是浏览器实测。两列均指相同设备、冷缓存、相机及像素比下的中位数:
| 指标 | 原始版 | 压缩版 |
|---|---|---|
| GLB 文件大小 | 12.0 MB | 4.0 MB |
| Network Content Download | 620 ms | 210 ms |
| 解析解码段 | 180 ms | 980 ms |
| 首次渲染提交 | 950 ms | 1400 ms |
| 稳定阶段 rAF P95 | 19.0 ms | 19.1 ms |
| Draw calls | 84 | 84 |
| 每帧三角形数 | 180000 | 180000 |
文件缩小 66.7%,下载少 410 ms,但解析解码多 800 ms,首次提交晚 450 ms,绘制数量也未改善。若当前目标是首次进入场景速度,这一方案应暂缓采用:可以尝试减面、移除无用纹理、选择解码代价较小的压缩参数,之后重新测试;慢网环境另测,不用快网结论替代。
验收时分别规定指标,例如冷启动首次可见模型的中位数不增加超过 100 ms、稳定帧间隔 P95 不高于目标设备的帧预算(60 Hz 可先以 16.7 ms 作参考)、画面与动画无明显退化。达不到门槛就保留原版或调整压缩策略;真正的首次可见时间以录屏帧时间线核对,不把 JS 的 首次提交 伪装成屏幕呈现时刻。