
Linux 与服务器运维 / 系统课时
模拟崩溃验证自动恢复能力
模拟崩溃验证自动恢复能力
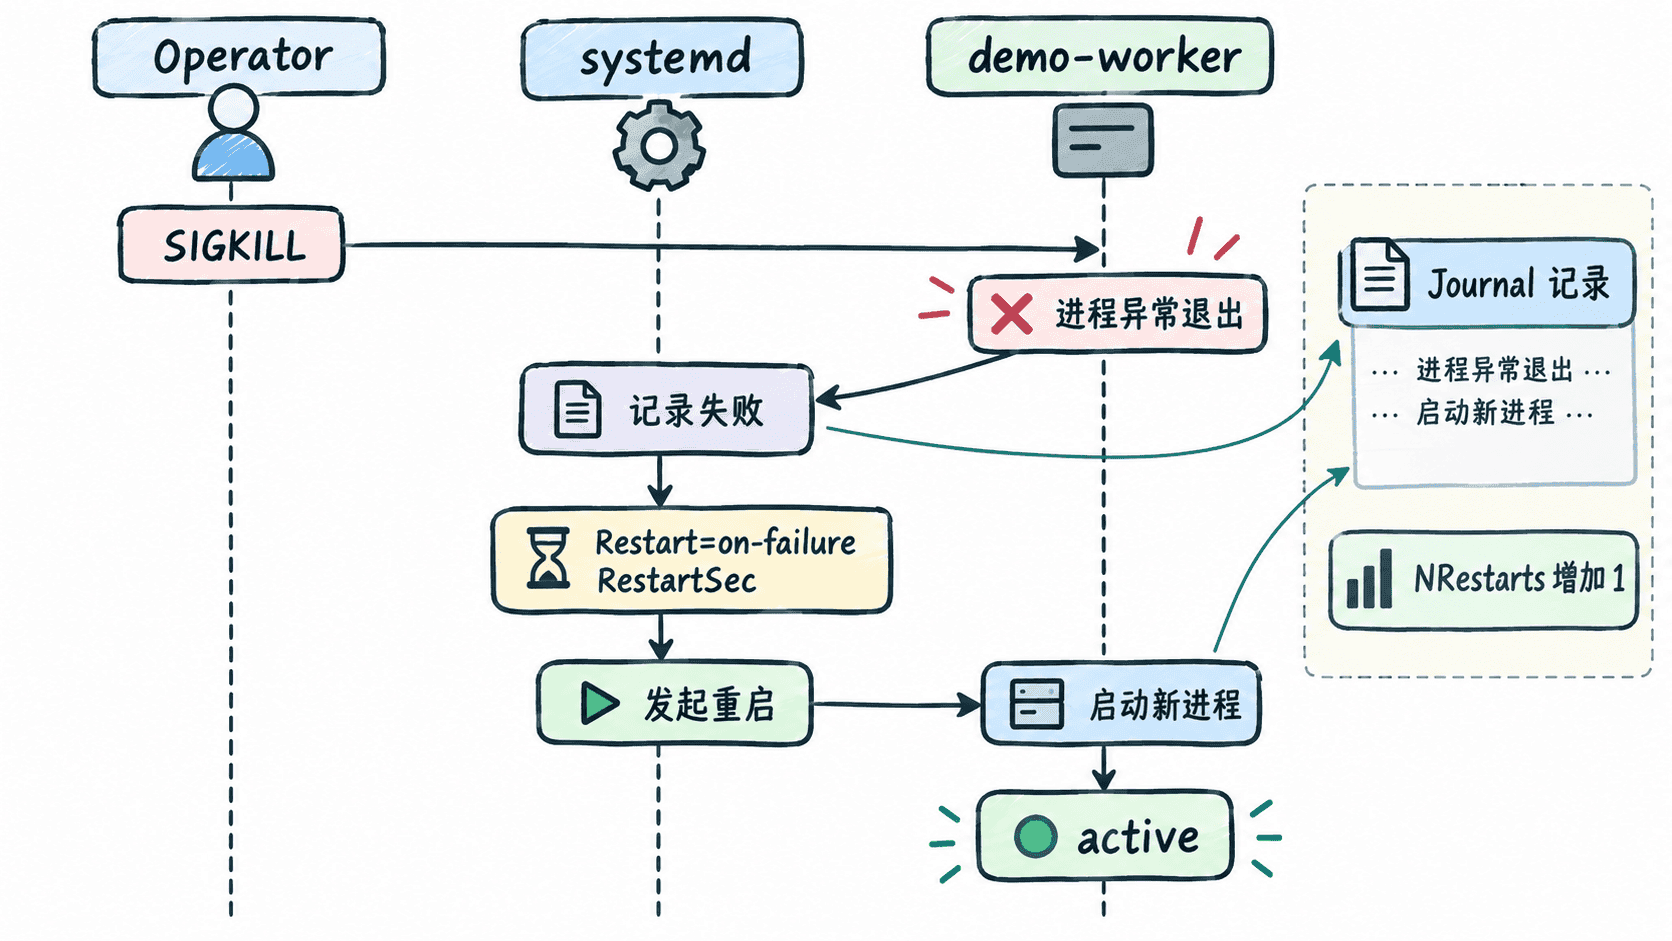
自动恢复不能只看配置文件里的 Restart=,必须让进程真实异常退出,再观察 systemd 是否记录失败、执行重启并恢复服务。本节用 SIGKILL 模拟崩溃,验证重启策略、重启次数和 Journal 证据是否一致。
学习目标
- 为服务配置可验证的自动重启策略。
- 主动制造异常退出并观察 systemd 的恢复过程。
- 结合
NRestarts、运行状态和 Journal 判断恢复是否符合预期。
准备可验证的重启策略
以下示例继续使用 demo-worker.service。通过 drop-in 覆盖文件设置 Restart=on-failure,并把重启等待时间设为 2 秒,便于观察。
SERVICE=demo-worker.service
sudo mkdir -p "/etc/systemd/system/${SERVICE}.d"
printf '[Service]\nRestart=on-failure\nRestartSec=2s\n' | sudo tee "/etc/systemd/system/${SERVICE}.d/restart.conf" >/dev/null
sudo systemctl daemon-reload
sudo systemctl restart "$SERVICE"
systemctl show "$SERVICE" -p Restart -p RestartUSec
预期输出:
Restart=on-failure
RestartUSec=2s
这里选择 on-failure,是为了让非零退出、异常信号等故障触发恢复,而正常停止不会被立即拉起。若业务要求服务无论因何退出都恢复,再评估是否使用 Restart=always。
制造一次异常退出
先记录当前自动重启次数,然后让 systemd 向服务主进程发送 SIGKILL。不要直接杀死不属于该服务的进程。
SERVICE=demo-worker.service
systemctl show "$SERVICE" -p NRestarts
sudo systemctl kill --kill-whom=main --signal=SIGKILL "$SERVICE"
sleep 3
systemctl show "$SERVICE" -p ActiveState -p SubState -p NRestarts
预期输出形态:
NRestarts=<COUNT_BEFORE>
ActiveState=active
SubState=running
NRestarts=<COUNT_AFTER>正常情况下,<COUNT_AFTER> 应比 <COUNT_BEFORE> 大 1。若最终仍为 active/running,说明 systemd 已在进程异常退出后创建了新的服务进程。
从 Journal 核对失败与重启动作
状态只告诉你“现在怎样”,Journal 才能证明“刚才发生过什么”。查询最近日志,重点寻找异常终止、计划重启以及重新启动成功的记录。
SERVICE=demo-worker.service
journalctl -u "$SERVICE" -n 30 --no-pager
预期输出形态:
<TIME> <HOST> systemd[1]: demo-worker.service: Main process exited, code=killed, status=9/KILL
<TIME> <HOST> systemd[1]: demo-worker.service: Scheduled restart job, restart counter is <COUNT_AFTER>.
<TIME> <HOST> systemd[1]: Started demo-worker.service.
不同 systemd 版本的措辞可能略有差异,但应能看到三类证据:旧进程异常退出、自动重启被安排、新进程再次启动。<TIME>、<HOST> 和计数值属于动态信息。
处理没有自动恢复的情况
如果 3 秒后服务没有回到 active,先查看失败原因和实际加载的重启配置。
SERVICE=demo-worker.service
systemctl status "$SERVICE" --no-pager
systemctl show "$SERVICE" -p Restart -p RestartUSec -p ActiveState -p SubState -p Result
journalctl -u "$SERVICE" -n 50 --no-pager
预期结果:
应能同时看到当前状态、实际生效的 Restart 策略,以及最近一次失败或重启相关日志。常见原因包括 drop-in 未被加载、程序启动后立即再次崩溃,或短时间连续失败触发 systemd 的启动速率限制。验证自动恢复时不要只确认“服务最后是 active”,还要让重启次数和 Journal 中的失败、调度重启、重新启动三段证据能够互相对应。