
Linux 与服务器运维 / 系统课时
服务启动失败先看哪三处
服务启动失败先看哪三处
服务启动失败时,先不要连续重启或盲目改配置。最快的定位顺序是拿到三类证据:systemctl status 看当前失败摘要,journalctl 看完整时间线,systemctl cat 看 systemd 实际加载的 Unit 内容,再把错误信息与配置逐项对应。
学习目标
- 用三条核心命令快速缩小启动失败范围。
- 区分当前状态摘要、历史日志和实际生效配置各自解决的问题。
- 根据三处证据定位常见的
ExecStart、权限和依赖配置错误。
三处证据分别回答什么
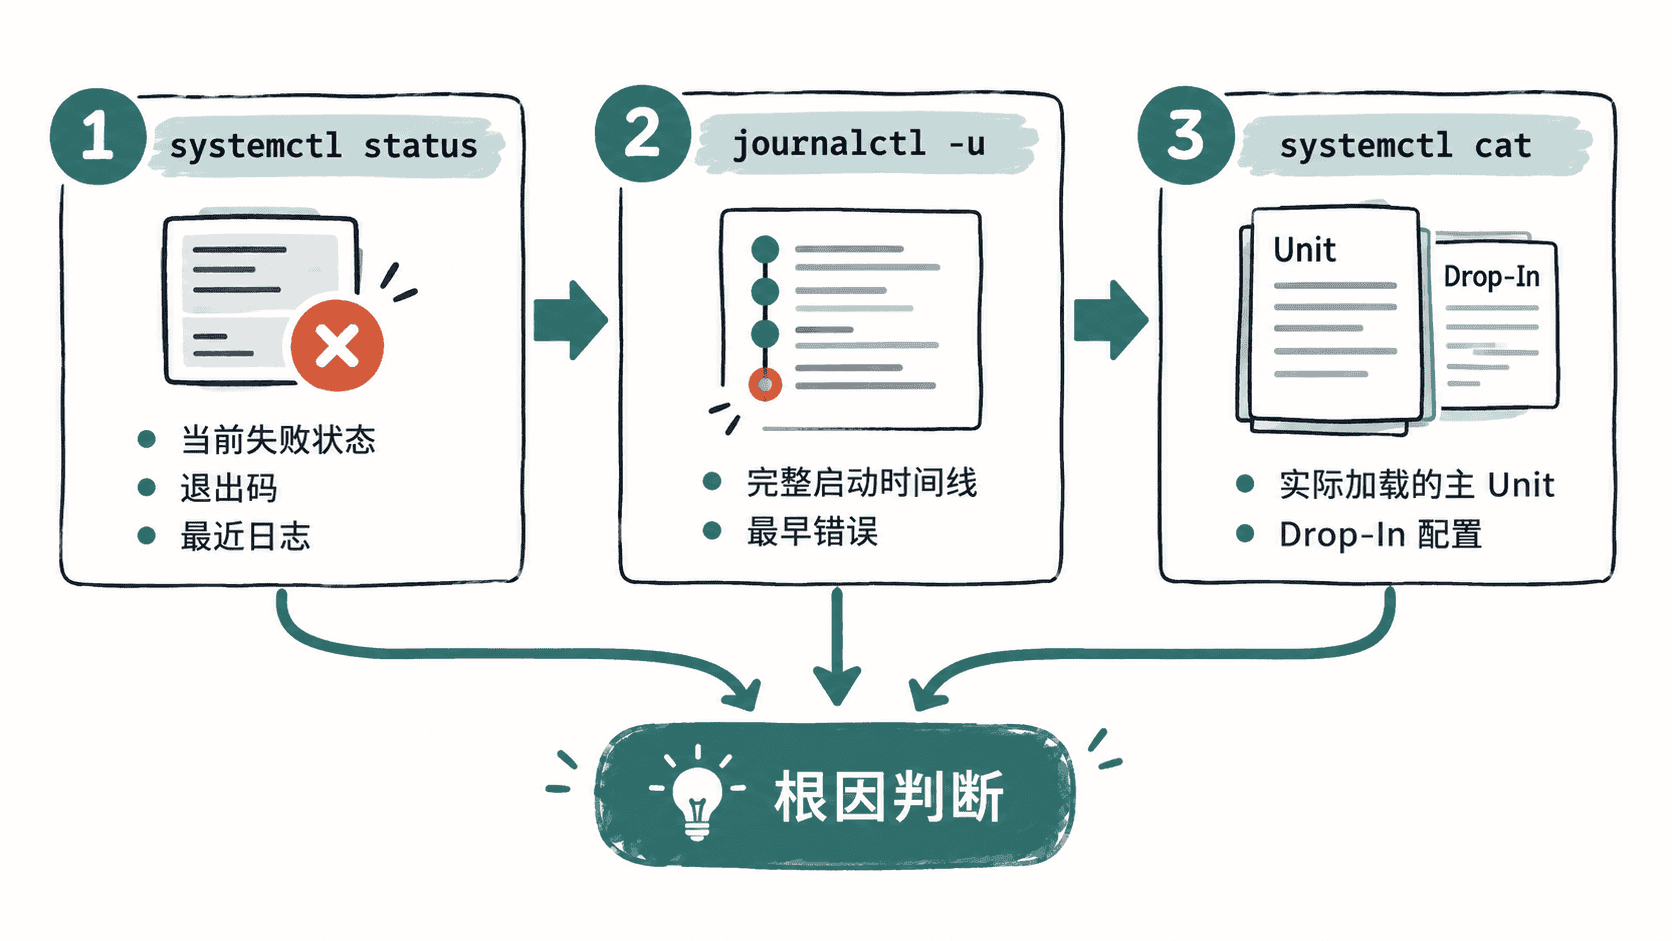
systemctl status <UNIT> 适合第一眼判断服务是 failed、inactive 还是仍在反复重启,并查看主进程退出原因和少量最近日志。它提供的是摘要,不应替代完整日志。
journalctl -u <UNIT> 负责补齐时间线。启动失败时,真正有价值的第一条错误经常出现在后续连锁报错之前,因此应优先关注权限、路径、配置解析或依赖异常。
systemctl cat <UNIT> 展示 systemd 当前读取到的主 Unit 和 Drop-In。它能避免你修改了一个文件,而服务实际又被另一个覆盖文件改变配置的误判。
用一个失败 Unit 练习定位
下面创建一个故意写错 ExecStart 路径的演示服务,然后依次查看三处证据。需要在使用 systemd 的 Linux 主机上执行,并具备 sudo 权限。
UNIT=anystack-start-fail-demo.service

sudo tee /etc/systemd/system/$UNIT >/dev/null <<'EOF'
[Unit]
Description=Anystack startup failure demo

[Service]
Type=oneshot
ExecStart=/opt/anystack/bin/not-found
EOF

sudo systemctl daemon-reload
sudo systemctl start $UNIT || true

systemctl status $UNIT --no-pager || true
journalctl -u $UNIT -b --no-pager -n 20
systemctl cat $UNIT

sudo systemctl reset-failed $UNIT
sudo rm /etc/systemd/system/$UNIT
sudo systemctl daemon-reload
预期结果
systemctl status:服务处于 failed,启动阶段发生执行错误。
journalctl:同一次启动记录会指向 ExecStart 对应程序无法执行或不存在。
systemctl cat:可以直接看到 ExecStart=/opt/anystack/bin/not-found。
日志中的时间戳、PID 和具体措辞会因 systemd 版本而不同,但三处证据应指向同一个事实:Unit 要启动的程序路径不存在。此时继续重启没有意义,应先修正路径。
按顺序缩小根因
实际排查时可以固定使用这个顺序:
- 先看
systemctl status <UNIT>,记录Active、Result、主进程退出信息,以及最后几行日志。 - 再看
journalctl -u <UNIT> -b,从本次启动记录中向前找第一条异常,而不是只盯着最后一条启动失败提示。 - 最后用
systemctl cat <UNIT>对照ExecStart、User、EnvironmentFile、依赖关系和所有 Drop-In,确认错误信息对应的配置究竟来自哪里。 - 修正 Unit 或外部文件后执行
systemctl daemon-reload,再启动或重启服务并重新检查状态。
三处都看过仍找不到时
当状态、日志和 Unit 内容都没有直接给出答案,再扩大范围检查可执行文件权限、工作目录、环境文件、挂载点、网络依赖,以及 Requires=、After= 等相关单元。此时仍应以日志中的最早失败证据为起点,而不是随机修改参数。
这三处信息之所以要一起看,是因为它们分别覆盖现在发生了什么、失败过程是什么、systemd 实际按什么配置执行。把三者对齐后,大多数启动失败都能先归类,再进入针对性的修复。