
Linux 与服务器运维 / 系统课时
配置异常退出后的自动恢复
配置异常退出后的自动恢复
后台进程偶发崩溃时,systemd 可以自动拉起服务;但如果程序持续报错,毫秒级反复重启会放大日志、CPU 和下游压力。本节把“失败后重启”和“重启频率上限”一起配置,让恢复机制既自动又有刹车。
学习目标
- 使用
Restart=和RestartSec=控制异常退出后的自动拉起 - 使用
StartLimitIntervalSec=与StartLimitBurst=阻止持续故障导致高频重启 - 通过
systemctl status、journalctl和reset-failed验证并恢复被限流的服务
先定义什么算“需要重启”
Restart=on-failure 适合大多数长期运行的后台服务:进程以非零状态码退出、被异常信号终止、超时或 watchdog 失败时,systemd 会尝试重启;正常退出以及管理员执行 systemctl stop 时不会因为该策略自动拉起。
如果使用 Restart=always,即使进程正常退出也会再次启动,更适合“主进程原则上不应自行结束”的守护程序。对普通业务服务,先从 on-failure 开始通常更容易区分正常停止和真实故障。
配置重启间隔与启动限流
下面是一份完整 unit。把 <PATH> 替换为实际可执行文件的绝对路径,再保存为 /etc/systemd/system/demo-worker.service。
[Unit]
Description=Demo background worker
After=network.target
StartLimitIntervalSec=60s
StartLimitBurst=3

[Service]
Type=simple
ExecStart=<PATH>
Restart=on-failure
RestartSec=5s

[Install]
WantedBy=multi-user.target
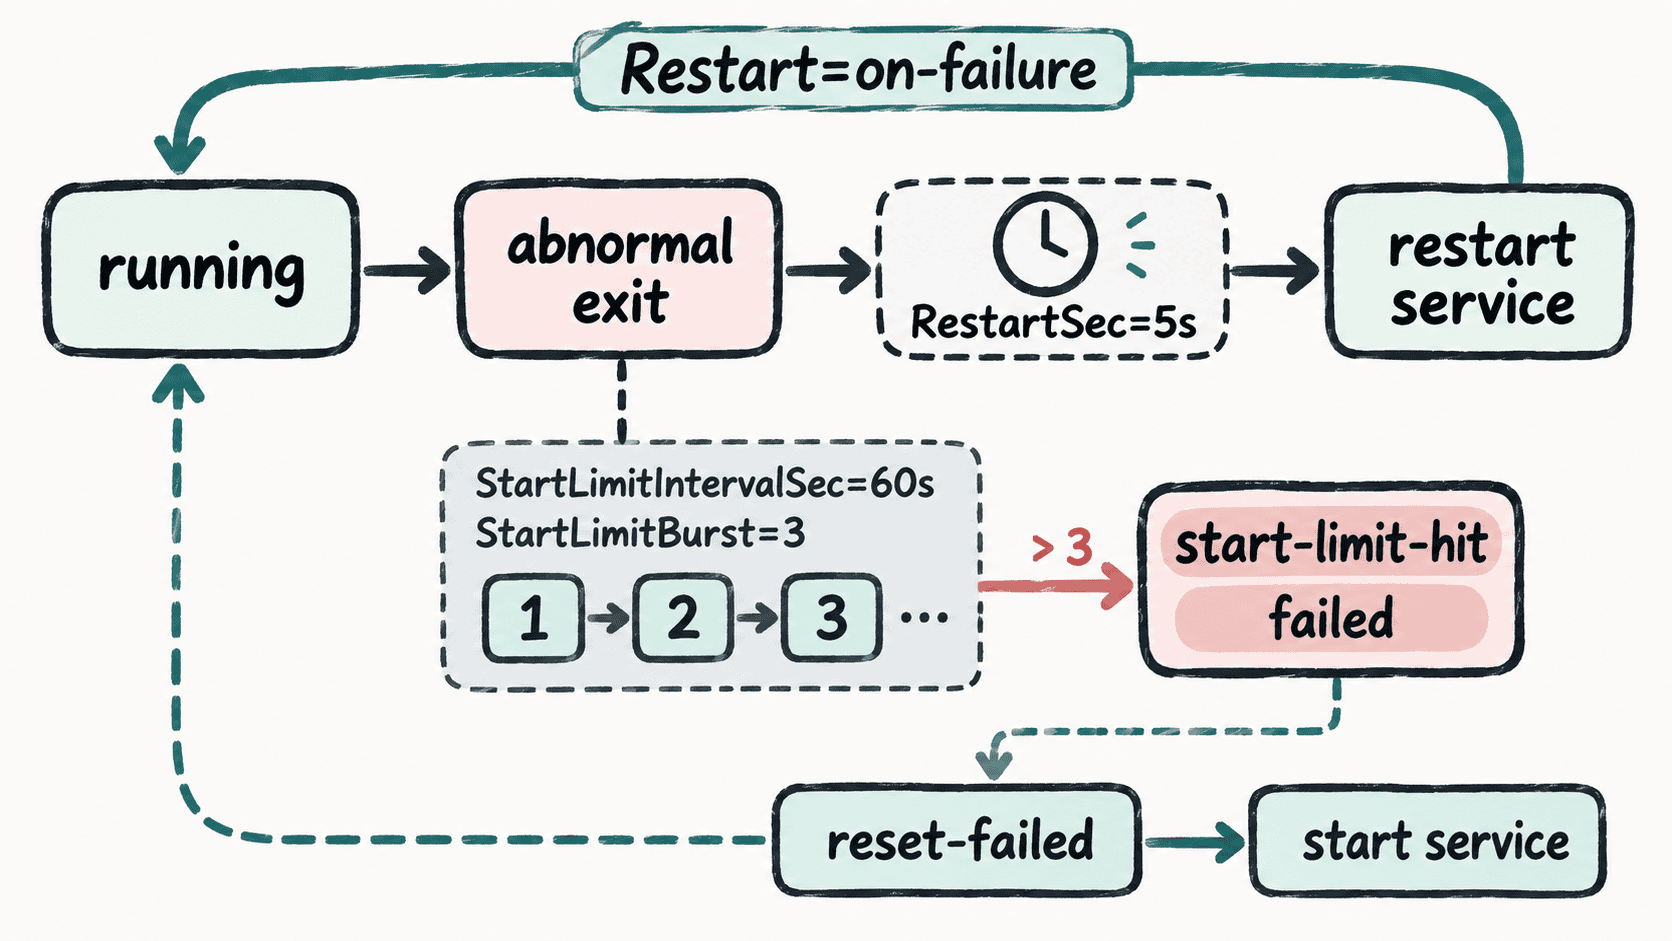
RestartSec=5s 表示失败后等待 5 秒再尝试启动,避免瞬时故障形成紧密循环。StartLimitBurst=3 与 StartLimitIntervalSec=60s 组合后,同一 60 秒窗口最多允许 3 次启动;如果服务每次启动后都立即失败,随后处于同一窗口内的启动请求会被限流拒绝。
重新加载并验证配置
修改 unit 后先做语法校验,再让 systemd 重新读取配置并启动服务。
sudo systemd-analyze verify /etc/systemd/system/demo-worker.service
sudo systemctl daemon-reload
sudo systemctl restart demo-worker.service
systemctl is-active demo-worker.service
预期输出
activesystemd-analyze verify、daemon-reload 和成功的 restart 通常不会输出正文;最后一条命令应打印 active。如果实际程序 <PATH> 启动失败,则这里可能返回 failed 或 activating,应继续查看状态和日志,而不是反复手工重启。
观察失败与解除限流
先看服务状态,再读取本次系统启动以来该 unit 的近期日志。
systemctl status demo-worker.service --no-pager
journalctl -u demo-worker.service -b --no-pager -n 50
预期结果
状态中可见 Active、Result 等信息;日志中可看到应用退出原因以及 systemd 的重启尝试。持续失败并触发限流时,服务通常进入 failed,日志会出现启动请求过于频繁等限流信息。实际时间、PID 和具体文本可能不同。根因修复后,如果服务仍保留失败状态或启动限流计数,可以重置状态并重新启动。
sudo systemctl reset-failed demo-worker.service
sudo systemctl start demo-worker.service
systemctl is-active demo-worker.service
预期输出
activereset-failed 不是修复应用故障的手段,它只清除 systemd 记录的失败状态以及该 unit 的启动限流计数。正确顺序是先修复程序、配置或依赖问题,再重置计数并确认服务能够持续稳定运行。